
 我要评论
引言
在sql server性能问题中,阻塞与死锁是最让dba头疼的场景之一。当用户抱怨"系统卡住了"、"查询一直在转圈"时,80%的情况下都与阻塞有关。与cpu、内存、i/o等资源瓶颈不同,阻塞问题的特征是:查询耗时长,但资源消耗低——因为被阻塞的会话在等待时不消耗cpu、内存或i/o资源。
本文将系统介绍sql server阻塞与锁的诊断方法,涵盖:
- 阻塞的本质与等待类型分析
- 锁定粒度与锁升级机制
- 长时间阻塞的识别与监控
- 实战dmv查询脚本
- 优化建议与最佳实践
本文所有脚本均在sql server 2016/2019/2022环境下测试通过,但在生产环境使用前请先在测试环境验证。
一、阻塞基础:理解锁与等待
1.1 什么是阻塞?
阻塞主要是对逻辑锁的等待,例如等待获取资源上的排他锁(x锁),或由较低级别同步原语(如闩锁)导致的等待。当请求获取已被锁定资源上的不兼容锁时,就会发生逻辑锁等待。
阻塞的特征:
- 查询耗时长(用户感知慢)
- 资源消耗低(cpu/内存/i/o都很低)
- 本质:等待其他会话释放锁
阻塞 vs 死锁:
- 阻塞:会话a等待会话b释放锁,最终会话b完成后,会话a可以继续执行
- 死锁:会话a等待会话b,会话b也等待会话a,形成循环等待,sql server会选择一个会话作为"死锁牺牲品"终止
1.2 sql server的等待机制
sql server会话在系统资源(或锁)当前不可用时被置于等待状态。sql server提供了详细的等待信息,报告约数百种等待类型。
核心dmv:
sys.dm_os_wait_stats:整体和累积等待统计sys.dm_os_waiting_tasks:当前等待的会话(按会话细分)sys.dm_tran_locks:锁状态(已授予/等待中)sys.dm_exec_requests:被阻塞的请求
二、实战诊断:使用dmv定位阻塞
2.1 查找阻塞链
脚本1:使用sys.dm_os_waiting_tasks查找阻塞链
-- 查找当前所有被阻塞的会话
select
    waiting_task_address,
    session_id as blocked_session,
    exec_context_id,
    wait_duration_ms,
    wait_type,
    resource_address,
    blocking_task_address,
    blocking_session_id as blocking_session,
    blocking_exec_context_id,
    resource_description
from sys.dm_os_waiting_tasks
where blocking_session_id is not null
order by wait_duration_ms desc;
示例输出解读:
blocked_session: 56
blocking_session: 53
wait_type: lck_m_s (等待共享锁)
wait_duration_ms: 1103500 (约18分钟)
结论: 会话56被会话53阻塞,等待共享锁,已等待18分钟。
2.2 分析锁状态
脚本2:使用sys.dm_tran_locks分析锁状态
-- 查看指定数据库的所有锁
select
    request_session_id as spid,
    resource_type as lock_type,
    resource_database_id as db_id,
    case resource_type
        when 'object' then object_name(resource_associated_entity_id, resource_database_id)
        when 'database' then ' '
        else (select object_name(object_id, resource_database_id)
              from sys.partitions
              where hobt_id = resource_associated_entity_id)
    end as object_name,
    resource_description as resource_desc,
    request_mode as lock_mode,
    request_status as lock_status
from sys.dm_tran_locks
where resource_database_id = db_id('yourdatabasename')
order by request_session_id, resource_type;
关键列解读:
request_status:- grant = 锁已授予
- wait = 等待中(被阻塞)
request_mode:锁模式- s = 共享锁(select)
- x = 排他锁(insert/update/delete)
- ix = 意向排他锁
- is = 意向共享锁
- u = 更新锁
resource_type:资源类型- database = 数据库级锁
- object = 对象级锁(表、索引)
- page = 页级锁
- key = 行级锁(索引键)
- rid = 行级锁(堆表行id)
2.3 查看被阻塞的请求及sql文本
脚本3:查看被阻塞请求的完整信息
-- 查看所有被阻塞的请求及其sql文本
select
    r.session_id as blocked_spid,
    r.blocking_session_id as blocking_spid,
    r.wait_type,
    r.wait_time / 1000.0 as wait_time_sec,
    r.wait_resource,
    r.command,
    db_name(r.database_id) as database_name,
    r.cpu_time,
    r.logical_reads,
    r.total_elapsed_time / 1000.0 as elapsed_time_sec,
    substring(st.text, (r.statement_start_offset/2)+1,
        ((case r.statement_end_offset
            when -1 then datalength(st.text)
            else r.statement_end_offset
        end - r.statement_start_offset)/2) + 1) as blocked_sql_text
from sys.dm_exec_requests r
cross apply sys.dm_exec_sql_text(r.sql_handle) st
where r.blocking_session_id > 0
order by r.wait_time desc;
使用场景:
- 用户报告"系统卡住"时,立即运行此脚本
- 定位哪些sql正在被阻塞
- 找出阻塞源头(blocking_spid)
2.4 综合阻塞诊断脚本
脚本4:阻塞链完整视图(推荐)
-- 综合诊断:显示阻塞链、sql文本、锁信息
with blockingchain as (
    select
        r.session_id,
        r.blocking_session_id,
        r.wait_type,
        r.wait_time / 1000.0 as wait_sec,
        r.wait_resource,
        db_name(r.database_id) as db_name,
        substring(st.text, (r.statement_start_offset/2)+1,
            ((case r.statement_end_offset
                when -1 then datalength(st.text)
                else r.statement_end_offset
            end - r.statement_start_offset)/2) + 1) as sql_text,
        s.login_name,
        s.host_name,
        s.program_name,
        r.status,
        r.cpu_time,
        r.logical_reads
    from sys.dm_exec_requests r
    inner join sys.dm_exec_sessions s on r.session_id = s.session_id
    cross apply sys.dm_exec_sql_text(r.sql_handle) st
    where r.session_id <> @@spid
)
select
    bc.session_id as [被阻塞会话],
    bc.blocking_session_id as [阻塞源会话],
    bc.wait_sec as [等待秒数],
    bc.wait_type as [等待类型],
    bc.wait_resource as [等待资源],
    bc.db_name as [数据库],
    bc.sql_text as [被阻塞sql],
    blocker.sql_text as [阻塞者sql],
    bc.login_name as [被阻塞登录],
    blocker.login_name as [阻塞者登录],
    bc.host_name as [被阻塞主机],
    bc.program_name as [被阻塞程序]
from blockingchain bc
left join blockingchain blocker on bc.blocking_session_id = blocker.session_id
where bc.blocking_session_id > 0
order by bc.wait_sec desc;
此脚本的价值:
- 一次查询即可看到完整阻塞链
- 同时显示被阻塞者和阻塞者的sql
- 包含登录名、主机名、程序名(便于追溯应用)
三、锁定粒度与锁升级
3.1 事务隔离级别与锁持续时间
理解阻塞的关键之一是事务隔离级别和锁定粒度。
事务隔离级别对锁的影响:
- 事务隔离级别控制**共享锁(s锁)**的持续时间
- 但**不影响排他锁(x锁)**的持续时间
- 排他锁在所有隔离级别下都会持有到事务结束
四种隔离级别:
read uncommitted(未提交读)
- 不加共享锁(脏读)
- 最低隔离级别,最高并发
read committed(已提交读,默认)
- 读取时加共享锁
- 读取完成后立即释放(不持有到事务结束)
repeatable read(可重复读)
- 读取时加共享锁
- 持有到事务结束(保证可重复读)
serializable(可序列化)
- 读取时加范围锁
- 持有到事务结束(防止幻读)
3.2 锁定粒度:行级 vs 页级 vs 表级
锁定粒度的权衡:
- 行级锁:并发性高,但锁管理开销大
- 页级锁:折中方案
- 表级锁:并发性低,但锁管理开销小
sql server会根据情况自动升级锁,从行级锁→页级锁→表级锁。
3.3 锁升级触发条件
锁升级会在以下情况触发:
锁数量阈值:
- 单个语句在索引或堆上持有的锁数(包括意向锁)超过约5,000个
锁内存阈值:
- 锁资源占用的内存超过非awe启用内存的40%
注意事项:
- 以下情况不会触发锁升级:
- 事务在单个语句中在两个索引或堆上各获取2,500个锁(未达到单个对象5,000锁阈值)
- 事务在非聚集索引和对应基表上各获取2,500个锁(分别计算)
3.4 控制锁升级
sql server 2008+提供了表级锁升级控制(推荐):
-- 禁用表的锁升级
alter table tablename set (lock_escalation = disable);

-- 启用分区级锁升级(仅升级到分区级别,而非表级)
alter table tablename set (lock_escalation = auto);

-- 恢复默认行为(表级锁升级)
alter table tablename set (lock_escalation = table);
查看当前锁升级设置:
select
    name as table_name,
    lock_escalation_desc
from sys.tables
where lock_escalation_desc <> 'table'
order by name;
全局跟踪标记(仍可用但不推荐):
- 跟踪标记1211:完全禁用锁升级(可能导致锁内存耗尽)
- 跟踪标记1224:仅在锁内存达到40%阈值时才允许锁升级
四、识别长时间阻塞
4.1 配置阻塞进程阈值
sql server允许设置服务器级阻塞阈值,任何超过此阈值的阻塞将触发可捕获的事件。
配置阻塞阈值(单位:秒):
-- 设置阻塞阈值为20秒
exec sp_configure 'show advanced options', 1;
reconfigure;
exec sp_configure 'blocked process threshold', 20;
reconfigure;
解读:
- 任何阻塞超过20秒的会话都会触发
blocked_process_report事件 - 可通过扩展事件或sql profiler捕获
4.2 使用扩展事件捕获阻塞报告
推荐方法(开销低于sql profiler):
-- 创建扩展事件会话
create event session blockedprocessreport on server
add event sqlserver.blocked_process_report
add target package0.ring_buffer
with (
    max_memory = 4096 kb,
    event_retention_mode = allow_single_event_loss
);

-- 启动会话
alter event session blockedprocessreport on server state = start;
查询捕获的阻塞事件:
select
    event_data.value('(event/@timestamp)[1]', 'datetime2') as event_time,
    event_data.value('(event/data[@name="duration"]/value)[1]', 'bigint') / 1000 as duration_sec,
    event_data.value('(event/data[@name="database_name"]/value)[1]', 'nvarchar(128)') as database_name,
    event_data.value('(event/data[@name="blocked_process"]/value)[1]', 'nvarchar(max)') as blocked_process_report
from (
    select convert(xml, event_data) as event_data
    from sys.dm_xe_session_targets t
    join sys.dm_xe_sessions s on t.event_session_address = s.address
    where s.name = 'blockedprocessreport'
        and t.target_name = 'ring_buffer'
) as x
order by event_time desc;
五、对象级阻塞分析
5.1 使用sys.dm_db_index_operational_stats
sys.dm_db_index_operational_stats提供全面的索引使用统计信息,包括按表、索引和分区划分的详细锁定统计。
脚本5:分析对象级锁等待
-- 查找锁等待最严重的表和索引
select
    db_name(ios.database_id) as database_name,
    object_name(ios.object_id, ios.database_id) as table_name,
    i.name as index_name,
    ios.row_lock_count as [行锁次数],
    ios.row_lock_wait_count as [行锁等待次数],
    ios.row_lock_wait_in_ms as [行锁等待毫秒],
    case when ios.row_lock_count > 0
        then ios.row_lock_wait_in_ms * 1.0 / ios.row_lock_count
        else 0 end as [平均行锁等待ms],
    ios.page_lock_count as [页锁次数],
    ios.page_lock_wait_count as [页锁等待次数],
    ios.page_lock_wait_in_ms as [页锁等待毫秒],
    ios.page_latch_wait_count as [页闩锁等待次数],
    ios.page_latch_wait_in_ms as [页闩锁等待毫秒],
    ios.page_io_latch_wait_count as [页io闩锁等待次数],
    ios.page_io_latch_wait_in_ms as [页io闩锁等待毫秒]
from sys.dm_db_index_operational_stats(db_id(), null, null, null) ios
join sys.indexes i on ios.object_id = i.object_id and ios.index_id = i.index_id
where ios.row_lock_wait_in_ms > 0
   or ios.page_lock_wait_in_ms > 0
order by (ios.row_lock_wait_in_ms + ios.page_lock_wait_in_ms) desc;
关键指标解读:
| 指标 | 说明 |
|---|---|
row_lock_count | 持有的行锁数量 |
row_lock_wait_count | 等待行锁的次数 |
row_lock_wait_in_ms | 等待行锁的总毫秒数 |
page_latch_wait_count | 页闩锁等待次数(例如热点页面争用) |
page_io_latch_wait_count | 页i/o闩锁等待次数(慢速i/o导致) |
使用场景:
- 识别哪些表/索引是阻塞的热点
- 找出递增键插入导致的热点页面争用
- 分析是否需要调整索引设计
注意: 此dmv的信息从实例启动开始累积,实例重启后会丢失。建议定期轮询并保存到历史表。
六、整体阻塞影响评估
6.1 使用sys.dm_os_wait_stats
sys.dm_os_wait_stats汇总了所有连接的等待信息,可按等待类型分类以获取给定工作负载的性能概况。
脚本6:查询累计等待最高的等待类型
-- 排除无关的等待类型,聚焦业务相关等待
select top 20
    wait_type as [等待类型],
    waiting_tasks_count as [等待任务数],
    wait_time_ms as [总等待毫秒],
    max_wait_time_ms as [最大单次等待ms],
    signal_wait_time_ms as [信号等待ms],
    wait_time_ms - signal_wait_time_ms as [资源等待ms],
    cast((wait_time_ms - signal_wait_time_ms) * 100.0 / sum(wait_time_ms) over() as decimal(5,2)) as [占比%]
from sys.dm_os_wait_stats
where wait_type not in (
    -- 排除后台任务、空闲等待等无关等待类型
    'broker_eventhandler', 'broker_receive_waitfor', 'broker_task_stop',
    'broker_to_flush', 'broker_transmitter', 'checkpoint_queue',
    'chkpt', 'clr_auto_event', 'clr_manual_event', 'clr_semaphore',
    'dbmirror_dbm_event', 'dbmirror_events_queue', 'dbmirror_worker_queue',
    'dbmirroring_cmd', 'dirty_page_poll', 'dispatcher_queue_semaphore',
    'execsync', 'fsagent', 'ft_ifts_scheduler_idle_wait', 'ft_iftshc_mutex',
    'hadr_clusapi_call', 'hadr_filestream_iomgr_iocompletion', 'hadr_logcapture_wait',
    'hadr_notification_dequeue', 'hadr_timer_task', 'hadr_work_queue',
    'ksource_wakeup', 'lazywriter_sleep', 'logmgr_queue',
    'ondemand_task_queue', 'preemptive_xe_gettargetstate',
    'pwait_all_components_initialized', 'qds_persist_task_main_loop_sleep',
    'qds_async_queue', 'qds_cleanup_stale_queries_task_main_loop_sleep',
    'request_for_deadlock_search', 'resource_queue', 'server_idle_check',
    'sleep_bpool_flush', 'sleep_dbstartup', 'sleep_systemtask',
    'sleep_task', 'sleep_tempdbstartup', 'sni_http_accept',
    'sqltrace_buffer_flush', 'sqltrace_incremental_flush_sleep',
    'waitfor', 'waitfor_taskshutdown', 'wait_for_results',
    'xe_dispatcher_join', 'xe_dispatcher_wait', 'xe_timer_event'
)
and wait_time_ms > 0
order by wait_time_ms desc;
关键指标解读:
| 指标 | 说明 |
|---|---|
wait_time_ms | 总等待时间(包含资源等待+信号等待) |
signal_wait_time_ms | 从资源可用到线程在cpu上调度的等待时间 高值表示cpu争用 |
resource_wait_time_ms | wait_time_ms - signal_wait_time_ms实际等待资源的时间 |
常见的锁相关等待类型:
lck_m_s:等待共享锁(select被阻塞)lck_m_x:等待排他锁(update/delete被阻塞)lck_m_u:等待更新锁lck_m_ix:等待意向排他锁lck_m_is:等待意向共享锁
重置等待统计(用于基准测试):
dbcc sqlperf('sys.dm_os_wait_stats', clear);
注意: 重置会清空所有历史数据,建议在维护窗口或测试环境使用。
七、优化建议与最佳实践
7.1 短期优化(立即可执行)
1. 识别并终止长时间阻塞的会话
-- 杀掉长时间阻塞的会话(谨慎使用)
kill <blocking_session_id>;
2. 调整事务隔离级别
-- 对于读操作,考虑使用read uncommitted(如果业务允许脏读)
set transaction isolation level read uncommitted;
select * from orders where orderid = 12345;
3. 缩短事务持续时间
- 避免在事务中执行长时间操作(如调用外部api)
- 尽早提交或回滚事务
- 避免在事务中进行用户交互
7.2 中期优化(需要规划)
1. 优化索引设计
- 覆盖索引减少锁持有时间
- 合理的索引可以降低锁粒度(避免表级锁)
2. 使用行版本控制
-- 启用snapshot隔离级别(避免读操作被阻塞)
alter database yourdatabase set allow_snapshot_isolation on;
alter database yourdatabase set read_committed_snapshot on;
优势:
- 读操作不加锁(使用行版本)
- 读操作不被写操作阻塞
- 适合读多写少的场景
劣势:
- 增加tempdb负载(存储行版本)
- 可能导致更新冲突
3. 分区表(降低锁争用)
- 将大表分区,不同分区可以并行访问
- 启用分区级锁升级
7.3 长期优化(架构层面)
1. 应用程序设计
- 使用乐观并发控制(而不是悲观锁)
- 实现重试机制(处理死锁)
- 批量操作改为小批量(减少锁持有时间)
2. 读写分离
- 使用always on只读副本
- 报表查询路由到只读副本
- 减少主库的读压力
3. 数据库设计
- 避免热点表(如序列号表、计数器表)
- 使用队列表代替直接更新
- 考虑使用in-memory oltp(内存优化表)
八、阻塞诊断流程图
下图展示了完整的阻塞问题诊断流程,从问题报告到优化实施的完整路径:
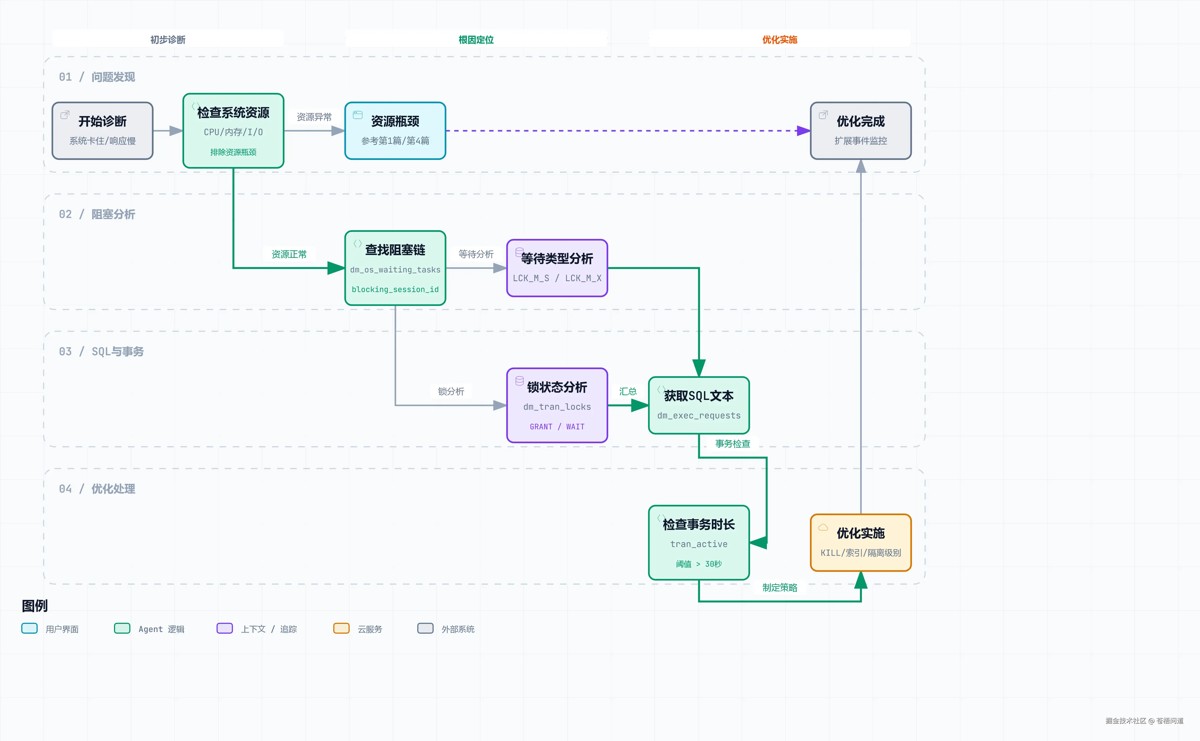
流程图说明:
这个流程图包含4个泳道、10个节点、2个分支路径和3组详细的指导卡片:
四个泳道:
- 问题发现:开始诊断 → 检查系统资源 →(分支:资源瓶颈参考第1篇/第4篇)
- 阻塞分析:查找阻塞链 → 等待类型分析(lck_m_s / lck_m_x)
- sql与事务:锁状态分析(grant/wait)→ 获取sql文本
- 优化处理:检查事务时长(>30秒阈值)→ 优化实施 → 持续监控
三组指导卡片:
- 关键诊断指标:blocking_session_id、lck等待类型、wait_duration_ms
- 锁与事务分析要点:锁粒度判断、锁状态、事务时长、锁升级阈值
- 优化策略三层次:短期(kill)/中期(sql优化)/长期(配置调整)/持续(监控)
九、阻塞问题排查清单
当用户报告"系统卡住"时,按以下顺序执行:
第1步:快速定位阻塞链
→ 运行脚本1:sys.dm_os_waiting_tasks
→ 找出blocking_session_id

第2步:查看阻塞者和被阻塞者的sql
→ 运行脚本4:综合阻塞诊断
→ 确认是什么sql导致阻塞

第3步:分析锁状态
→ 运行脚本2:sys.dm_tran_locks
→ 确认锁类型(s/x/ix)和锁粒度(行/页/表)

第4步:评估影响范围
→ 运行脚本6:sys.dm_os_wait_stats
→ 确认阻塞是否是系统性问题

第5步:决策
→ 短期:kill阻塞会话(如果必要)
→ 中期:优化sql/索引/隔离级别
→ 长期:调整应用架构
十、总结
阻塞问题是sql server性能优化中最常见的场景之一。通过本文介绍的dmv查询和诊断方法,你可以:
- 快速定位阻塞链(谁阻塞了谁)
- 分析根因(锁类型、锁粒度、sql文本)
- 评估影响(等待时间、影响范围)
- 采取行动(短期/中期/长期优化)
关键要点:
- 阻塞的特征:查询慢 + 资源消耗低
- 核心dmv:
sys.dm_os_waiting_tasks、sys.dm_tran_locks、sys.dm_exec_requests - 锁升级机制:5,000锁阈值或40%内存阈值
- 优化方向:缩短事务、优化索引、调整隔离级别、读写分离
本文提供的dmv脚本可以直接用于生产环境诊断,建议收藏备用。
以上就是sql server阻塞与死锁的诊断方法的详细内容,更多关于sql server阻塞与死锁的资料请关注代码网其它相关文章!



发表评论