
 我要评论
sql server 迁移真正的难点不在搬数据,而在海量存量 t-sql 代码的兼容。金仓 kes v9r4c019 通过深度兼容模式,让绝大多数存储过程、函数和报表 sql 无需改动或仅需极少量修改即可直接运行,重点在于它不只是支持几个关键字,而是从语法、语义到行为细节都做了对齐,并且必须配合正确的兼容模式使用。
最近这大半年,我一直在帮几个大客户做国产化替换的活儿。说实话,说到sql server数据库迁移,大家最怕的往往不是导数据。数据倒来倒去,用个kdts工具,哪怕几百g的库,跑一晚上也就过去了。真正让人头秃的,是应用代码的改造。
你想想看,很多老系统,十几年积累下来,几千个存储过程,再加上一堆触发器和自定义函数。里面全是t-sql的特有写法。你要把这些逻辑全用人肉翻译成别家数据库的语法,这工作量简直不敢想。而且稍不留神,改错一个逻辑,上线就是大事故。那么有没有一种办法,能让这些存量代码几乎不用改就能跑起来呢?今天咱们就借着金仓最新的kes v9r4c019版本,好好拆解一下它是怎么通过深度兼容,把t-sql语法给接住的。
一、做sql server迁移,为啥大家总卡在语法上
其实如果你做过从sql server往别的库迁的项目,你肯定有体会。表结构能对上,数据能灌进去,这仅仅只是万里长征的第一步。真正的硬骨头在后面。
1.1 存量t-sql代码太重了
以前在微软的体系下,开发人员特别喜欢把逻辑往下沉。也就是说,大量的业务计算直接写在数据库里。这对应用层来说确实方便,调个存储过程就把活干了。但是这就导致了一个结果,数据库里的t-sql代码量极其庞大。
t-sql这东西,它有很多自己的专属语法糖。别的数据库都不认。你要换底座,这些语法糖全得敲掉重写。重写不是敲键盘的事,你还得理顺里面的逻辑。有些逻辑连当初写代码的人都离职了,你现在去看那一坨几千行的存储过程,跟看天书一样。改起来极其容易出bug。
1.2 改业务逻辑的风险太大
还有一个很现实的问题。对于企业层级里的应用来说,稳定是第一位的。你改了底层逻辑,哪怕只是换了个函数名,也得重新做全量的回归测试。
很多项目根本拿不出那么多时间去做测试。他们希望的是,我换个数据库,应用代码一行都不动,或者顶多改个连接串和极个别的语句。如果不能做到“零修改”或者“极少修改”,这项目推下去的阻力就非常大。这也是很多传统迁移方案走不通的原因。
二、kes v9r4c019补全的几把硬刷子
为了解决上面说的这些痛点,金仓在kes的v9r4c019版本里,狠狠补全了一批sql server的核心语法特性。这不是简单支持几个关键字的事,而是把t-sql的那套逻辑给真正实现了。咱们挑几个最常用的硬骨头来看看。
2.1 merge语句:一个顶三个的利器
做过数据同步或者做落地方案的兄弟,肯定对merge语句不陌生。这东西在sql server里用得太广泛了。
它是干啥的呢?其实就是把insert、update、delete这三个操作捏在一块儿。你拿源数据跟目标表去比。如果目标表里有这行,你就更新;如果没有,你就插入;如果目标表里多出了源数据没有的,你还可以删掉。
在sql server里,写法是这样的:
merge into targettable as t
using sourcetable as s
on t.id = s.id
when matched then
    update set t.col1 = s.col1
when not matched then
    insert (id, col1) values (s.id, s.col1);
你看,这一句多清爽。如果你要在别的只支持标准sql的库里面干这个事。你得先写一句update关联着写。接着再写一句insert not exists。代码量翻倍不说,还得跑两遍,性能也受影响。
kes v9r4c019现在直接支持merge语句了。你原来的存储过程里写了merge,拿过来直接跑就行。不用拆开重写逻辑。这省了多少麻烦事。
2.2 output子句:改数据还能顺便拿结果的骚操作
这也是t-sql里特别好用的一招。一般的update或者delete语句,执行完了就给你返回一个影响了多少行的数字。但是有时候,我想知道我刚才删掉的那行数据到底是啥,或者我想把更新前和更新后的值拿出来做记录。
在别的库里,你可能得先开个事务,select出来,然后再update,最后commit。很繁琐。
sql server用output子句一步到位。
delete from mytable
output deleted.id, deleted.name
where status = 'expired';
这语句执行的时候,不仅把数据删了,还把删掉的那行数据给你返回出来。就像一个流水线,一边干活一边出货。这里面的 deleted 和 inserted 这两个虚拟表,kes现在也原样支持了。你用output子句拿到的结果集,跟在sql server里拿到的完全一样。这种细节语法的兼容,往往最能解决开发的痛点。
2.3 窗口函数与pivot/unpivot:报表统计的常客
企业层级里的系统,少不了做报表。做报表就肯定离不开窗口函数和行列转换。
sql server里的窗口函数,比如 row_number() over(partition by ... order by ...),用来做分组排序取第一条,太常见了。这个kes很早就支持了。因为pg内核本身就支持窗口函数,kes只是做了语法的适配。
但是pivot和unpivot就不一样了。这是sql server特有的行列转换语法。
比如你有个竖表记录了各个月份的销售额。你想把它转成横表,一月、二月、三月各成一列。用pivot写起来极其简单。
select *
from sales
pivot (sum(amount) for month in ([jan], [feb], [mar])) as p;
如果在别的库里,你得写一坨带case when的sql,或者自己在外面用代码转。kes v9r4c019现在把pivot和unpivot给实现了。那些复杂的报表存储过程,迁过来就不会因为语法不认而报错了。
2.4 并行dml:大数据量操作的速度保障
sql server有个特点,就是它在做大表的update或者insert的时候,如果数据量特别大,它会自动走并行。也就是说,它开好几个线程同时去改数据。这叫并行dml。这在大数据量处理的时候,速度能提升好几倍。
kes本身是基于pg内核的,pg在并行查询这块做得不错,但是并行dml这块原来是不行的。只能单线程改。金仓在底层引擎做了增强,支持了并行dml。当你执行一个大批量的更新操作时,kes也能像sql server一样,调动多个cpu核心一起去干活。这就保证了迁移过来后,跑批作业的性能不会拉胯。
三、抠细节:兼容颗粒度到底细到啥程度
大语法支持了,这能解决编译报错的问题。但是光能编译过还不行,还得跑出一样的结果。这就得看细节兼容的颗粒度了。kes在这方面扣得特别细。
3.1 like通配符的那些小九九
我们平时用like做模糊查询,谁不会啊。但是里面有个细节。sql server里,下划线 _ 是通配符,代表任意单个字符。百分号 % 代表任意多个字符。
如果我的业务数据里,本身就有一个下划线呢?比如我查名字叫 a_b 的产品。你要是直接写 like 'a_b',在sql server里,它会把 _ 当通配符,把 ab、 acb 全给你查出来。这就不对了。
sql server的做法是用方括号转义。你得写 like 'a[_]b'。这就只查 a_b 了。
但是pg和别的标准sql库,不认方括号转义。它们用反斜杠或者escape子句。如果你的代码里全是 [_] 这种写法,全得改。
kes v9r4c019在这个细节上,做到了对sql server行为的兼容。你写 like 'a[_]b',kes在底层知道你是要转义下划线,而不是去找方括号。它就按这个逻辑去查。这就省了开发人员去全局搜代码改转义符的麻烦。
3.2 top n与排序的配合
sql server查前几条数据,不用limit。它用top n。
select top 10 * from mytable order by createdate desc;
kes在s模式下,直接接住了top n语法。不仅如此,还有一个细节。sql server里,如果你用了top n,同时又指定了order by。如果排序字段有重复值,它返回的结果可能不稳定。有时候你加个 with ties,就能把并列的也查出来。kes对 with ties 也做了兼容。这种跟排序稳定性相关的细节,如果不支持,前端的分页列表就会少数据。
3.3 临时表与表变量的内部处理
sql server里用临时表特别多。什么 #temptable、##globaltemp。还有表变量 @tablevar。
表变量这东西,在sql server里是没有统计信息的。它往往仅仅只是走固定计划。而临时表是有统计信息的。
kes在内部对这两者做了映射。对于表变量,kes把它当成一种不收集统计信息的特殊内部表来处理。对于临时表,kes实现了跟sql server一样的会话级生命周期和自动清理机制。你的存储过程里写了 create table #temp,过程跑完,这个表就自动没了。不需要你手动去drop。这种行为的对齐,保证了存储过程逻辑的闭环。
四、存量t-sql代码直接跑的底气在哪
说了这么多零散的点,你可能会问,kes怎么就能让存量代码直接跑呢?它底层的机制到底是啥?我画了个图,大家看一下t-sql在kes内部的流转过程。
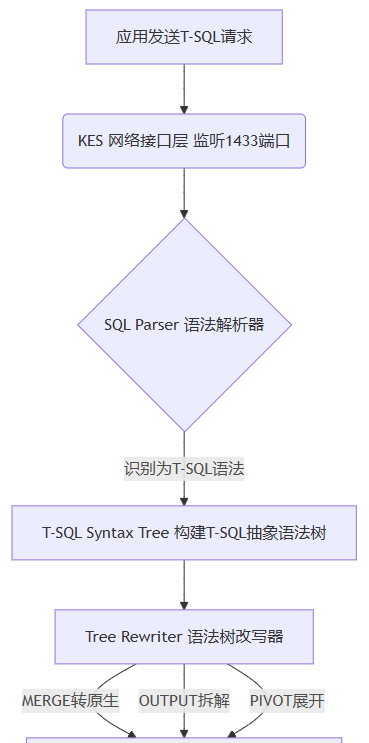
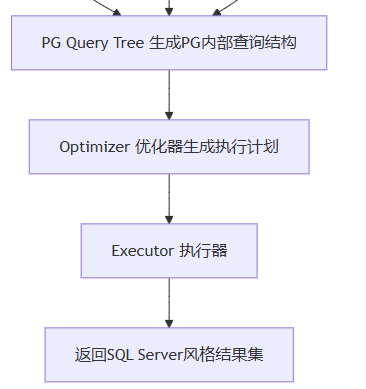
你看这个流程。应用发过来的t-sql,首先被kes的s模式解析器接住。解析器不是简单粗暴地报错说不认识。它会构建出一棵t-sql专属的语法树。
接着关键的一步来了,语法树改写器。它会在底层把t-sql的逻辑,等价转换成pg内核能理解的查询结构。比如你发了merge,它给你拆解成pg的upsert逻辑。你发了output,它给你拆解成带returning的cte逻辑。
这种改写是在底层自动完成的。对上层应用完全透明。所以你的应用代码确实不需要改。
4.1 流程控制与异常处理
存储过程里最让人头疼的就是流程控制。 if...else 嵌套七八层,再来个 while 循环。循环里面如果出错了呢?得用 try...catch 捕获。
kes现在完全支持t-sql的流程控制语法。你写 begin try ... end try begin catch ... end catch。如果try块里的sql挂了,流程会自动跳到catch块里去。而且在catch块里,你能拿到 error_number()、error_message() 这些系统函数的值。这跟在sql server里的行为一模一样。
以前这种带异常处理的存储过程,迁移的时候基本得推翻重写。现在直接拿过来编译一下,跑个测试用例,基本就能过了。
4.2 隔离级别与锁提示
并发控制也是迁移的一大坎。sql server默认的隔离级别是读已提交。但是它有个特点,就是在这个级别下,读操作默认会加共享锁。这跟pg的读已提交是不一样的。pg是不加锁,靠mvcc快照读。
如果你的业务逻辑依赖于读操作加锁来防止别的事务修改,那迁到pg下就可能出问题。
kes在s模式下,对隔离级别的行为做了对齐。它模拟了sql server的锁行为。
再一个就是锁提示。sql server开发人员最喜欢在sql里加个 with(nolock)。这其实就是脏读,能提高并发,但可能读到未提交的数据。kes对 nolock 提示也做了兼容。你加了这提示,kes底层就会用对应的快照读机制去处理,不报语法错误,行为也跟sql server的脏读对齐。
五、实际改造中的几个注意事项
虽然kes在语法兼容上做得相当到位了,但是在实际项目里,有些事还是得自己留心。毕竟没有两款数据库能做到百分百行为一致。
5.1 啥s模式是前提
这点我必须强调。kes初始化实例的时候,一定要选s模式。也就是sql server兼容模式。如果你选成了pg模式或者oracle模式,那上面说的merge、output、try…catch这些,全都不认。
模式选错了,等于地基打歪了,后面全白搭。我之前带的一个项目,有个新来的兄弟装库的时候手抖选错了模式,后面迁脚本迁得想砸键盘。最后只能把库删了重建。
5.2 遇到极个别不支持的怎么办
有些特别偏门的系统存储过程,或者一些跟操作系统强相关的dbcc命令,kes现在确实还没完全覆盖到。这种情况的话,也不要慌。
通常来说,这些偏门语法在你的业务代码里占比极小,可能连1%都不到。对于这部分,你只需要稍微手动改一下。比如某个dbcc命令是用来清理缓存的,你可以换成kes对应的系统函数。改完跑个回归测试就行。这比把几千个存储过程全重写一遍,工作量还是小得多。
六、总结几句掏心窝子的话
做数据库替换这活儿,最怕的就是动业务逻辑。逻辑一动,测试无穷无尽。金仓kes v9r4c019这套深度兼容的打法,我觉得路子是对的。
它不是让你去硬着头皮学新语法,而是主动去适应你原来的老代码。merge能跑了,output能跑了,try…catch能跑了,连nolock和方括号转义都认了。这就是在帮你把改造的门槛一点点往下降。
当大部分存量t-sql代码都能直接跑起来的时候,你就有更多的精力去处理那些极个别真正需要改的点。项目推进的阻力自然就小了。对于做sql server迁移的兄弟们来说,kes现在的这个兼容度,确实值得一试。搭个环境,把你的存储过程导进去跑一把,你就知道省多少事了。
到此这篇关于聊聊 sql server 数据库迁移的那些坑,看 kes 如何做到代码几乎不用改的文章就介绍到这了,更多相关sql server数据库迁移遇到的坑内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!


发表评论