
 我要评论
sql server 数据库迁移的项目里,最容易被低估的一个问题是什么?其实就是“原来的 sql,还能不能按原来的方式继续工作”。表结构和数据这些,通过工具是能搬过去的。但应用这边呢,往往会在存储过程、报表查询、批处理脚本里用了一堆 t-sql 的特性。那么迁移团队如果只是做一次连接测试就完事的话,很可能要到上线之后的某条分支逻辑里,才碰到语法或者结果上的差异,这时候就麻烦了。
我个人更倾向的做法是,把兼容性验证当成一份回归清单来做。金仓 kes v9r4c019 对 sql server 常用的 merge、并行 dml、output、窗口函数、pivot/unpivot 还有 like 通配符这些能力,都做了补齐或者增强。意义在于什么呢?就是让存量的代码尽可能保留下来。但是注意,“尽可能保留”这件事,必须通过结果集、事务和并发行为去验证,不能光看语句执行成功了就认为没问题。

从代码资产开始盘点
第一轮盘点的时候,不要急着去改 sql。先把代码来源分清楚:数据库里面的视图、函数、存储过程和触发器,算是一类;应用仓库里的 mapper xml、脚本文件和 orm 模板,这是另一类;还有运行时拼接出来的 sql,又是第三类。
我会给每一条语句都附上来源模块、调用接口和业务优先级。这么做的好处是什么呢?就是出现不兼容的情况时,可以先处理交易链路,低频报表往后放一放。kdms 是能帮你采集对象和应用 sql 的,不过采集出来的结果,还是要和代码仓库、线上日志互相核对一下。为什么?就是为了避免把没采集到的动态语句误判成不存在,这种事其实挺常见的。
merge 要验证的不只是语法
merge 这个语句,通常用在同步主数据或者批量 upsert 的场景。sql server 的代码呢,可能会依赖匹配、未匹配和删除分支的组合:
merge into dbo.product as t
using @incoming as s
   on t.product_id = s.product_id
when matched and s.disabled = 1 then
  delete
when matched then
  update set product_name = s.product_name,
             price = s.price
when not matched then
  insert (product_id, product_name, price)
  values (s.product_id, s.product_name, s.price);
迁移回归的话,至少要覆盖四个场景:匹配更新的情况、未匹配插入的情况、条件删除的情况,还有源数据出现重复键的情况。另外还要观察一下,同一个事务里面触发器有没有执行、受影响行数是怎么返回的、发生冲突之后回滚是不是回得完整。kes 是支持 merge 的,这样就能减少把一条语句拆成好几段分支的改造工作。但是话说回来,最终还是要按业务数据来验证,这一步省不掉。
output 会影响应用下一步动作
很多应用会用 output 去拿生成键,或者获取记录变更前后的值。那么迁移之后呢,就算插入是成功的,如果返回的列顺序、类型或者空值行为变了,应用在下一步组装请求的时候就可能出错。这种问题往往很隐蔽,不容易第一时间发现。
declare @new_rows table (id bigint, created_at datetime2);
insert into dbo.invoice(customer_id, total_amount)
output inserted.invoice_id, inserted.created_at
into @new_rows(id, created_at)
values (@customer_id, @amount);
select id, created_at from @new_rows;
我的习惯是,成功路径和失败路径要同时测。比如说,唯一键冲突的时候还返不返回记录?事务回滚之后,临时表是不是空的?批量插入的时候,返回顺序应用那边能不能接受?这些问题,只跑一条成功样例是覆盖不到的。
窗口函数要对齐边界条件
窗口函数一般出现在分页、排名,还有“每组取最新一条”这种查询里。row_number、rank、lag 还有累计聚合,看起来仅仅是函数名不一样而已。但实际上呢,结果还会受排序稳定性、null 排序位置和窗口框架的影响。
with ranked as (
  select employee_id,
         department_id,
         salary,
         row_number() over (
           partition by department_id
           order by salary desc, employee_id
         ) as rn
  from employee
)
select employee_id, department_id, salary
from ranked
where rn <= 3;
那测试数据怎么准备呢?要包含工资并列的情况、有空值的情况、只有一条记录的部门,还有没有任何匹配记录的部门。kes 的兼容支持,让原来的 sql 有机会直接跑起来。不过排序和分页的边界,仍然要跟旧系统一行一行去对照,这个工作量省不得。
pivot/unpivot 关系到报表列
财务和运营的报表,经常会把月份转成列来展示。用了 pivot 的原 sql 迁移之后,如果列名、空月份还有数值精度的处理方式不一样了,报表导出就会出现一种情况——“列还在,但数字不对了”。这个对业务方来说其实挺头疼的。
select account_id, [2025-01], [2025-02], [2025-03]
from (
  select account_id, month_key, amount
  from account_monthly
) s
pivot (
  sum(amount) for month_key in ([2025-01], [2025-02], [2025-03])
) p;
回归的时候呢,要把缺失月份、重复月份、金额为 null 的记录都包含进去。unpivot 这边呢,要检查一下空值行有没有保留。kes 对这两类语句的兼容,好处在于让报表逻辑先保持原貌跑起来,性能的事可以后面再决定要不要改写。
并行 dml 需要观察资源曲线
批量清理和月末结算这种场景,可能会依赖并行 dml。那迁移的时候最危险的误区是什么呢?就是看到 sql 能跑了,直接把并行度开到最大。为什么要小心呢?因为并行执行是要消耗 cpu、内存、日志还有临时空间的。在线业务高峰期的话,还可能让锁等待变多。
我的做法是,把并行回归分成低、中、高三个档位,分别记录总耗时、受影响行数、锁等待、日志增长还有业务接口的延迟。要注意一点,单次批处理变快了,不代表整个平台就更快了。如果报表查询和在线交易同时都变慢了,那就说明参数没调对,得回头重新来。
like 是兼容性最细的检查点
动态搜索通常都是写成 like 的。但是通配符、转义、排序规则,还有大小写敏感性,这些都有可能改变结果。尤其是应用允许用户自己输入 % 或者 _ 的情况,必须确认转义字符前后是一致的,不然很容易出问题。
select product_id, product_name
from product
where product_name like @keyword escape '\\';
回归数据这边呢,应该把中文、大小写字母、百分号、下划线、反斜杠还有空字符串都放进去测一遍。另外还要检查一下参数类型到底是 varchar 还是 nvarchar。为什么这个重要呢?因为字符集和隐式转换的问题,可能带来索引失效,或者结果发生变化。kes 对通配符细节的支持,价值其实就在这里——把那些“小地方”的额外改造给省下来。
连接和事务不能被兼容语法遮住
应用代码几乎不改,不等于连接层不改。jdbc 驱动、连接 url、默认 schema、认证方式、连接池重连和超时参数都要单独验证。迁移后常见的问题是:开发环境能连,连接池在网络闪断后无法恢复;查询能执行,批量提交时却因为事务隔离级别不同而出现锁等待。
我会把连接回归放在真实连接池中做,至少覆盖首次连接、空闲连接复用、数据库重启后的重连和事务异常回收。对于依赖 sql server 系统表、作业代理、clr 或 service broker 的外围能力,也要单列为人工改造项。
数据类型要做“往返测试”
sql 语法兼容之后,还有一类问题不一定马上报错,那就是数据类型映射。金额字段的精度和标度、datetime2 的小数秒、uniqueidentifier、大文本、二进制数据以及 nvarchar,都可能在写入和读回时产生边界差异。只检查建表成功,会漏掉应用实际绑定参数后的行为。
我会准备一组边界值:最大和最小金额、超过日常长度的中文字符串、毫秒和微秒时间、空字符串、null、大对象以及特殊字符。数据从应用写入 kes 后再读回,并与原输入逐字段比较,这就是“往返测试”。如果系统还处于双轨期,也可以让同一组请求分别进入旧库和新库,再比较接口响应,而不是直接比较数据库内部显示格式。
默认值也值得单独检查。应用有时省略某个字段,依赖数据库自动生成时间、流水号或状态;迁移后如果默认表达式不同,insert 本身仍会成功,业务数据却会慢慢分叉。触发器、序列和自增列应和数据类型一起列入回归清单。
错误路径要比成功路径多测一步
迁移验证常把主要精力放在成功交易上,错误处理却决定了系统出问题时会不会重复扣款或重复下单。需要主动制造唯一键冲突、外键失败、超时、死锁和连接中断,观察应用是否得到可识别的错误,事务是否完整回滚,连接是否还能放回池中继续使用。
sql server 与 kes 的错误码和异常文本不必完全相同,应用却不能依赖一段固定中文报错做业务判断。更稳妥的方式是由数据访问层把数据库异常归类,再向上层返回稳定的业务错误。迁移盘点发现这类耦合时,应把它列为应用改造,而不是用数据库兼容性把问题盖住。
批处理还要验证部分失败。假设一次提交 1000 条记录,其中一条违反约束,应用预期是整批回滚还是跳过错误行继续?这个行为需要由业务规则决定,并在新库上重复验证。它对数据一致性的影响,通常比一条查询快几十毫秒更大。
一套可执行的迁移顺序
项目实施可以按以下顺序推进:
- 采集并分类 sql server 对象和应用 sql;
- 在 kes 上完成结构构建和静态兼容检查;
- 先回归
merge、output、窗口函数、pivot/unpivot、like等高频特性; - 再验证连接池、事务、批处理和并发资源;
- 用双轨或灰度方式对照关键接口结果;
- 关闭问题清单后再安排切换。
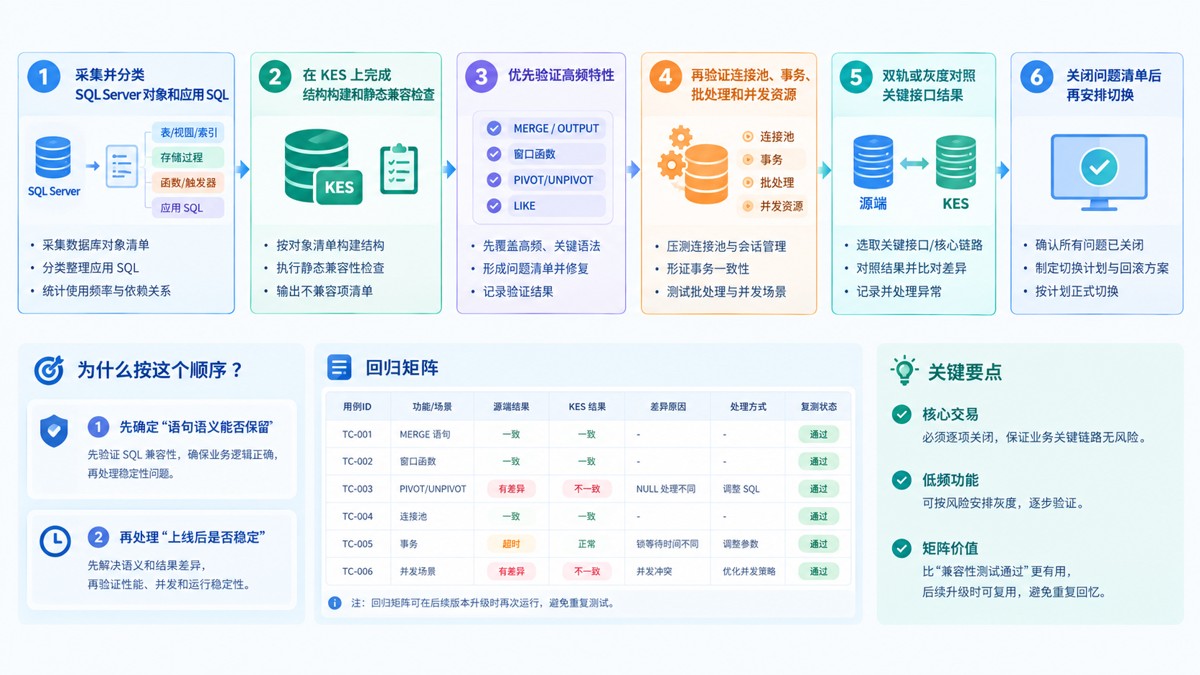
这个顺序的好处是先确定“语句语义能否保留”,再处理“上线后是否稳定”。如果一开始就同时改 sql、换驱动、调并行参数,出了问题很难知道是哪一层造成的。
执行过程中可以维护一张回归矩阵,每个用例记录源端结果、kes 结果、差异原因、处理方式和复测状态。核心交易必须逐项关闭,低频功能可以按风险安排灰度。矩阵比一句“兼容性测试通过”更有用,因为后续版本升级时可以再次运行,而不用重新回忆当时测过什么。
结语
sql server数据库迁移的目标,不是机械地保证每条语句都不变,而是把真正需要改的地方缩小到可管理的范围。kes v9r4c019 对常用 t-sql 特性的兼容,为存量应用保留了较大的迁移空间;kdms 的评估和对象采集,则帮助团队在改造前看见风险。
我会把“结果集、事务边界、并发资源、外围连接”作为四道验收门。四道门都通过,才有资格说这次迁移接近零修改;只做语法通过测试,最多只能说明数据库接受了这条 sql。
到此这篇关于sql server 数据库迁移并非只改连接串:kes 兼容回归清单的文章就介绍到这了,更多相关sql server数据库迁移内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!


发表评论