
 我要评论
本文摘要:大表膨胀 200gb,autovacuum 执行仍回收不动。n_dead_tup、xact_start 与复制槽能定位阻碍回收的长事务。适用于 pg 12-16 写入大表,业务必需长事务不适用。
一、问题与结论
linux + postgresql 14.6 的业务库中,写入频繁的 orders 表从 40gb 涨到 200gb,触发磁盘告警。现场有三个一致的现象:
pg_stat_user_tables.autovacuum_count每天递增,autovacuum 确实在跑;n_dead_tup长期停在数百万量级,vacuum verbose只报告清掉极少量死元组;- 应用没有报错,只是这张表相关的查询越来越慢。
结论先给:autovacuum 没坏,触发阈值也不是主因,真正的元凶是某个长事务(多数是 idle in transaction 会话)尚未结束,使回收水位 xmin horizon 无法前移。vacuum 按 mvcc 规则"正确地"拒绝回收这些仍可能被该事务看到的死元组。下面先做三级排查,再给可复制的最小复现,最后说明什么时候不该走"杀事务"这条路。
文中查询结果均为预期输出(未验证),具体数值以你环境的实际输出为准。
二、排查与选择依据
先给结论:按"膨胀在哪 → 谁在挡 → 复制槽是否也在挡"三步走,每步一条查询,三步都跑完才算排查结束。
1. 看死元组比例
select relname,
       n_live_tup,
       n_dead_tup,
       round(100.0 * n_dead_tup / nullif(n_live_tup, 0), 1) as dead_pct,
       last_autovacuum,
       autovacuum_count
from pg_stat_user_tables
where n_dead_tup > 10000
order by n_dead_tup desc
limit 20;
dead_pct 很高、last_autovacuum 却是最近时间,这是长事务问题的典型指纹:跑过,但清不动。再确认物理大小,避免只看行数误判:
select relname,
       pg_size_pretty(pg_total_relation_size(relid)) as total_size
from pg_stat_user_tables
order by pg_total_relation_size(relid) desc
limit 10;
2. 看长事务
select pid, state, backend_type,
       xact_start,
       now() - xact_start as txn_age,
       left(query, 80) as query_snippet
from pg_stat_activity
where xact_start is not null
  and now() - xact_start > interval '10 minutes'
order by txn_age desc;
注意两点。一是 state = 'idle in transaction' 最隐蔽:会话不执行任何查询,xact_start 却一直不动,常见于应用异常路径没有 rollback、orm 事务管理器没释放连接、dba 在 psql 里 begin 后忘记提交。二是用普通账号执行时看不到别人的 query,需要 pg_read_all_stats 角色或改用超级用户,否则这一步会漏判。
3. 看复制槽
复制槽同样会固定回收水位,尤其是迁移后残留的逻辑槽:
select slot_name, slot_type, active,
       xmin, catalog_xmin,
       pg_size_pretty(
         pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)
       ) as lag
from pg_replication_slots
where not active
   or pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn) > 1073741824;
active = false 表示没有消费端,1073741824 是 1gb 的 wal 积压阈值(字节)。物理槽的 xmin 为 null 属正常;该查询需在你的环境验证字段可用性。
替代方案与取舍
| 方案 | 选择条件 | 代价 | 边界 |
|---|---|---|---|
终止长事务 + 普通 vacuum | 事务是闲置连接、可回滚 | 该事务整体回滚,业务需重试 | 长事务为业务必需时不可用 |
vacuum full 重写表 | 需立即归还磁盘、有维护窗口 | access exclusive 锁、需额外磁盘空间 | 仍有活跃事务时会等待并阻塞读写 |
分区表 + drop 旧分区 | 按时间增长的日志型数据 | 应用需支持分区路由,有管理成本 | 需提前设计,救不了存量单表 |
| 调小 autovacuum 触发阈值 | 死元组积累慢、i/o 有余量 | 更多 i/o 与 cpu 开销 | 水位被卡住时完全无效 |
不该用本文方案的两类情形:长事务是报表或数据迁移所必需(应改走分区或维护窗口,而不是杀掉),以及磁盘已耗尽且表内几乎全是活跃数据(此时只能 vacuum full 或扩容,杀事务也回收不出空间)。
三、关键原理
postgresql 用 mvcc 实现隔离:每个事务持有快照,vacuum 只能回收对所有活跃快照都不可见的死元组,判断依据就是 xmin horizon。只要有一个事务尚未结束,postgresql 就无法判定它是否会看到这些元组版本,水位停在旧位置,n_dead_tup 自然居高不下。
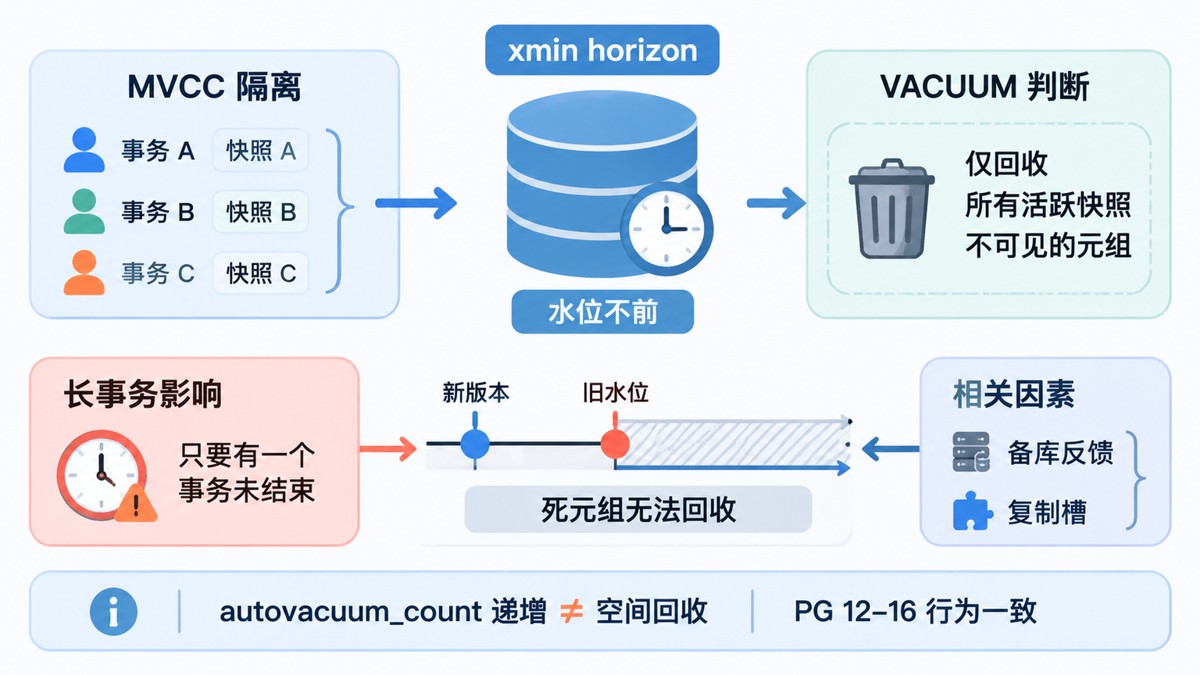
因此 autovacuum_count 递增只代表进程跑过,不代表空间被回收——"执行成功"与"回收成功"是两件事,这正是排查时最容易被误导的地方。开启 hot_standby_feedback 的备库和复制槽也以 xmin、catalog_xmin 形式固定水位,逻辑是同一套。这也解释了该问题在 pg 12 到 16 之间行为一致:mvcc 与 vacuum 的回收规则不随版本改变。
四、可运行示例
环境:linux x86_64、postgresql 14(12-16 通用)、psql 超级用户会话。
第一步,建表并制造死元组(输入:100 万行,两次 update 共产生约 75 万条死元组):
create table test_bloat as
select g as id, repeat('x', 100) as payload
from generate_series(1, 1000000) g;

update test_bloat set payload = repeat('y', 100)
where id <= 500000;
update test_bloat set payload = repeat('z', 100)
where id <= 250000;
analyze test_bloat;
第二步,在另一个 psql 会话打开长事务并保持不退出:
begin;
select count(*) from test_bloat where id = 1;
-- 不 commit,不退出本会话
第三步,回到主会话执行并观察:
vacuum verbose test_bloat;

select n_live_tup, n_dead_tup, last_vacuum
from pg_stat_user_tables
where relname = 'test_bloat';
预期输出:vacuum verbose 报告 removed 的死元组数远低于两次 update 产生的约 75 万条,n_dead_tup 仍然很高,表大小几乎没变。
实际输出:在你的环境里记下执行后的 n_dead_tup 与 last_vacuum 时间戳,与第二步前的值对比,差值就是本次 vacuum 的真实回收量。
常见失败:终止了 pg_stat_activity 里查到的长事务后再次 vacuum,空间仍然回收不动。原因是挡水位的对象不止一个——通常是另一个 idle in transaction 会话,或一个残留复制槽。修复方法是把第二节三条查询全部跑一遍,逐个确认清零后再执行 vacuum;若第一步查询返回空,先检查是否因权限不足看不到他人会话。
五、验证结果与边界
第四步,定位、终止、再验证:
select pid, state,
       now() - xact_start as txn_age,
       left(query, 60) as query_snippet
from pg_stat_activity
where xact_start is not null
order by txn_age desc;

-- 把 pid 换成上一步查到的值
select pg_terminate_backend(12345);
vacuum verbose test_bloat;
预期输出:n_dead_tup 显著下降,vacuum verbose 报告清掉了大部分死元组,表文件大小同步减小(未验证,需以实际输出为准)。
需要同时知道的边界:普通 vacuum 只回收元组并截断文件尾部空页,中间的空洞不一定归还操作系统,因此 pg_total_relation_size 可能只小幅下降,回收效果应以 n_dead_tup 和 verbose 计数为准;被终止的事务会整体回滚,可能引发业务重试;pg_terminate_backend 作用于错误的 pid 会中断正常连接,执行前必须核对 state、xact_start 与 query_snippet。预防层面,idle_in_transaction_session_timeout 能自动掐掉忘记提交的会话,但对确实需要长事务的报表任务会误杀,设置前要先确认业务形态。
思考
- 自动终止长事务的收益与误杀报表事务的风险,超时阈值该按什么划线?
- 分区表的路由与管理成本,是否值得为绕开回收限制而提前付出?
到此这篇关于postgresql表膨胀200gb的问题诊断与优化实战的文章就介绍到这了,更多相关postgresql表膨胀200gb内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!

发表评论