
 我要评论
dataframe是pandas中常用的数据结构,并且在数据分析中使用非常方便、简洁,总结如下。
1、介绍dataframe
dataframe是pandas中的表格型数据结构,可以理解为xlsx中的表格;
它含n个有序的列,每一列可以是不同的值类型(数值、字符串、布尔型值),也可以理解为由series组成的字典(series是padas中一种基础数据结构,理解为表格中的一列);
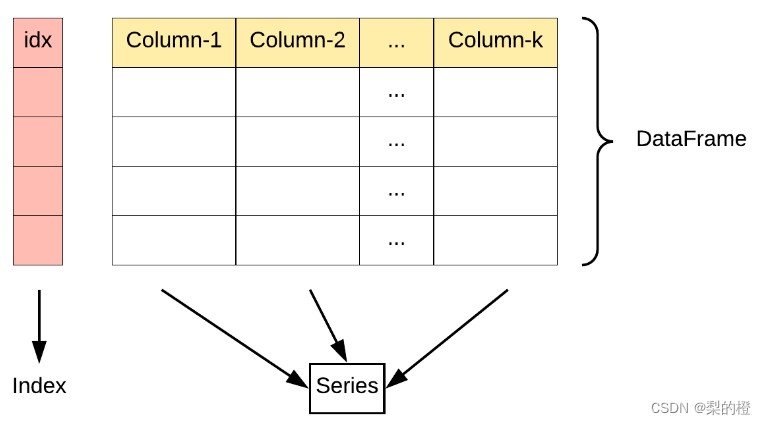
此外dataframe是一个二维的数据结构,也可以看成是二维的数据,结构如图所示(图片来源菜鸟教程):
其中
- index:表示索引值,就是行标签,默认值为0,1,2....;
- column-i:表示列标签,默认值为0,1,2...
2、如何创建dataframe
首先需要了解pd.dataframe( data, index, columns, dtype, copy)构造方法
- data:一组数据(list, dict, ndarray, series等类型)。
- index:用于指定行标签。
- columns:用于指定列标签 。
- dtype:数据类型。
- copy:拷贝数据,默认为 false。
1)通过列表创建
指定行标签
import pandas as pd

def main():
    data = [[1, 2, 3], ['google', 'meta', 'apple']]
    index = ['idx', 'name']
    df = pd.dataframe(data, index=index)

    print(df)
指定列标签
import pandas as pd


def main():
    data = [['google', 1], ['meta', 2], ['apple', 3]]
    col = ['name', 'id']
    df = pd.dataframe(data, columns=col)

    print(df)
2)通过字典创建
字典的key对应表格的列名,value对应每个列中存在的值。
import pandas as pd


def main():
    data = {'name': ['google', 'meta'], 'idx': [1, 2]}
    df = pd.dataframe(data)
    print(df)
3)使用numpy中数组来创建
numpy中数组就是类似的二维数组,可以使用行标签指定,也可以使用列标签指定
import pandas as pd
import numpy as np


def main():
    ndarray_data = np.array([
        ['google', 1],
        ['meta', 2],
        ['apple', 3]
    ])
    idx = [0, 1, 2]
    df = pd.dataframe(ndarray_data, index=idx)
    print(df)
3、dataframe的属性
1) df.shape
用于返回 dataframe对象 的维度信息(形状),即行数和列数。返回包含行数和列数的元组。
import pandas as pd

# 创建一个示例 dataframe
data = {'a': [1, 2, 3],
        'b': [4, 5, 6],
        'c': [7, 8, 9]}
df = pd.dataframe(data)

# 使用 df.shape 获取 dataframe 的维度信息
shape = df.shape

# 打印结果
print("dataframe 的维度信息:", shape) # (3,3)
2)df.columns 用于获取列名 3)df.index 用于获取索引
4、dataframe索引元素方式
pandas 使用 loc 属性返回指定行和列的数据,从0开始计数
1)指定行号和列号访问元素
import pandas as pd

# 创建一个示例 dataframe
data = {'a': [1, 2, 3],
        'b': [4, 5, 6],
        'c': [7, 8, 9]}
df = pd.dataframe(data)

# 选择第二行第三列的元素
element = df.iloc[1, 2]

# 打印结果
print(element)
2)使用切片,选择连续的多行或多列数据
import pandas as pd


def main():
    data = {'a': [1, 2, 3],
            'b': [4, 5, 6],
            'c': [7, 8, 9]}
    df = pd.dataframe(data)

    target = df.iloc[:2, :2]
    print(target)
3)使用列表,选择多行或多列数据
import pandas as pd


def main():
    data = {'a': [1, 2, 3],
            'b': [4, 5, 6],
            'c': [7, 8, 9]}
    df = pd.dataframe(data)

    target = df.iloc[[0, 2], [1, 2]]
    print(target)

main()
4)使用列索引名称来,获取数据
import pandas as pd


def main():
    data = {'a': [1, 2, 3],
            'b': [4, 5, 6],
            'c': [7, 8, 9]}
    df = pd.dataframe(data)

    target = df.iloc[0]['a']
    print(target)
5、常用的一些函数
1)df.dropna() 用于删除表格中包含缺失值的行 df.dropna(axis=1) 用于删除表格中指定列中包含缺失值的行
2)df.fillna(value=0, inplace=true) 对于dataframe中缺失的值,还可以根据值进行填充
3)df.sort_values(by='column_name', ascending=true) 根据指定的列名排序表格,默认为升序排序
import pandas as pd


def main():
    data = {'a': [1, 2, 3],
            'b': [7, 3, 1],
            'c': [7, 8, 9]}
    df = pd.dataframe(data)

    target = df.sort_values(by='b')
    print(target)

main()
4)df.sample() 用于从dataframe中随机抽取样本。
默认情况,可以返回指定数量的随机样本的dataframe。
import pandas as pd

# 创建一个示例 dataframe
data = {'a': [1, 2, 3, 4, 5],
        'b': ['a', 'b', 'c', 'd', 'e']}
df = pd.dataframe(data)

# 从 dataframe 中随机抽取两个样本
sample = df.sample(n=2)

# 打印结果
print(sample)
df.sample() 方法还支持其他参数,例如 frac(指定要抽取的样本占原始数据的比例)、replace(是否允许重复抽样)。
5)pd.concat()
pandas中用于合并数据的函数,可以沿着指定的轴将多个dataframe或者series对象连接起来。
沿着行进行数据合并,因此合并的两个对象在series上一致。
import pandas as pd

# 创建两个示例 dataframe
df1 = pd.dataframe({'a': [1, 2, 3],
                    'b': [4, 5, 6]})
df2 = pd.dataframe({'a': [7, 8, 9],
                    'b': [10, 11, 12]})

# 使用 pd.concat() 连接两个 dataframe,并为每个 dataframe 添加一个层次化索引
result = pd.concat([df1, df2], keys=['df1', 'df2'])

# 打印结果
print(result)
沿着列进行合并,因此合并的两个对象在行数上一致。
import pandas as pd

# 创建两个示例 dataframe
df1 = pd.dataframe({'a': [1, 2, 3],
                    'b': [4, 5, 6]})
df2 = pd.dataframe({'c': [7, 8, 9],
                    'd': [10, 11, 12]})

# 使用 pd.concat() 沿列轴连接两个 dataframe
result = pd.concat([df1, df2], axis=1)

# 打印结果
print(result)
6)df.series_name.value_counts()
计算dataframe中某个series中每个唯一值的出现次数
import pandas as pd
import numpy as np


def main():
    data = {'a': [1, 2, 3],
            'b': [7, 3, 1],
            'c': [7, 8, 9]}
    df = pd.dataframe(data)

    target = df.b.value_counts()
print(target)实际应用中,dataframe中还有很多方法没有介绍,根据需要边用边查。
总结
以上为个人经验,希望能给大家一个参考,也希望大家多多支持代码网。




发表评论