
 我要评论
写在前面
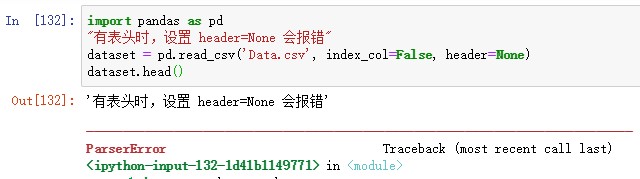
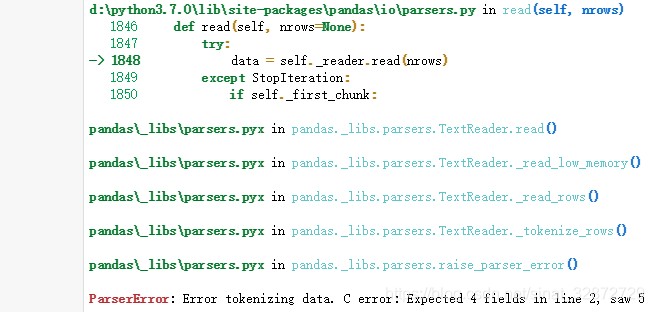
使用pandas中read_csv读取csv数据时,对于有表头的数据,将header设置为空(none),会报错:
pandas_libs\parsers.pyx in pandas._libs.parsers.raise_parser_error()
parsererror: error tokenizing data. c error: expected 4 fields in line 2, saw 5
查看pandas官方文档发现,read_csv读取时会自动识别表头,数据有表头时不能设置header为空(默认读取第一行,即header=0);
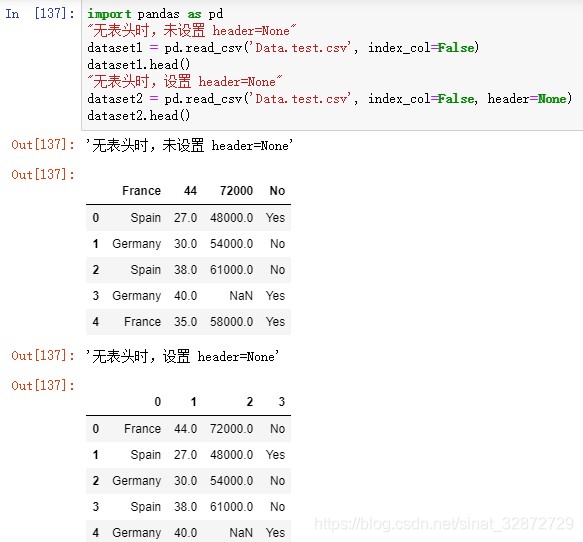
数据无表头时,若不设置header,第一行数据会被视为表头,应传入names参数设置表头名称或设置header=none。
参考文档:
这是pandas的read_csv的官方文档:python - pandas.read_csv
read_csv的header参数
使用pandas的read_csv读取数据时,header参数表头名称设置(即各列数据对应名称),下面是文档中对header参数的说明:
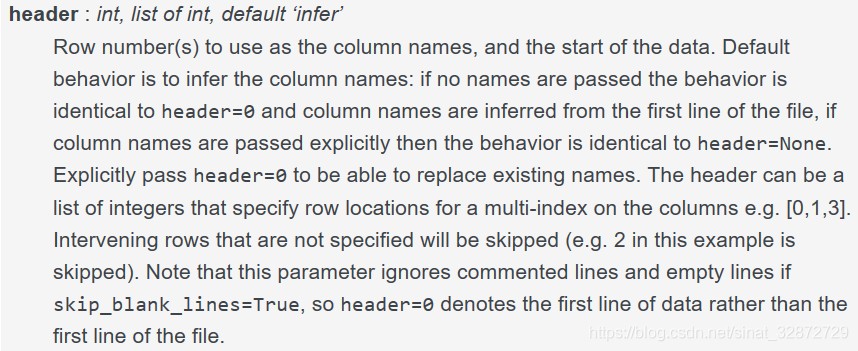
其中指出,表头可根据数据格式推断各列名称:默认情况下,
- 若未传入
names参数,则根据输入文件的第一行推断是否有表头; - 若传入
names参数,则names传入的参数作为表头(原数据有表头则会替换原有表头)。
下面是对read_csv的header参数测试
header参数测试
测试数据
两个csv(用逗号隔开)格式的文件,这里是用excel打开,分别是带有表头和不带表头的数据:
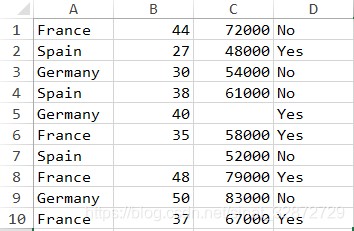
默认header
下面是header默认情况下,对有表头的数据识别第一行作为header(即header=0)[ 数据没有给出index名称,这里设置 index_col=false,不设置默认第一列为index(而表头仍是4列,最后一列数据为nan), index_col参数与 header类似可自动识别。
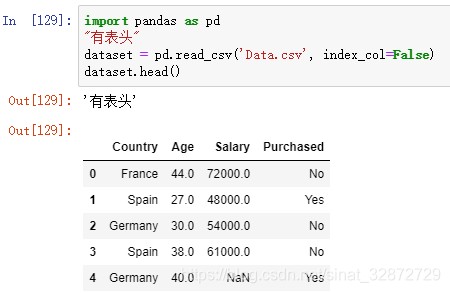
设置header=none
对有表头的数据设置 header=none则会报错:
对无表头的数据,则需设置 header=none,否则第一行数据被作为表头:
思考
pandas是如何识别或区分数据和表头名称的 ?
- 对于
index_col来说,若数据都是相同类型,比如数值型,则表示无index,输出默认index为0,1,2,…;若数据第一列为字符,其他列为数值,则会将第一列视为index;若设置index_col=false, 则表示无index(默认将0, 1, 2,…作为数据的index) - 对
header,当第一行为字符,则第一行默认为表头;当第一行与其他数据类型相同时,也会把第一行当作表头,所以无表头时应设置header=none
header传入list参数(元素代表取对应行号)怎么用?
read_csv的参数skip_blank_lines=true会忽略注释行和空行,其中注释行是用什么符号注释的?
pandas.read_csv(myfile, sep='\t', comment='#', skip_blank_lines=true)  # 可注释掉"#"起始的行和空行,默认是跳过空行的
pandas.read_csv(myfile, sep='\t', comment='##', skip_blank_lines=true) # 报错,注释字符只能是一个?
总结
以上为个人经验,希望能给大家一个参考,也希望大家多多支持代码网。




发表评论