
 我要评论
实际工作中,一份完整的汇报往往由多个人分别准备:有人写背景,有人写方案,有人写数据,最后需要把几份演示文稿合成一个文件。手动复制粘贴幻灯片不仅费时,还容易丢失主题、字体和动画等格式信息。用代码来合并则既快又稳——只需指定源文件与合并顺序,剩下的交给库处理。本文介绍如何使用 spire.presentation 在 python 中完成三种典型的合并:整体追加、挑选页合并到新文稿,以及把幻灯片插入到指定位置。
为什么需要合并演示文稿
合并幻灯片在以下场景中出现得非常频繁:
- 多人协作汇总:团队成员各自准备的章节,最终要按汇报顺序拼成一份完整材料。
- 按场合裁剪内容:同一套素材面对不同听众,需要从多份文件里各取几页重新组装。
- 批量归档:把多份零散的演示文稿统一收进一份存档文件,方便分发和管理。
与手动复制相比,脚本合并的真正优势在于可复现与可扩展:合并规则一旦写好,素材更新后重跑一遍即可得到同样的结果,几十份文件的合并也只是多跑几次循环的事。
环境准备
本文使用 spire.presentation for python 来合并演示文稿。合并的核心手段是把幻灯片对象从一份文稿的 slides 集合转移到另一份,通过 appendbyslide 追加到末尾,或通过 insert 插入到指定位置。通过以下命令安装:
pip install spire.presentation
安装完成后,在脚本中导入所需模块即可:
from spire.presentation.common import *
from spire.presentation import *
将一份演示文稿整体追加到另一份末尾
最常见的合并方式是"把 b 文件整个接到 a 文件后面"。做法是分别加载两份文稿,遍历源文稿的所有幻灯片,逐张调用 appendbyslide 追加到目标文稿末尾。这样合并后的幻灯片会保留原有的内容与格式。
from spire.presentation.common import *
from spire.presentation import *

inputfile_1 = "文档1.pptx"
inputfile_2 = "文档2.pptx"
outputfile = "clonepptatendofanother.pptx"

# 加载目标文稿与源文稿
destppt = presentation()
destppt.loadfromfile(inputfile_2)
sourceppt = presentation()
sourceppt.loadfromfile(inputfile_1)

# 遍历源文稿的全部幻灯片,逐张追加到目标文稿末尾
for slide in sourceppt.slides:
    destppt.slides.appendbyslide(slide)

# 保存合并结果
destppt.savetofile(outputfile, fileformat.pptx2013)
destppt.dispose()
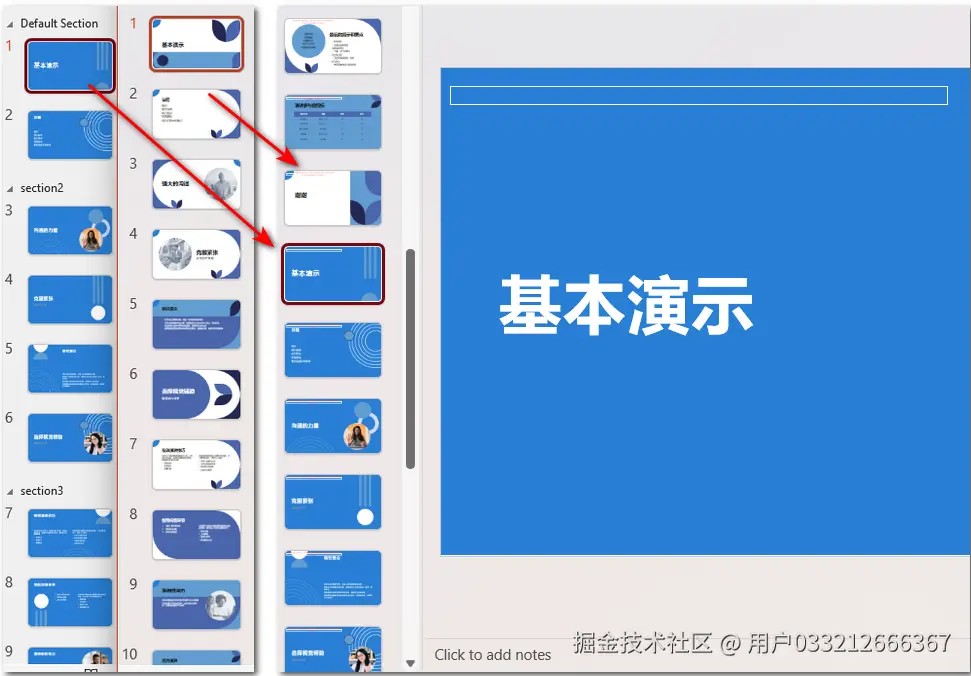
这里的关键是 appendbyslide:它接收一张幻灯片对象,把这张幻灯片复制追加到目标 slides 集合的末尾。用 for slide in sourceppt.slides 遍历,就相当于把整份文件"搬"了过去。合并完成后保存的是目标文稿,源文稿本身不受影响。
挑选幻灯片合并到新文稿
更多时候我们并不想要对方的全部页面,而是想从几份文件里各挑一部分,重新组装成一份新文稿。做法是先创建一个空白的 presentation,删掉它自带的默认幻灯片,再从各来源文稿中挑选需要的幻灯片逐张 appendbyslide 进来。
from spire.presentation.common import *
from spire.presentation import *

inputfile_1 = "文档1.pptx"
inputfile_2 = "文档2.pptx"
outputfile = "mergeselectedslides.pptx"

# 创建新文稿,并移除其自带的默认幻灯片
ppt = presentation()
ppt.slides.removeat(0)

# 加载两份来源文稿
ppt1 = presentation()
ppt1.loadfromfile(inputfile_1)
ppt2 = presentation()
ppt2.loadfromfile(inputfile_2)

# 把 ppt1 的全部幻灯片追加进新文稿
for i, unuseditem in enumerate(ppt1.slides):
    ppt.slides.appendbyslide(ppt1.slides[i])

# 只追加 ppt2 中的第二张幻灯片
ppt.slides.appendbyslide(ppt2.slides[1])

# 保存合并结果
ppt.savetofile(outputfile, fileformat.pptx2013)
ppt.dispose()
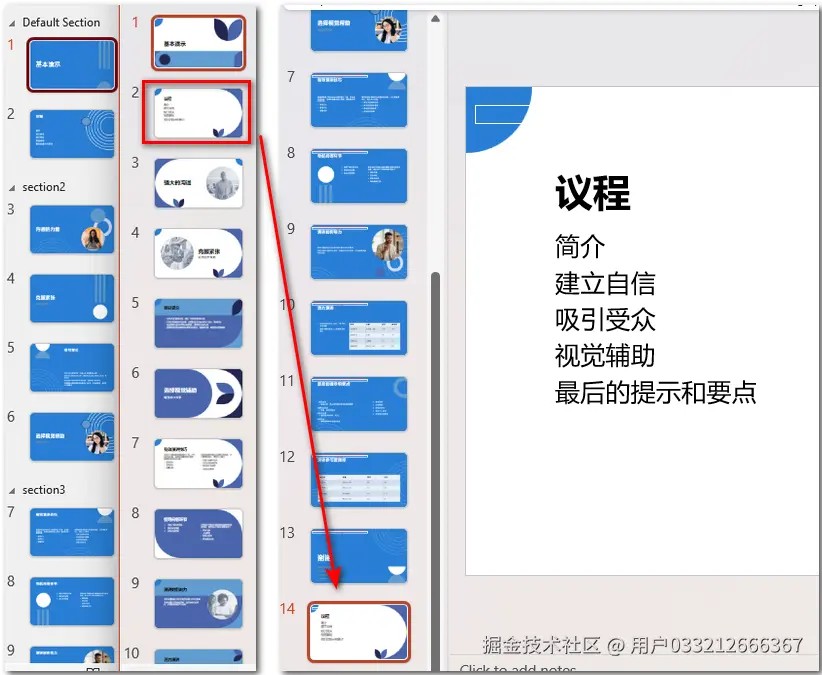
两点细节值得注意:一是新建的 presentation() 默认带一张空幻灯片,合并前要先用 removeat(0) 把它删掉,否则成品开头会多出一页空白页;二是挑选来源时用索引即可精确控制,例如 ppt2.slides[1] 只取第二张,配合多个来源文件的追加顺序,就能自由决定新文稿的页面编排。
把幻灯片插入到指定位置
appendbyslide 只能往末尾追加,如果希望把某个幻灯片插进已有文稿的中间位置,就要用 slides.insert。它接受插入位置索引和幻灯片对象两个参数,常用来把别处的一页"补"进当前文稿的某个环节。
from spire.presentation.common import *
from spire.presentation import *

inputfile_1 = "文档1.pptx"
inputfile_2 = "文档2.pptx"
outputfile = "cloneslidetoanotherppt.pptx"

# 加载目标文稿
presentation = presentation()
presentation.loadfromfile(inputfile_2)

# 加载来源文稿,取出其中的第一张幻灯片
ppt1 = presentation()
ppt1.loadfromfile(inputfile_1)
slide1 = ppt1.slides[0]

# 把该幻灯片插入到目标文稿的索引 1 处(即第二张)
index = 1
presentation.slides.insert(index, slide1)

# 保存结果
presentation.savetofile(outputfile, fileformat.pptx2010)
presentation.dispose()
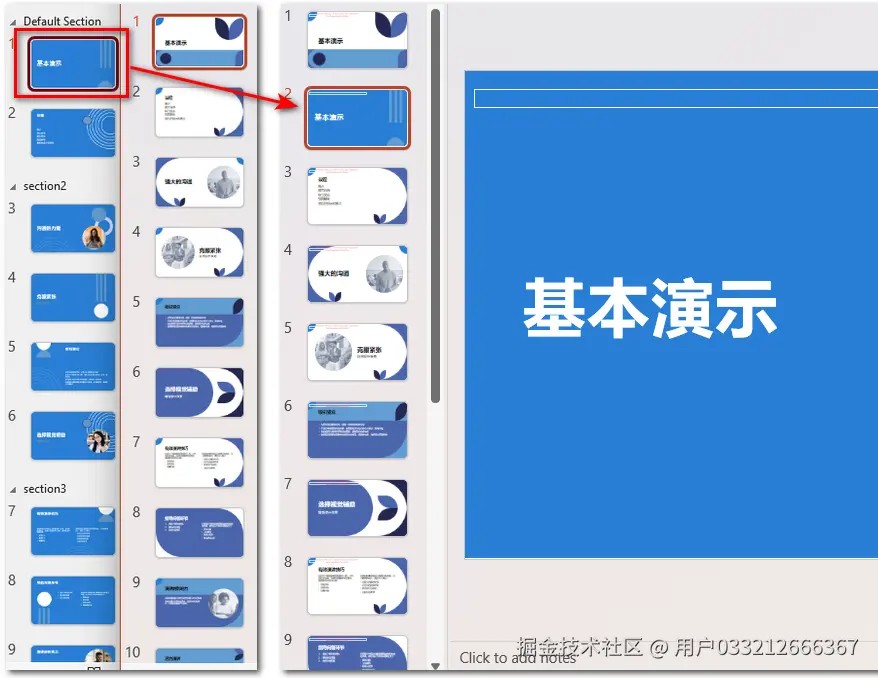
insert(1, slide1) 表示把来源文稿的第一张幻灯片插到目标文稿第二页的位置,原有页面依次后移。追加用 appendbyslide、定点插入用 insert,两者配合就能覆盖"接在后面"和"插进中间"两类合并需求。
综合示例:批量合并文件夹下的演示文稿
把整体追加的方法放进循环,就能一次性把某个目录下的所有演示文稿按文件名顺序合并成一份。下面遍历指定文件夹,把每个 .pptx 文件的全部幻灯片依次追加到结果文稿中。
import os
from spire.presentation.common import *
from spire.presentation import *

ppt_dir = "./demos/data/ppts"
outputfile = "mergedall.pptx"

# 以文件夹中第一个文件作为合并起点
files = sorted(f for f in os.listdir(ppt_dir) if f.lower().endswith(".pptx"))
result = presentation()
result.loadfromfile(os.path.join(ppt_dir, files[0]))

# 把其余文件的幻灯片逐张追加进来
for file_name in files[1:]:
    source = presentation()
    source.loadfromfile(os.path.join(ppt_dir, file_name))
    for slide in source.slides:
        result.slides.appendbyslide(slide)
    source.dispose()

result.savetofile(outputfile, fileformat.pptx2013)
result.dispose()
print(f"已合并 {len(files)} 份演示文稿。")
这个脚本有两个工程上的要点:一是用 sorted 保证文件按名称顺序合并,页序稳定可预期;二是每份源文稿用完立即 dispose(),避免同时打开大量文件导致内存占用过高。如果只需要其中几页,在循环里加一层索引筛选,把 appendbyslide 换成对选定幻灯片的追加即可。
实用技巧
- 区分追加与插入:整份文件合并用
appendbyslide循环;要控制页面在中间的位置时用slides.insert(index, slide)。 - 新文稿先删默认页:
presentation()新建后自带一张空幻灯片,用它做合并容器前先removeat(0),避免成品开头多一页空白。 - 用索引挑选页面:来源文稿的任意一页都能通过
slides[i]精确取得,多来源合并时按追加顺序即可编排成品结构。 - 大批量合并注意资源:循环合并多份文件时,每份源文稿处理完立即
dispose();文件特别多时分批处理更稳妥。 - 合并后统一检查格式:不同来源的主题、字体可能不一致,合并完成后建议在 powerpoint 中检查一遍版式,必要时统一应用一个母版。
总结
本文介绍了如何使用 python 和 spire.presentation 合并 powerpoint 文件,核心内容如下:
- 遍历源文稿的
slides并逐张调用appendbyslide,把一份演示文稿整体追加到另一份末尾 - 新建空白文稿并
removeat(0)移除默认页后,从多份文件中挑选幻灯片组装成新文稿 - 使用
slides.insert(index, slide)把幻灯片插入到合并结果的指定位置 - 将追加逻辑放入循环并配合
dispose释放资源,可批量合并整个文件夹的演示文稿
掌握这几个集合操作后,无论是多人协作的章节汇总、按听众裁剪重组内容,还是批量归档零散文稿,都可以交给脚本完成。在实际项目中,建议先明确合并的页序规则,再决定用追加还是插入,最后对合并结果做一次版式检查,这样产出的文稿才能既完整又整洁。
以上就是使用python实现轻松合并多个powerpoint文件的代码详解的详细内容,更多关于python合并多个powerpoint文件的资料请关注代码网其它相关文章!



发表评论