
 我要评论
pdf 因其固定的版式和良好的跨平台一致性,非常适合分发和打印;但它本质上是一种"只读"的成品格式,想要修改其中的文字、调整段落,或把内容复用进其他文档时却很不方便。把 pdf 转换成可编辑的 word 文档(.docx 或 .doc),就能直接在原文件基础上增删改,或把内容二次排版到报告、论文里。本文介绍 spire.pdf 提供的两种转换路径:一行代码的基础转换,以及借助 pdftodocconverter 在转换时同时设置 word 文档属性的进阶用法。
为什么需要将 pdf 转换为 word
在以下场景中,直接编辑 pdf 成本高、效果差,而转换成 word 往往是更顺手的选择:
- 修改或补充内容:pdf 里的错别字、过期数据想改,但源文件已丢失,转成 word 后即可就地编辑。
- 内容复用:把合同、说明书中的段落复制进自己的方案或论文,word 的排版比从 pdf 复制更干净。
- 二次排版:原始 pdf 的版式不理想,转成 word 后能重新调整字体、行距与图文位置。
- 接入既有工作流:许多企业的审批、归档系统以 word 为准,收到的 pdf 需要先还原成可编辑文档。
与"截图再 ocr"或在线转换工具相比,用代码批量转换的优势在于可复现、可自动化,且能嵌入到更大的文档处理流水线中。
环境准备
本文使用 spire.pdf for python 完成 pdf 到 word 的转换。该库同时支持输出为现代 .docx 与旧版 .doc 格式,并提供了专门的转换器类来定制输出文档的属性。先通过 pip 安装:
pip install spire.pdf
安装完成后,在脚本中导入所需模块即可开始:
from spire.pdf.common import *
from spire.pdf import *
其中 fileformat 等枚举来自 spire.pdf.common,后续转换时直接引用即可。
将 pdf 转换为 docx(最常用)
.docx 是 office 2007 之后的默认格式,兼容性最好、体积也更小,绝大多数转换需求都会选择它。spire.pdf 把转换逻辑直接封装在了 pdfdocument 的 savetofile 方法里,只需在第二个参数指定 fileformat.docx,即可在保存的同时完成格式转换。
from spire.pdf.common import *
from spire.pdf import *

inputfile = "./demos/data/todocx.pdf"
outputfile = "todocx.docx"

# 加载待转换的 pdf 文档
doc = pdfdocument()
doc.loadfromfile(inputfile)

# 以 docx 格式保存,即完成 pdf 到 word 的转换
doc.savetofile(outputfile, fileformat.docx)
doc.close()
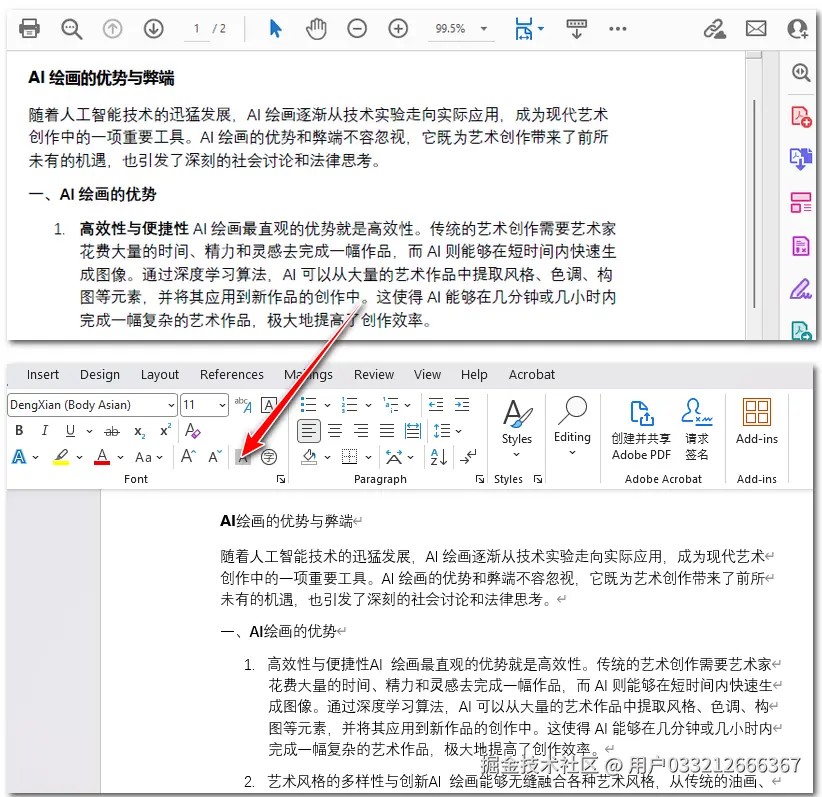
这段代码先 loadfromfile 载入 pdf,再调用 savetofile 并传入 fileformat.docx——引擎会在保存过程中自动把页面内容重排为 word 的段落、表格与图片。转换结束后记得调用 close() 释放文档资源,尤其在循环批量处理多份文件时,及时释放能避免内存占用过高。
将 pdf 转换为旧版 doc 格式
如果你的下游系统或协作者仍在使用较老的 word(例如 word 2003 及更早版本),.docx 可能无法直接打开。这时可以把输出格式换成 fileformat.doc,得到兼容性更强的旧版 word 文档。
from spire.pdf.common import *
from spire.pdf import *

inputfile = "./demos/data/todoc.pdf"
outputfile = "todoc.doc"

# 加载 pdf 文档
doc = pdfdocument()
doc.loadfromfile(inputfile)

# 以 doc 格式保存,兼容旧版 word
doc.savetofile(outputfile, fileformat.doc)
doc.close()
除了 fileformat.doc 这一枚举值不同,其余调用与转换为 docx 完全一致。在决定用哪种格式时,可以遵循一个简单的原则:面向现代 office 或需要更小体积选 .docx,要兼容老旧环境或特定遗留系统才退而选 .doc。
转换时设置 word 文档属性
基础转换已经能满足大多数场景,但有时我们希望输出的 word 文档自带标题、标签、作者等元数据,方便在文件管理器或企业系统中检索。spire.pdf 提供 pdftodocconverter 类,它在转换前暴露了一个 docxoptions 属性,允许我们直接填写 word 文档的内置属性,再调用 savetodocx 一次性输出带元数据的文档。
from spire.pdf.common import *
from spire.pdf import *

inputfile = "./demos/data/sample.pdf"
outputfile = "converttowordsettingproperties-result.docx"

# 创建 pdf 到 word 的转换器
converter = pdftodocconverter(inputfile)

# 在转换前设置输出 word 文档的属性
converter.docxoptions.title = "pdftodocx"
converter.docxoptions.subject = "设置文档属性"
converter.docxoptions.tags = "测试标签"
converter.docxoptions.categories = "pdf"
converter.docxoptions.commments = "仅供测试使用"
converter.docxoptions.authors = "e-iceblue 团队"
converter.docxoptions.lastsavedby = "e-iceblue 团队"

# 执行转换并保存为带属性的 docx
converter.savetodocx(outputfile)
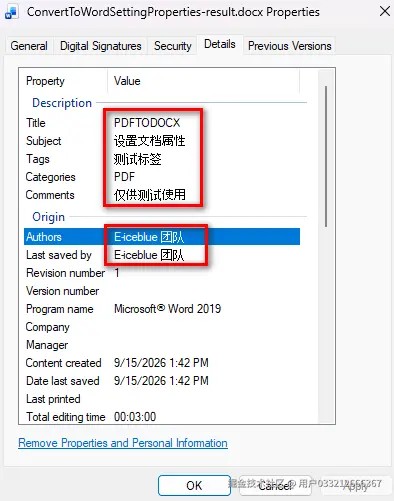
docxoptions 下可设置的字段相当丰富:除了上面示例中的标题(title)、主题(subject)、标签(tags)、类别(categories)、备注(commments)、作者(authors)与最后保存者(lastsavedby),还支持修订号(revision)、版本(version)、程序名(programname)、公司(company)、管理者(manager)等。把这些信息在转换阶段就写好,可以避免事后再用 word 或另一套库去补元数据,让文档一生成就符合归档规范。
综合示例:批量转换文件夹下的 pdf
把上面的基础方法放进循环,就能一次性把某个目录里的所有 pdf 转成 word。下面遍历指定文件夹,对每个 .pdf 文件调用 savetofile(..., fileformat.docx),并沿用统一的命名规则输出到结果目录。
import os
from spire.pdf.common import *
from spire.pdf import *

pdf_dir = "./demos/data/pdfs"
output_dir = "./output"

# 确保输出目录存在
if not os.path.exists(output_dir):
    os.makedirs(output_dir)

# 逐个转换目录下的 pdf 文件
for file_name in os.listdir(pdf_dir):
    if not file_name.lower().endswith(".pdf"):
        continue

    input_path = os.path.join(pdf_dir, file_name)
    output_path = os.path.join(output_dir, file_name.replace(".pdf", ".docx"))

    doc = pdfdocument()
    doc.loadfromfile(input_path)
    doc.savetofile(output_path, fileformat.docx)
    doc.close()
    print(f"已转换:{file_name} -> {os.path.basename(output_path)}")

print("全部转换完成。")
这段脚本的关键点在于"用完即关":loadfromfile 与 savetofile 之间不要做与当前文档无关的重逻辑,每次循环结束都调用 close(),这样即使处理成百上千份文件,内存也始终处于可控范围。如果需要带元数据,只要把循环体里的 pdfdocument 换成 pdftodocconverter 并设置 docxoptions 即可,整体结构不变。
实用技巧
- 优先选 docx:除非明确要兼容 word 2003 之前的版本,否则一律输出
.docx,体积更小、解析更可靠。 - 先验证单份再批量:批量前先用一两份有代表性的 pdf(含表格、图片、中文)试转,确认版式还原度达标,再跑全量。
- 中文与字体:pdf 中的中文字体在转换后一般会映射为 word 可识别的字体;若个别字体丢失,可在转换后用 word 或 spire.doc 做一次字体替换。
- 大文件注意资源:页数很多的 pdf 转换时占用内存较高,建议分批处理并在每份
close()后稍作间隔,避免单次占用过大。 - 用 docxoptions 规范归档:当转换结果要进入文档管理系统时,提前在
docxoptions写好书名、标签与作者,比事后补元数据更高效。
总结
在实际的 pdf 转 word 开发中,灵活运用这些转换方法能显著提升文档处理的效率。最稳健的做法是在项目初始化阶段,先通过单份文件验证排版与样式效果,再配合文档属性配置统一规范,最后通过循环脚本完成大批量文件的自动化处理。这种“先测试验证、后统一规范、再批量执行”的开发流程,既能保证转换质量,也能为后续的文档二次编辑与自动化集成提供良好的基础。
以上就是使用python实现将pdf转换为单个或多个word的完整指南的详细内容,更多关于python pdf转word的资料请关注代码网其它相关文章!

发表评论