
 我要评论
python 高级部分和正则表达式是处理复杂文本和提升代码效率的利器,两者结合能解决很多实际问题。下面按“正则表达式核心用法 → python高级语法 → 实战场景”的顺序给你梳理清楚。
1.python迭代器
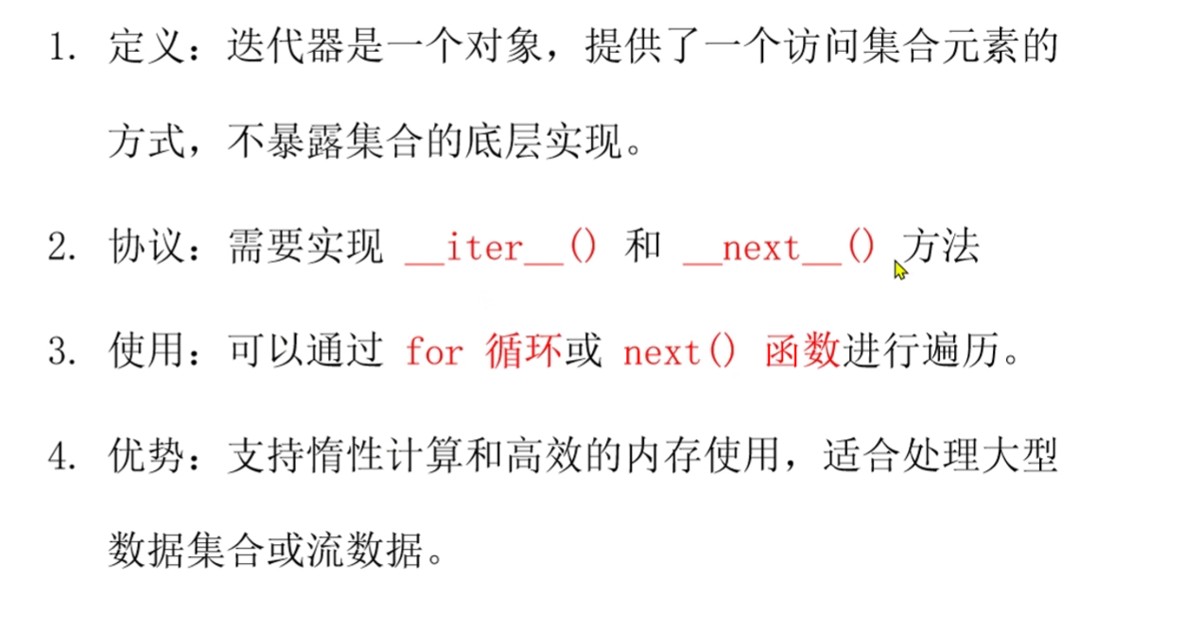
迭代器(iterator):是 python 中的一种对象,用于在数据集合中逐个访问元素,而不需要暴露数据集合的底层实现。它提供了一种遍历元素的标准方式,适用于任何支持迭代的数据集合,如:列表,元组等,range()就是一个迭代器
迭代器是一个实现了 _ _iter_ _() 和 _ _next_ _()方法的对象,使得可以逐步遍历它的元素
特点:
- 手动管理:需要显示地实现 _ _iter_ _()和 _ _next_ _()方法
- 状态管理:迭代器需要自己管理迭代的状态(属性),包括当前位置和结束条件
- 内存使用:内存使用取决于迭代器的实现,通常是惰性计算(按需生成数据)
1.1 创建迭代器
通过给类添加 _ _iter_ _() 和 _ _next_ _()方法便可以定义一个迭代器类
#定义一个迭代器类
class myiterator(object):
    1. 通过__init__魔法方法,初始化属性,指定范围
    def __init__(self, start, end):
        self.current = start #当前值,默认为开始值
        self.end = end       #结束值
    #2. 通过重写__iter__魔法方法,返回当前对象(即迭代器对象)
    def __iter__(self):
        return self
    #3. 通过重写__next__魔法方法,返回当前值,并更新当前值
    def __next__(self):
        #3.1 判断当前值范围是否合法
        if self.current > self.end :
            raise stopiteration
        #3.2 若当前值合法,返回当前值并更新
        value = self.current
        self.current += 1
return value注意:迭代器只能遍历一次
1.2 使用迭代器
1.2.1 for循环
#1. 实例化迭代器对象
my_iter = myiterator(1, 10)
#2. 使用for循环遍历迭代器对象
for num in my_iter: #1 2 3 4 5 6 7 8 9 10
    print(num)
1.2.2 next()函数
print(next(my_generator)) #1
print(next(my_generator)) #2
print(next(my_generator)) #3
next(iterator, default)函数的使用:
- iterator:迭代器对象
- default(可选):迭代器耗尽时返回这个默认值
作用:接收迭代器,取出下一个元素;元素耗尽,默认抛出 stopiteration;如果指定 default 参数,则返回 default 不再抛异常。
#定义一个迭代器
class myiterator(object):
    def __init__(self, start, end):
        self.current = start
        self.end = end
    def __iter__(self):
        return self
    def __next__(self):
        if self.current >= self.end :
            raise stopiteration
        value = self.current
        self.current += 1
        return value
#使用迭代器
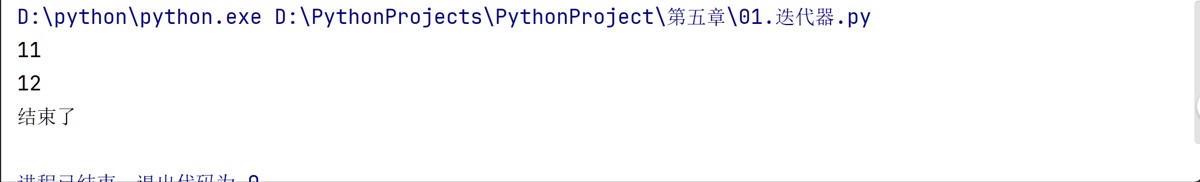
my_iter2 = myiterator(11, 13)
print(next(my_iter2, "结束了"))
print(next(my_iter2, "结束了"))
print(next(my_iter2, "结束了"))
结果如下:
小结:
2.python生成器
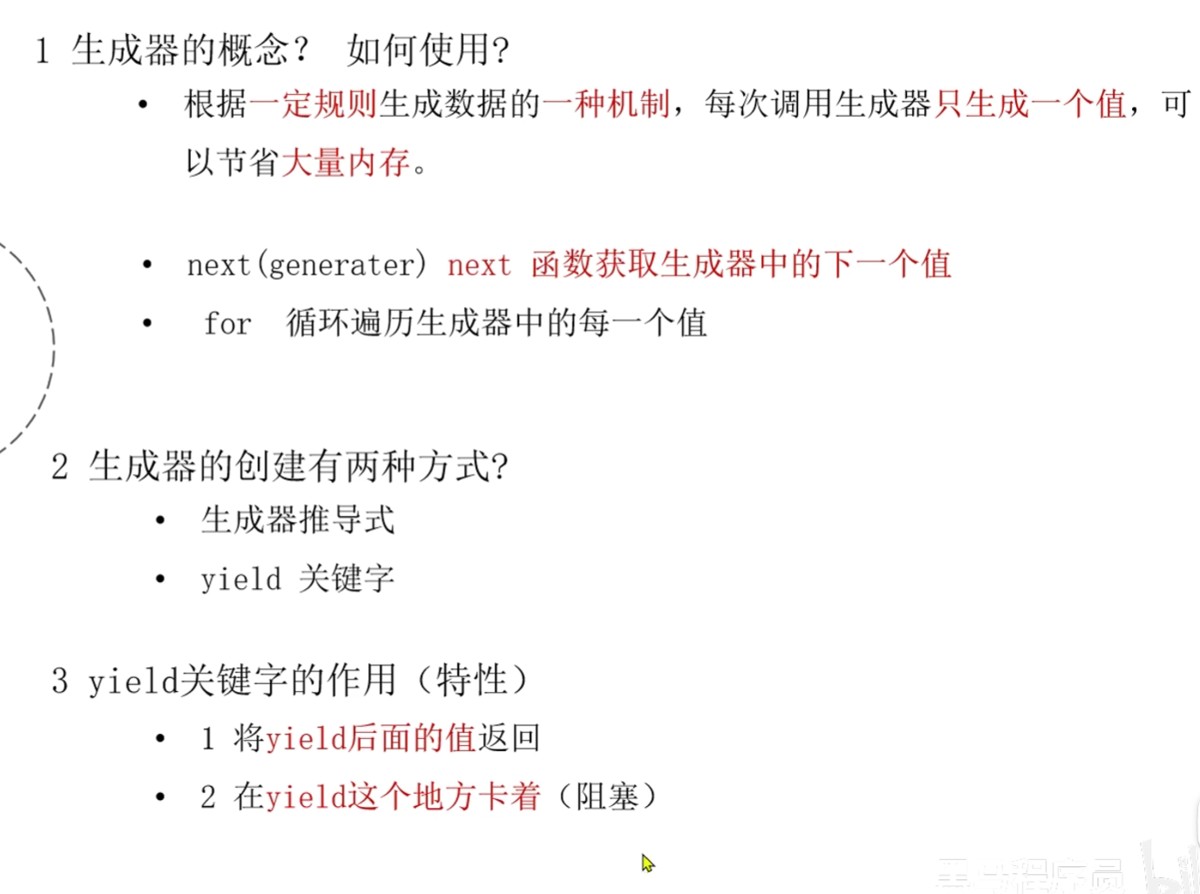
生成器:根据规则循环生成数据,当条件不成立时则生成数据结束。即:数据不是一次性全部生成出来的,而是使用一个,再生成一个,可以节约大量的内存(目的)
2.1 创建生成器的方式
2.1.1 生成器推导式
my_generator = (i for i in range(10))
print(type(my_generator))  # <class 'generator'>
通俗来讲:其实就是与列表推导式,集合推导式类似的元组推导式,不过一般来讲,没有元组推导式这个概念
2.1.2 yield关键字
只要在 def 函数里面看到有 yield 关键字那么就是生成器
#1. 定义函数,存储到生成器中,并返回
def my_generator():
    #1.1 循环
    for i in range(1,11):
        #1.2 使用yield关键字创建生成器
        #yield在这里做了三件事:1.创建生成器对象 2.把值存储到生成器中 3.返回生成器
        yield i
#2. 调用函数,获取生成器对象
gen = my_generator()
print(type(gen))  # <class 'generator'>
for i in gen:
    print(i)
2.2 从生成器中获取元素
2.2.1 for循环
for num in my_generator:
    print(num)
2.2.2 next()函数
print(next(my_generator)) #1
print(next(my_generator)) #2
print(next(my_generator)) #3
2.3 案例实现
案例:基于传入的数据(歌词),创建生成器,生成批次歌词
需求:基于文件中周杰伦的歌词,创建生成器,根据传入的歌词条数,生成歌词批次
import math
#定义一个歌词生成器
def lyric_generator(batch_size):
    """
    自定义的歌词批量生成器
    :param batch_size: 每批次的歌词行数
    :return: 每批次的歌词
    """
    #1. 获取歌词文件中的所有数据(以行为单位)
    with open("./data/周杰伦歌词.txt", "r", encoding = "utf-8") as f:
        lines = f.readlines()
    #2. 计算总批次
        total_batches = math.ceil(len(lines) / batch_size)   #向上取整
    #3. 循环获取每批次的歌词
    for i in range(total_batches):
        #3.1 创建歌词生成器,每次返回一个批次的歌词
        yield lines[i*batch_size:(i+1)*batch_size]
if __name__ == "__main__":
    #调用生成器函数,获取生成器对象
    gen = lyric_generator(3)
    #遍历生成器对象,获取每批次的歌词
    for i in gen:
        print(i)
2.4 小结
2.5 生成器与迭代器对比
1.实现方式
迭代器:需要实现 iter() 和 next() 方法,手动管理迭代状态
生成器:通过 yield 关键字简化实现,自动管理迭代状态
2.代码复杂度
迭代器:通常需要更多的代码来管理状态和迭代逻辑
生成器:代码更简洁,更容易理解和维护
3.性能与内存
迭代器:性能和内存使用取决于实现,通常也是惰性计算
生成器:由于使用了 yield,内存使用和性能优化自动管理,适合处理大数据或流数据
4.使用场景
迭代器:适合需要对迭代过程进行高度控制,或者需要自定义复杂的迭代逻辑时使用
生成器:适合需要简洁地生成序列数据,尤其是在处理大数据或需要按需生成数据时,能够节省内存和提高性能
注意:生成器本质上就是一种特殊的迭代器
3.property属性(方法属性化)
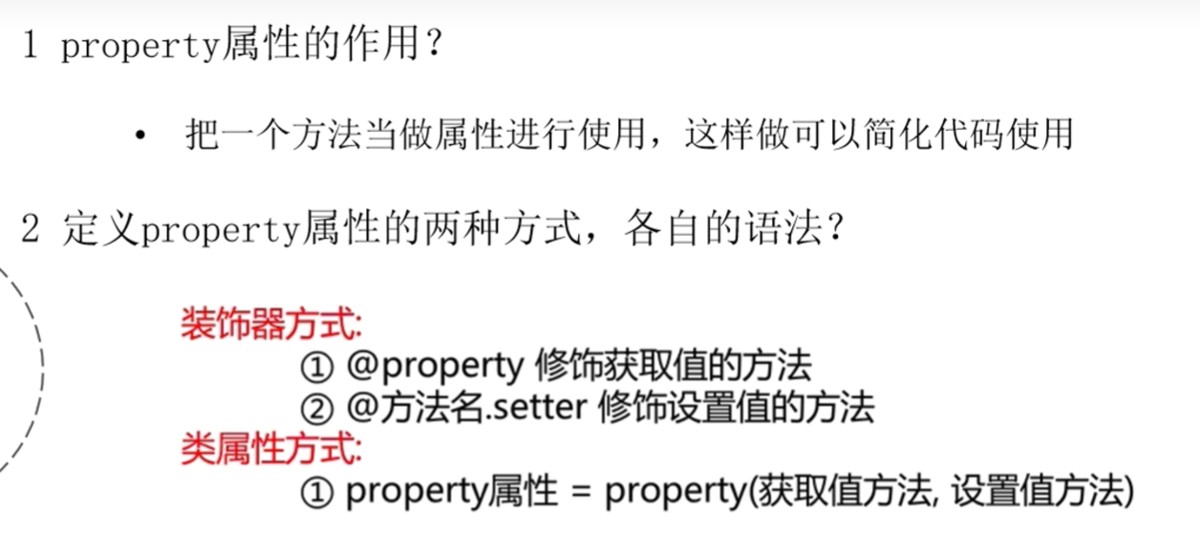
property属性:负责把一个函数(方法)当作属性来用,这样可以简化代码使用
3.1 定义 property 属性
定义 property 属性有两种方式:
- 装饰器方式
- 类属性方式
3.1.1 装饰器方式
class women(object):
    def __init__(self):
        self.__age = 18
    #获取私有属性
    @property
    def age(self):          #公有获取私有属性方式
        return self.__age
    #修改私有属性
    @age.setter
    def age(self, new_age): #公有修改私有属性方式
        self.__age = new_age
if __name__ == "__main__":
    w1 = women()
    print(w1.age) #18
    w1.age = 20
print(w1.age) #20- @property:修饰读取方法
- @方法名.setter:修饰修改值方法(装饰器必须在 @property 之后定义,并且两个方法名字完全一样)
在此之后,就可以直接使用 对象.函数名 来当做对象的属性使用
3.1.2 类属性方式
class women(object):
    def __init__(self):
        self.__age = 18
    def get_age(self):
        return self.__age
    def set_age(self, new_age):
        self.__age = new_age
    #类属性方式定义 property 属性
    #将上述的获取值和修改值的公共方法封装为类属性
    age = property(get_age, set_age)
if __name__ == "__main__":
    w1 = women()
    print(w1.age) #18
    w1.age   = 20
print(w1.age) #20- 类属性 = property(获取值方法名,设置值方法名)
注意:使用类属性定义 property 属性时获取值方法和设置值方法必须要求不同名
3.2 小结
4.正则表达式
正则表达式:regular expression,简称 re,正确的,符合特定规则的字符串。用来描述,匹配字符串中符合特定规则的字符序列。相当于一种模式匹配工具,允许用户通过简洁的语法进行复杂文本的搜索,匹配,提取和替换工作
4.1 正则表达式语法
正则表达式的写法多种多样,具体的语法如下:
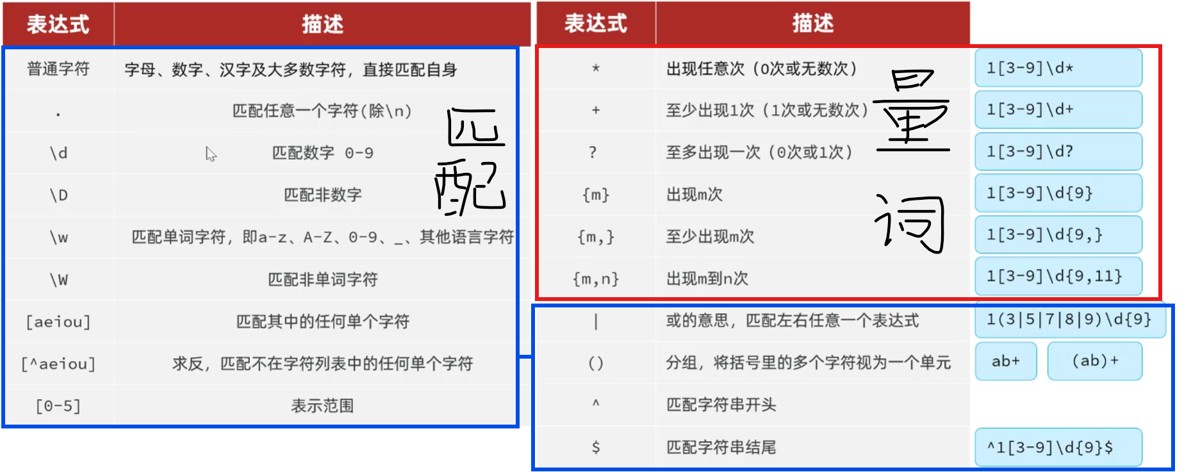
注意:字符串转义符的影响
- "字符串":python 普通字符串里,\ 是字符串转义符:
- \n → 换行
- \t → tab
- \\ → 代表一个字面的 \
比如:如果想把 \d 传给正则引擎,普通字符串必须写成 "\\d":
- r"字符串":关闭 python 字符串转义,获得原始字符串,\ 就是普通反斜杠,不再做任何转义处理
补充:
- \. :取消 . 的特殊含义,只表示一个普通的 .
- \s:匹配空白,即空格,tab键等(一个 \s 只能匹配一个空格或tab)
- \s:匹配非空白
- \数字:反向引用
量词注意事项:
- 量词无法独立使用,必须用来修饰字符
- 量词{m,n}:中间不要加空格
反向引用:
\数字:反向引用,用来引用前面第 num 个捕获分组匹配到的文本
1.什么是捕获分组?
括号() 在正则里,一是分组,二是捕获,会把括号内匹配到的内容存起来,按顺序编号:从 \1 开始
2.反向引用的作用
- 引用的是分组匹配到的真实文本,不是分组里的正则表达式
r"([a-z])\1"
含义:匹配一个小写字母,后面跟和它一模一样的字母
- 方便直接获取分组内容
import re
email = "1975150458@qq.com"
result = re.match(r"[a-z|a-z|0-9|_]{4,20}@(163|qq|126)\.com$", email)
print(result.group(0) if result else "匹配失败") #获取第0组信息,即整个匹配到的字符串
print(result.group(1) if result else "匹配失败") #获取第1组信息,即:163
代码示例如下:
import re
s1 = '18809090000是我的手机号,你记住了吗?我的另一个手机号是18800008888,两个qq号分别是15500008888 和 13809091293821,邮箱为python666@163.com,你记住了吗?'
#正则表达式
print(re.findall(r"188.*",s1)) # .匹配任意字符,*匹配其前面字符0次或多次
print(re.findall(r"188.?",s1)) # .匹配任意字符,?匹配其前面字符至多1次
print(re.findall(r"188.+",s1)) # .匹配任意字符,+匹配其前面字符至少1次
print(re.findall(r"188\d{8}",s1)) # \d匹配任意数字,{8}匹配其前面字符8次
print(re.findall(r"155\d{6,10}",s1)) # \d匹配任意数字,{6,10}匹配其前面字符6到10次
print(re.findall(r"155\d{6,}",s1)) # \d匹配任意数字,{6,}匹配其前面字符6次或更多
print(re.findall(r"1[38]\d{8}",s1)) # 1开头,第2位是3或8,\d匹配任意数字,{8}匹配其前面字符8次
print(re.findall(r"1[^38]\d{8}",s1)) # 1开头,第2位是{3,8}以外的数字,\d匹配任意数字,{8}匹配其前面字符8次
print(re.findall(r"1[3-9]\d{8}",s1)) # 1开头,第2位是3-9之间的数字,\d匹配任意数字,{8}匹配其前面字符8次
print(re.findall(r"^1[3-9]\d{9}",s1)) # ^匹配字符串开头为1,第2位是3-9之间的数字,\d匹配任意数字,{9}匹配其前面字符9次
print(re.findall(r"^1[3-9]\d{9}$",s1)) # ^匹配字符串开头为1,第2位是3-9之间的数字,\d匹配任意数字,{9}匹配其前面字符9次,$匹配字符串结尾
print(re.findall(r"\w+@\w+\.\w+",s1,)) #\w匹配任何单词字符(a-z,a-z,0-9,_,其他语言字符),\.转义字符只表示匹配.
print(re.findall(r"\w+@\w+\.\w+",s1,re.ascii)) #re.ascii限制只匹配ascii中字符
s2 = "现在的时间是2026-08-18 19:06:10,今天的天气还可以,气温是28度"
print(re.findall(r"\d{4}-\d{2}-\d{2}",s2))
print(re.findall(r"(\d{4})-(\d{2})-(\d{2})",s2))  #封装元组
4.2 正则表达式操作
| 函数 | 作用 | 返回值 |
|---|---|---|
| re.match(pat,str) | 只从字符串开头匹配(第一个) | match 对象 / none |
| re.search(pat,str) | 从任意位置开始匹配(第一个) | match 对象 / none |
| re.findall(pat,str) | 找出全部匹配结果 | list 列表 |
re.sub(pat,str2,str1 ) | 将字符串str1中匹配到的内容全部替换为str2 | 字符串 str |
- pat:正则表达式
- str:文本字符串
4.2.1 字符串match匹配
1.导入模块
import re
2.正则表达式与要检验的字符串进行匹配(从开头)
result = re.match("正则表达式", "要校验的字符串")3.获取匹配结果
if result:
    print(result.group())
else:
    print("匹配失败")
相关代码如下:
import re
s1 = '18809090000是我的手机号,你记住了吗?我的另一个手机号是18800008888,两个qq号分别是155998992 和 18809091293821,你记住了吗?'
result = re.match(r"1[3-9]\d{9}",s2)
#match--从字符串的开头开始匹配(只会匹配第一个匹配项),返回 match对象/none
if result:
    print(result.group()) #获取到匹配的结果
    print(result.span()) #匹配项的索引
    print(result.start()) #匹配项的开始索引
    print(result.end()) #匹配项的结束索引
else:
    print("匹配失败")
4.2.2 字符串search匹配
1.导入模块
import re
2.正则表达式与要检验的字符串进行匹配(从任意位置)
result = re.search("正则表达式", "要校验的字符串")3.获取匹配结果
if result:
    print(result.group())
else:
    print("匹配失败")
相关代码如下:
import re
s2 = '我的手机号是18809090000,你记住了吗?我的另一个手机号是18800008888,两个qq号分别是155998992 和 18809091293821,你记住了吗?'
#search--从字符串的任意位置开始匹配(只会匹配第一个匹配项),返回match对象
result = re.search(r"1[3-9]\d{9}",s2)
if result:
    print(result.group()) #获取到匹配的结果
    print(result.span()) #匹配项的索引
    print(result.start()) #匹配项的开始索引
    print(result.end()) #匹配项的结束索引
else:
    print("匹配失败")
4.2.3 字符串findall匹配
1.导入模块
import re
2.正则表达式与要检验的字符串进行匹配
result = re.findall("正则表达式", "要校验的字符串")3.获取匹配结果
print(result)
相关代码如下:
import re
s2 = '我的手机号是18809090000,你记住了吗?我的另一个手机号是18800008888,两个qq号分别是155998992 和 18809091293821,你记住了吗?'
#findall--返回所有匹配项的列表,返回列表
result = re.findall(r"1[3-9]\d{9}","s2")
print(result)
4.2.4 字符串compile + sub替换
1.导入模块
import re
2.正则表达式与要检验的字符串进行匹配
result = re.compile("正则表达式") #返回正则表达式对象
result = result.sub("替换后的内容", "要被匹配和替换的字符串")
3.获取替换结果
print(result)
新版api写法:
result = re.sub("正则表达式", 替换后的内容, 要被匹配和替换的字符串)4.3 正则表达式案例
案例1:匹配 qq:195737 这样的数据,从中提取 “qq” 和 qq号码
import re
qq_number = "qq:1319831324"
result = re.match(r"(qq):(\d+)", qq_number)
print(result.group(1,2) if result else "匹配失败")
#结果:('qq', '1319831324')
案例2:校验 html 标签
import re
"""
<html>
    <head><title>示例标题</title></head>
</html>
"""
html_s = "<html><head><title>示例标题</title></head></html>"
#方式1:最传统方式
result = re.match(r"<[a-z|a-z]{1,5}><[a-z|a-z]{1,5}><[a-z|a-z]{1,5}>.*</[a-z|a-z]{1,5}></[a-z|a-z]{1,5}></[a-z|a-z]{1,5}>", html_s)
print(result.group() if result else "匹配失败")
#方式2:使用反向引用
result = re.match(r"<([a-z|a-z]{1,5})><([a-z|a-z]{1,5})><([a-z|a-z]{1,5})>.*</\3></\2></\1>", html_s)
print(result.group() if result else "匹配失败")
#方式3:使用反向引用,同时给引用命名
result = re.match(r"<(?p<first>[a-z|a-z]{1,5})><(?p<second>[a-z|a-z]{1,5})><(?p<third>[a-z|a-z]{1,5})>.*</(?p=third)></(?p=second)></(?p=first)>", html_s)
print(result.group() if result else "匹配失败")反向引用的命名:
- 设置分组:(?p<分组名>分组内表达式)
- 引用分组:(?p=分组名)
到此这篇关于python高级与正则表达式的文章就介绍到这了,更多相关python正则表达式内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!





发表评论