
 我要评论
域(field)是 word 中的一种特殊元素,它的显示内容由域代码和域结果组成,可以根据环境或文档状态动态更新。例如页脚里的"第 x 页"、目录页码、章节引用,以及"如果数量大于 100 则显示某段文字"这种条件判断,都是通过域实现的。手动在 word 中插入域需要熟悉域代码的写法,而且当一个文档里散落着几十个域时,逐个更新很麻烦。
用 python 可以自动完成这些工作:批量插入不同类型的域、更新所有域的显示结果、读取域中的文本、删除不需要的域,甚至把域直接转换为普通文本。本文以 spire.doc for python 为例演示这些操作。
环境准备
安装 spire.doc 库:
pip install spire.doc
在脚本中引入模块:
from spire.doc import *
from spire.doc.common import *
在段落中插入一个简单的域
paragraph.appendfield() 可以从现有文档中取出一个段落,在段落末尾插入指定类型的域。下面以页码引用(pageref)域为例,域代码指定了要引用的书签名和显示格式:
document = document()
document.loadfromfile("文档.docx")
# 获取最后一个节并新建一个段落
section = document.lastsection
par = section.addparagraph()
# 插入 pageref 域并设置域代码
field = par.appendfield("pageref", fieldtype.fieldpageref)
field.code = "pageref  bookmark1 \\# \"0\" \\* arabic  \\* mergeformat"
# 更新域以获得正确的结果
document.isupdatefields = true
document.savetofile("插入域.docx", fileformat.docx)
document.close()
appendfield() 的第一个参数是域的显示文本,第二个参数是 fieldtype 枚举,用来声明域的类别。fieldtype.fieldnone 表示空域,fieldtype.fieldpageref、fieldtype.fieldmergefield 等则对应具体的域类型。插入后专门设置 code 属性,相当于手动输入域代码。
创建带条件的 if 域
if 域可以用来做条件判断,是动态文档生成中最常用的域之一。它比普通域复杂一些,需要先把 iffield 对象加入段落,再拼装条件、真值和假值三部分文本,最后补一个域结束标记:
def create_if_field(document, paragraph):
    if_field = iffield(document)
    if_field.type = fieldtype.fieldif
    if_field.code = "if "
    paragraph.items.add(if_field)
    # 条件:合并字段 count 的值大于 100
    paragraph.appendfield("count", fieldtype.fieldmergefield)
    paragraph.appendtext(" > ")
    paragraph.appendtext("\"100\" ")
    # 真值和假值
    paragraph.appendtext("\"thanks\" ")
    paragraph.appendtext("\"the minimum order is 100 units\"")
    # 添加域结束标记
    end = document.createparagraphitem(paragraphitemtype.fieldmark)
    end.type = fieldmarktype.fieldend
    paragraph.items.add(end)
    if_field.end = end
document = document()
section = document.addsection()
paragraph = section.addparagraph()
create_if_field(document, paragraph)
# 用邮件合并数据填充 count 字段
document.mailmerge.execute(["count"], ["2"])
# 更新所有域
document.isupdatefields = true
document.savetofile("if域.docx", fileformat.docx2013)
document.close()
iffield 是 field 的子类,通过 items.add() 加入段落后再拼装内容。整个域以开始标记开始、以 fieldmarktype.fieldend 结束,end 属性用来把结束标记和域对象关联起来。配合 mailmerge.execute() 把合并数据填进文档,if 域就能根据实际数值显示不同的结果。
结果演示
以下是上述两段代码生成的域:
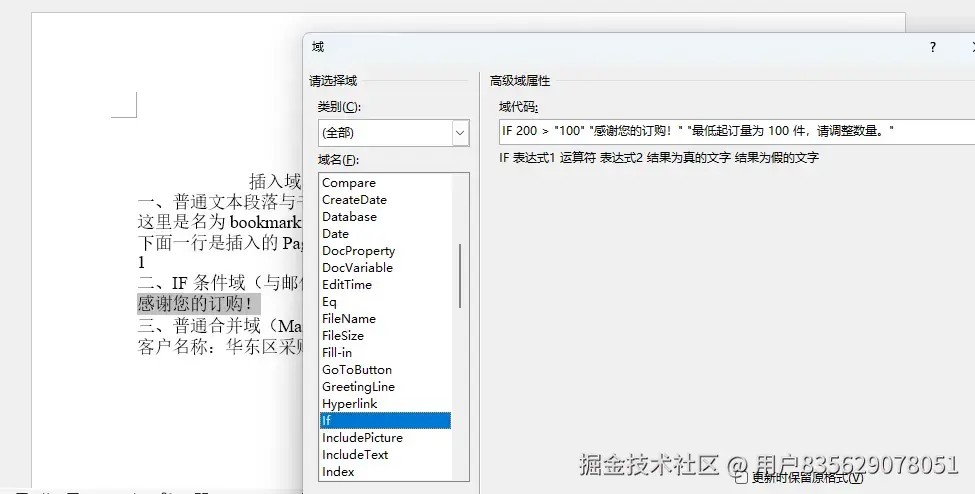
更新文档中的所有域
域显示的是"最后一次计算的结果"。如果文档是在程序里动态生成的,或者数据发生了变化,需要在保存前重新计算:
document = document()
document.loadfromfile("文档.docx")
# 保存前更新所有域
document.isupdatefields = true
document.savetofile("更新域.docx", fileformat.docx)
isupdatefields 设置在 savetofile() 之前即可,保存时文档会重新计算所有域的结果。这是动态生成 word 文档时经常要做的最后一步。
读取域中的文本
document.fields 属性返回文档中全部域的集合,每个域通过 fieldtext 属性暴露当前计算出的文本结果:
document = document()
document.loadfromfile("文档.docx")
fields = document.fields
for i in range(fields.count):
    field = fields.get_item(i)
    print(field.fieldtext)
document.close()遍历集合可以在不了解文档结构的情况下,快速排查某个域是否生效、结果是否符合预期。fields[0] 可以直接按索引访问第一个域。
将域转换为普通文本
有时文档定稿后不再需要动态更新,比如把生成的订单或合同导出给客户查看。这时可以把域转换为普通文本,避免接收方打开文件时域结果因环境差异而发生变化:
document = document()
document.loadfromfile("文档.docx")
fields = document.fields
count = fields.count
for i in range(0, count):
    field = fields[0]
    s = field.fieldtext
    index = field.ownerparagraph.childobjects.indexof(field)
    text_range = textrange(document)
    text_range.text = s
    text_range.characterformat.fontsize = 24
    # 用文本替换域的位置,再移除域
    field.ownerparagraph.childobjects.insert(index, text_range)
    field.ownerparagraph.childobjects.remove(field)
document.savetofile("域转文本.docx", fileformat.docx)
document.close()
核心思路是:先读取域的当前文本,在域所在段落的位置插入一个 textrange,再把原本的域对象移出段落。由于每次处理后 fields.count 会相应变化,使用 fields[0] 循环处理即可把剩余域逐一清理干净。
删除不需要的域
删除域比转换更简单——找到域所在的段落,按索引直接移除:
document = document()
document.loadfromfile("文档.docx")
# 获取第一个域及其所在段落
field = document.fields[0]
par = field.ownerparagraph
# 定位域在段落中的位置并删除
index = par.childobjects.indexof(field)
par.childobjects.removeat(index)
document.savetofile("删除域.docx", fileformat.docx)
document.close()
ownerparagraph 返回域所属的段落,childobjects 是段落内的对象集合,indexof() 找到域的下标后,removeat() 即可把它删除。需要批量删除时,把这段逻辑放进循环即可。
实用提示
- 域代码在 word 中按
alt+f9可以切换显示,建议在生成后手动确认关键域的代码格式是否正确。 isupdatefields要在savetofile()之前设置,否则保存结果里域不会被重新计算。- if 域的条件部分要严格按"表达式 + 比较符 + 值"的顺序拼装,文本值必须用英文双引号包住。
- 域转文本会丢失域的动态特性,适合文档定稿或对外分发前的处理;文档内部流转时建议保留域。
- 处理完文档后调用
document.close()释放资源。
总结
本文介绍了用 python 在 word 文档中操作域的常用方法:用 appendfield() 插入简单域、用 iffield 构造条件域、用 isupdatefields 统一更新所有域、借助 document.fields 读取域文本、把域转为普通文本,以及通过 ownerparagraph 定位并删除域。掌握这些操作后,动态文档中的页码、条件和合并数据都可以交给脚本统一处理。
到此这篇关于python 操作 word 文档域的完整教程的文章就介绍到这了,更多相关python word 文档域的插入与管理内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!





发表评论