
 我要评论
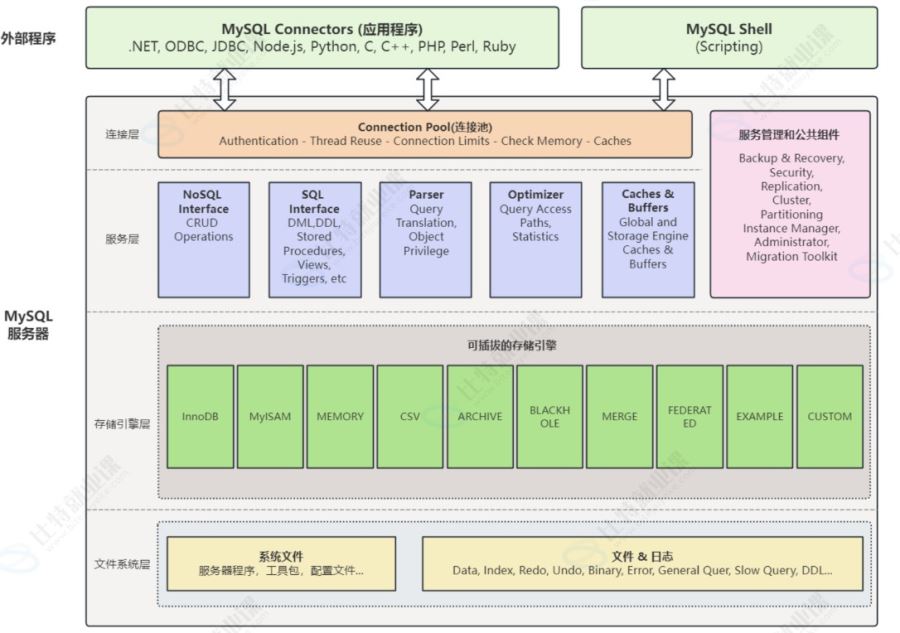
从架构图可以看出 mysql 的分层设计非常清晰、解耦充分。
本文按连接层 → 服务层 → 存储引擎层 → 文件系统层逐层讲解,并串联"一条 sql 的完整生命周期"。
一、架构总览
mysql 服务器从上到下分为四层:
| 层次 | 核心组件 | 职责 |
|---|---|---|
| 连接层 | connection pool(连接池/连接处理) | 连接建立、认证、线程分配与复用、连接数限制 |
| 服务层 | sql interface、parser、optimizer、caches & buffers | sql 接收、解析、优化、结果返回、管理服务 |
| 存储引擎层 | 可插拔的存储引擎(innodb/myisam...) | 数据的存储与读取、事务实现 |
| 文件系统层 | 系统文件、数据/索引文件、各类日志 | 与操作系统交互,真正落盘 |
外部程序(应用程序、mysql shell、各种连接器)发出的请求自上而下穿过这四层。
二、连接层(connection pool)
2.1 客户端的连接方式
mysql 支持四种连接方式:
| 方式 | 说明 |
|---|---|
| tcp/ip | 最常用,mysql -h 127.0.0.1 -p 3306 |
| unix socket | 本机连接,mysql -s /var/run/mysqld/mysqld.sock,不走网络,性能好 |
| 命名管道(named pipe) | windows 专用 |
| 共享内存(shared memory) | windows 专用 |
2.2 连接处理流程
⚠️ 重要:mysql 服务器默认不使用 epoll / reactor 模型。这一点要和 redis、muduo 严格区分:
- redis/muduo:单(少)线程 + epoll io 多路复用,一个线程管大量连接;
- mysql:默认采用 one-thread-per-connection模型,每个连接由一个独立线程以阻塞式 i/o处理自己的 socket。
真实流程:
- mysql 启动时,主线程创建 listen socket 并监听 3306;
- 新连接到达时,主线程
accept取出连接(监听 socket 底层用 poll/vio 等待,不是 epoll); - 为该连接创建一个专用线程(或从线程缓存 thread cache 中取一个空闲线程);
- 该线程负责这个连接的整个生命周期:认证 → 循环接收 sql → 执行 → 返回;
- 连接断开后,线程不立即销毁,而是放入 thread cache 供下一个连接复用(由
thread_cache_size控制)。
源码对应:
connection_acceptor/mysqld_socket_listener:监听与 accept;per_thread_connection_handler:每连接一个线程;do_handle_one_connection():线程在一个连接上的命令循环。
2.3 连接层各组件(connection pool )
| 组件 | 作用 |
|---|---|
| authentication(认证) | 握手、校验用户名密码、ip、分配权限 |
| thread reuse(线程复用) | 断开的线程进入 thread cache 复用,避免频繁创建销毁 |
| connection limits(连接限制) | 受 max_connections 限制,超限返回 too many connections |
| check memory | 连接建立时检查内存资源 |
| caches | 连接级缓存(如 prepared statement、线程级缓冲) |
2.4 长连接与短连接
- 长连接:连接建立后持续使用、不断开(连接池、客户端默认)。缺点是长期累积内存(如连接的临时缓冲、统计信息),可能导致 oom;可用
mysql_reset_connection或定期重连释放。 - 短连接:每次执行完 sql 就断开,频繁建连开销大(tcp 握手 + 认证 + 线程创建)。。
2.5 线程池(thread pool,企业版/插件)
需要注意:图中"连接池"是连接管理,不是线程池。
- mysql 企业版 thread pool / percona / mariadb 提供:多个工作线程 + 监听线程,linux 上用 epoll 管理大量连接,类似 reactor;
- mysql 社区版默认不带,仍然是 one-thread-per-connection。
三、服务层(management services & utilities + sql core)
连接建立后,客户端发送 sql,进入服务层。
3.1 nosql interface(nosql 接口)
- mysql 5.6+ 提供 innodb memcached 插件,允许应用绕过 sql 层,直接用 memcached 协议对 innodb 表做 crud,省去解析和优化开销;
- 8.0 中该插件仍存在,但使用极少,属于历史遗留的 nosql 能力。
3.2 sql interface(sql 接口)
- 客户端 sql 的统一入口:接收 dml、ddl、存储过程、视图、触发器、存储函数等;
- 支持的语句经此分发到后续解析、优化、执行模块;
- 同时返回结果集、受影响行数、状态信息。
3.3 parser(解析器)
解析器分三步:
- 词法分析(lex):把 sql 文本切分成一个个 token(关键字、标识符、字面量);
- 语法分析(yacc/bison):按语法规则生成解析树,若语法错误(如关键字拼写错、括号不匹配)直接返回错误,不再往下走;
- 语义解析/预处理(resolve):检查表名、列名是否存在、解析视图、校验权限、确定数据类型。
3.4 optimizer(优化器)
优化器发现多个执行路径时,基于统计信息和成本模型(cost model)选择成本最低的方案。
主要工作:
| 优化类型 | 举例 |
|---|---|
| 条件化简 | where id > 5 and id > 10 → where id > 10 |
| 选择访问路径 | 全表扫描、索引、范围扫描、ref、const |
| 决定 join 顺序 | 多表 join 时选择驱动表与被驱动表 |
| 子查询改写 | 部分子查询转 semi-join、派生表合并 |
| 索引选择 | 根据基数、回表成本选择索引 |
| 条件下推 | icp 把条件下推到引擎层过滤 |
可用 explain 查看优化器最终选择的执行计划。
3.5 caches & buffers
⚠️ 8.0 删除了 query cache(查询结果缓存,qc)——因为它在多核、写入频繁场景下锁竞争严重、命中率低。
| 缓存/缓冲 | 作用 |
|---|---|
| innodb buffer pool | 缓存表数据页和索引页,最重要的内存区域,读写都优先经过它 |
| redo log buffer | redo log 先写内存,再刷盘 |
| change buffer | 二级索引非唯一页的延迟更新(在 buffer pool 中) |
| adaptive hash index | innodb 自动为热点索引页建哈希索引 |
| table cache(table_open_cache) | 缓存已打开表的定义和 handler |
| thread cache | 缓存断开连接的线程 |
| host cache | 缓存客户端主机的连接/错误信息 |
| prepared statement cache | 缓存预处理语句 |
3.6 管理服务与公共组件
它是一组横向贯穿的管理能力:
| 组件 | 作用 |
|---|---|
| backup & recovery | 备份恢复:mysqldump、xtrabackup、基于 binlog 的 pitr |
| security | 安全:用户认证、权限系统、角色、tde 透明加密、审计、ssl |
| replication | 主从复制:异步/半同步、gtid、binlog 复制 |
| cluster | 集群:mgr(group replication)、innodb cluster/clusterset |
| partitioning | 表分区:range/list/hash/key 分区 |
| instance manager / administrator | 实例管理:mysqladmin、show status/variables、监控 |
| migration toolkit | 迁移工具:mysql workbench、数据库迁移向导 |
这些功能不属于单条 sql 的执行路径,而是为整个数据库实例提供管理、高可用和扩展能力。
四、存储引擎层(pluggable storage engines)
4.1 可插拔设计:handler 接口
服务层与存储引擎之间通过统一的 handler 接口解耦:
- 每打开一张表,就创建一个对应引擎的 handler 对象(如 innodb 的
ha_innobase); - 服务层只调用抽象方法:
rnd_next()、index_first()、write_row()、update_row()、delete_row()、external_lock()等; - 至于底层数据怎么存、怎么找、锁怎么加、事务怎么实现,完全由引擎决定。
因此 mysql 可以在同一个服务层下插拔不同引擎,甚至不同表用不同引擎。
4.2 各引擎简述
| 引擎 | 特点 |
|---|---|
| innodb(默认) | 支持 acid 事务、行级锁、mvcc、外键、崩溃恢复(redo/undo) |
| myisam | 5.5 之前默认,表锁、不支持事务、崩溃易损坏,读多写少 |
| memory | 数据全在内存,默认哈希索引,重启丢失,适合临时表 |
| csv | 数据存为 csv 文本文件,可直接用 excel 查看 |
| archive | 高压缩比,只支持插入/查询,适合归档历史数据 |
| blackhole | 写入数据被丢弃,binlog 仍记录,常用于级联复制中转 |
| merge | 把多个同结构 myisam 表逻辑合并 |
| federated | 访问远程 mysql 表,本地不存数据 |
| example / custom | 示例引擎 / 自定义引擎 |
4.3 存储引擎做什么
收到执行计划后,引擎按 sql 执行具体的 crud:
- 查询:先查 buffer pool,命中直接返回;未命中则向操作系统发起读文件请求,把数据页加载进 buffer pool;
- 写入:修改 buffer pool 中的页(脏页),写 redo/undo,后续异步刷盘;
- 加锁、实现事务隔离、维护索引。
五、文件系统层(file system layer)
5.1 系统文件(basedir)
| 类型 | 内容 |
|---|---|
| 服务器程序 | mysqld 主程序(/usr/sbin/mysqld) |
| 工具包 | mysql、mysqldump、mysqladmin、mysqlcheck 等客户端 |
| 配置文件 | /etc/mysql/my.cnf、mysql.conf.d、conf.d |
5.2 数据与索引文件(datadir,默认/var/lib/mysql)
| 文件 | 作用 |
|---|---|
mysql/ 等系统库 | 用户、权限、时区、日志表等 |
ibdata1 | innodb 系统表空间(旧版本数据/undo 也在其中) |
db/table.ibd | 独立表空间(file-per-table,数据+索引) |
undo_001/002 | undo log,回滚与 mvcc |
#innodb_redo/ | 8.0.30+ redo log 文件 |
#innodb_doublewrite/ | doublewrite 双写缓冲,防页损坏 |
5.3 各类日志文件
| 日志 | 内容 |
|---|---|
| binary log | 所有数据变更,用于复制和 pitr |
| redo log | 物理日志,崩溃恢复(引擎层) |
| undo log | 逻辑回滚段,事务回滚、mvcc |
| error log | 启动/关闭、错误、警告、提示 |
| general query log | 所有 sql 记录 |
| slow query log | 慢查询、未用索引语句 |
| ddl log | ddl 操作的崩溃恢复 |
六、一条 sql 的完整生命周期(串联全流程)
以 select * from t_user where id = 1; 为例:
- 连接建立:客户端通过 tcp 连 3306,主线程 accept;
- 认证与线程分配:校验用户名密码,分配一个线程(或从 thread cache 取);
- 接收 sql:线程阻塞读取 sql,交给 sql interface;
- 解析(parser):词法分析 → 语法分析生成解析树 → 检查表/列/权限;
- 优化(optimizer):基于成本和统计信息,决定走主键索引,生成执行计划;
- 执行(executor):通过 handler 接口调用 innodb;
- 引擎读取:先查 buffer pool,命中返回;未命中则向 os 发起系统调用读
.ibd文件,加载数据页; - 结果返回:沿线程 → 连接 → 客户端返回结果。
如果是 update/insert/delete,还会经过:写 undo → 修改 buffer pool(脏页)→ 写 redo(wal)→ 提交,后续由后台线程刷脏页
到此这篇关于mysql的基础架构之程序架构的文章就介绍到这了,更多相关mysql程序架构内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!

发表评论