
 我要评论
问题描述
有一次遇到这样一个面试题,说如果一个表中没有主键,如何找到里面重复的数据?
表数据如下:
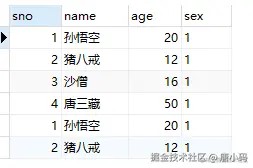
表结构如下:

针对以上问题,有以下几种解决方案
解决方案
1. 使用 group by 分组查询法
利用 group by 分组查询语句来分组聚合,然后筛选出出现次数大于1的重复记录。例如:
select column1, column2, column3, count(*) as count from table_name group by column1, column2, column3 having count > 1;
该语句将按照 column1、column2、column3 分组,统计每个分组的数量,然后取出数量大于 1 的分组。该方法比较简单,但是如果表中记录较多,可能查询效率较低。
2. 使用子查询法
使用子查询获得重复的记录,例如:
select * from table_name where (column1, column2, column3) in (select column1, column2, column3 from table_name group by column1, column2, column3 having count(*) > 1)
该语句子查询部分统计每个不同的 column1、column2、column3 分组,然后再用 in 子句将重复记录选出来。
3. 使用连接查询法
使用连接查询,将表和本身连接起来,并比较来判断重复。例如:
select a.* from table_name a inner join (select column1, column2, column3 from table_name group by column1, column2, column3 having count(*) > 1) b on a.column1 = b.column1 and a.column2 = b.column2 and a.column3 = b.column3
该语句以列 column1、column2、column3 分组,找出出现两次以上的重复记录,并与原表进行连接查询。
4. 使用去重后比较条数法
将表中所有列的值连接成一个字符串,再将这个字符串进行快速 md5 哈希,用 count() 函数来计算每个哈希值出现的次数,如果某个哈希值出现次数大于 1,那么这些记录就是重复的。例如:
select count(*), md5(concat_ws('|', column_1, column_2, column_3, column_4, ..., column_n)) from table_name group by md5(concat_ws('|', column_1, column_2, column_3, column_4, ..., column_n)) having count(*) > 1
5. 使用子查询法计算重复次数
使用子查询先计算出每个记录重复的次数,然后取出重复次数大于 1 的记录。例如:
select a.* from table_name a, (select column1, column2, column3, count(*) as count from table_name group by column1, column2, column3 having count > 1) b where a.column1 = b.column1 and a.column2 = b.column2 and a.column3 = b.column3
该语句计算出每个 column1、column2、column3 分组中出现的次数,然后筛选出出现次数大于 1 的记录。
6. 对多列使用 distinct 子句法
使用 distinct 子句来去除重复的数据,例如:
select distinct column1, column2, column3 from table_name
该语句将按照 column1、column2、column3 去重,只取出不同的记录。如果存在重复数据,那么就会取出重复数据。
7. 查找输入数据相同的记录法
这种方法就是找到输入的记录与某些记录是相同的,这些记录就是重复记录。例如:
select * from table_name where column1='value1' and column2='value2' and column3='value3'
该语句将根据表中每个过滤条件来查找重复记录。
8. 根据下标去重
该方法是通过打印出所有的键值,找出重复的键并去重。例如:
select distinct substring_index(column_string,',',1) as column1, substring_index(substring_index(column_string,',',2),',',-1) as column2, substring_index(column_string,',',-1) as column3 from (select concat(column1,',',column2,',',column3) as column_string from table_name) as table_alias
该语句将 select concat(column1,',',column2,',',column3) as column_string from table_name 产生的结果进行处理,将 column1、column2、column3 分开,然后再按照去重不同列的方法进行处理。
9. 手动输入表的列名法
该方法是通过手动输入要查询的列名,然后进行查找。例如:
select column1, column2, column3, count(*) as count from table_name group by column1, column2, column3 having count > 1;
10. 使用 row_number() over() 分配行号
该方法基于 row_number() over() 分配行号来找到重复的记录。例如:
select * from (
    select *, row_number() over(partition by column1, column2, column3 order by column1, column2, column3) as rn
    from table_name
) t
where t.rn > 1
该语句将按照 column1、column2、column3 分组,为每组结果分配一个行号并选出行号大于 1 的结果。这种方法适用于较新的 mysql 版本和较大的表。
到此这篇关于mysql表中没有主键找到重复数据的解决方法的文章就介绍到这了,更多相关mysql表没有主键找到重复数据内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!
发表评论