
 我要评论
① 先给结论
三句话说完:innodb 的行锁加在索引记录上,不是加在数据行上;加锁的基本单位是 next-key lock,它是记录锁加间隙锁的组合,锁一个左开右闭区间;间隙锁在 rc 隔离级别下基本不存在,它是 rr 用来阻止幻读的产物。
第三句是最容易被忘掉的。很多人把三五种锁名词背得挺熟,但一直没意识到加锁规则和隔离级别是绑在一起的。
还有一条前提必须先摆出来:sql 不走索引的时候,锁的是全表。 不是锁一行,是把扫过的每一条记录连同它们之间的间隙全锁上。这条在面试里说出来,比背十种锁名字有用。
② 一条 update 把毫无关系的 insert 卡住了
来看一个可以亲手复现的场景。假设有一张库存表,主键 id 上目前只有两条记录,id = 10 和 id = 20。
会话 a 执行:
-- session a
begin;
update stock set num = num - 1 where id > 13 and id < 17;
这条 sql 一条数据都匹配不到,返回 0 rows affected。看起来什么都没干。
会话 b 这时候执行:
-- session b
insert into stock (id, num) values (15, 100);
卡住了。等到锁等待超时(默认 50 秒,innodb_lock_wait_timeout),报 lock wait timeout exceeded。
b 插入的是 id = 15,表里压根没有这条记录,跟 a 那两条数据一点关系都没有。为什么会被堵住?
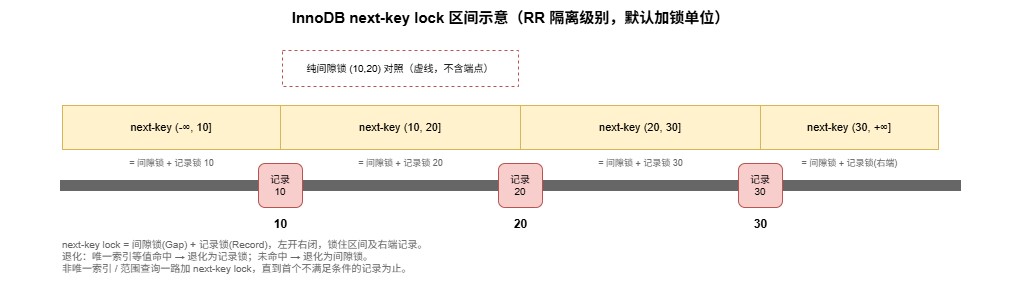
因为 a 锁的不是"它命中的那些行",而是它扫描到的范围。这个范围是 (10,20]:间隙 (10,20) 加上边界记录 20 上的记录锁,id = 15 正好落在里面。命中 0 行也会整段锁住。
把这个例子换成真实的业务:一张表里存着某个类目下在售的商品,夜间跑批量把某价格区间的商品下架,语句写成 update ... where price between 100 and 500。价格上没有索引也好、有索引也好,加锁的范围往往是整个区间而非匹配到的那几行,同时间有人在这个区间里新增商品就会被阻塞。等到业务高峰期,这类阻塞就变成了成片的接口超时。
③ 这题问的其实是三层
"讲讲 mysql 的锁"听起来漫无边际,面试官心里通常有明确的三层递进。
第一层,知道有哪些锁。行锁、表锁、意向锁、间隙锁、临键锁、自增锁、全局锁,能报出名字。
第二层,知道一条具体的 sql 会加什么锁。这一层开始要求给定隔离级别、给定索引情况,能判断加锁范围。绝大多数候选人卡在这一层。
第三层,知道为什么要有这些锁,以及它们和 mvcc、隔离级别之间的分工关系。
如果你只能答出第一层,面试官会顺着往下追一句"那 update t set a=1 where id=10 到底加了什么锁"。答不上来,第一层的分也就没了。
④ 主线:三种行级锁和它们的组合
4.1 行锁锁的是索引记录
这一节是全文的关键。
innodb 是索引组织表,数据本身就在聚簇索引的叶子节点里。所谓"锁住某一行",实际是锁住这条记录在索引上的那个索引项。
直接后果有两个。一是查询没走索引、走了全表扫描的话,innodb 会把扫过的每一条记录都加上锁,效果等同于锁全表。二是通过二级索引加锁时,会先锁二级索引项,再顺着主键去聚簇索引上把对应的记录也锁一遍。
这也是为什么前面说"不走索引等于锁全表"是件很危险的事:线上的大表上跑一条没走索引的 update,可能整张表在此期间都不可写。
4.2 三种锁,分别锁什么
| 锁 | 锁住的对象 | 长什么样 |
|---|---|---|
| record lock | 单条索引记录 | 锁住 id = 10 这一项 |
| gap lock | 两条记录之间的间隙 | 锁住 (10, 20),不含两端 |
| next-key lock | 左开右闭的区间 | (10, 20],等于前两者相加 |
gap lock 锁的是一个"还没有 record 的空间"。它不阻止任何人读写已存在的记录,只阻止往这个区间里插东西。所以间隙锁之间互不冲突,两个事务完全可以同时对同一个间隙加间隙锁,冲突只发生在"插入"这个动作上:要插入,就得先在这个间隙上获得插入意向锁,而它与已有的间隙锁互斥。
next-key lock 是 innodb 的默认加锁单位。这是最容易被忽略的一句:rr 隔离级别下,加的是 next-key lock,不是单纯的 record lock。
4.3 next-key lock 的加锁规则与退化
基本的加锁单位是 next-key lock,但它有两个退化规则:
- 唯一索引上的等值查询,命中记录时,退化为 record lock
- 唯一索引上的等值查询,没命中记录时,退化为 gap lock
举个例子。表里主键有 10、20、30。
select * from t where id = 20 for update;   -- 命中,退化为记录锁,只锁 20
select * from t where id = 17 for update;   -- 未命中,退化为间隙锁,锁住 (10, 20)
第二条特别值得记住:查不到东西不代表没加锁,它锁的是那条本该存在的记录周围的空隙。
非唯一索引和范围查询不享受这个待遇。范围查询会一路往后加 next-key lock,直到遇到第一个不满足条件的记录为止。这也解释了第②节那个例子,id > 13 and id < 17 会把 (10,20] 整段锁上:扫描从 id = 20 这条开始,判定不满足 < 17 之后停下来,但过程中的 next-key lock 已经加上了。
4.4 表级锁这一层
行锁往上还有三层,知道就好:
- 意向锁(is / ix):表级锁,事务在加行锁之前先加意向锁,用来快速判断表里面有没有行被锁住。它是 innodb 自己维护的,人工干预不了
- 表锁:
lock tables ... read/write,myisam 的老办法,innodb 下基本用不着 - 全局锁:
flush tables with read lock,全库只读,做逻辑备份时用。线上主库别执行,整库会停写;备份优先用 mysqldump 加--single-transaction(innodb 场景)
4.5 怎么确认它到底锁了什么
mysql 8.0 起可以直接查:
-- mysql 8.0+
select object_schema, object_name, index_name, lock_type, lock_mode, lock_status, lock_data
from performance_schema.data_locks
where object_name = 'stock';
lock_mode 里的 x 代表排他锁:只有 x(或 s)是 next-key lock,x,gap 是间隙锁,x,rec_not_gap 是记录锁,x,insert_intention 是插入意向锁。lock_data 那一列会告诉你具体锁在哪条记录上。
mysql 5.7 没有这张表。要查当前锁等待,可以用 information_schema.innodb_locks 和 innodb_lock_waits;要看死锁历史,才用:
show engine innodb status\g
输出巨长,看 transactions 那一段,里面有 record locks space id ... page no ... 的信息,可读性远不如 8.0,但排查死锁时 latest detected deadlock 那一段仍然是主要依据。
⑤ 面试官在等的那句
把三种锁讲清楚,算答完了第二层。多数人答到这里就停了。
真正让面试官抬眼的是这一句:
间隙锁的存在理由只有一个,就是阻止幻读。而 innodb 防幻读其实是两套机制在分工:快照读靠 mvcc 的 readview,不需要加锁;只有当前读(
for update、lock in share mode、update、delete)才需要 next-key lock 来保证期间不会有新记录插进来。所以把隔离级别降到 rc,间隙锁几乎全部消失(少量场景如外键检查和 duplicate key 校验仍会用到),阻塞大幅减少,代价就是承认幻读的存在。
再补一句会更有分量:mysql 默认 rr 而非 rc,有很强的历史成分。早期复制只能依赖 statement 格式的 binlog,rc 下事务提交顺序和语句实际的执行效果容易对不上,从库重放就可能得到不同的结果。row 格式普及之后这个约束弱了很多,所以现在不少团队直接跑 rc 加 row 格式 binlog,换取更少的锁等待。这条要不要跟,得看你们的主从架构和业务容忍度,我给不了死结论。
⑥ 常见误区
误区一:以为没查到数据就没加锁第 4.3 节已经说过,唯一索引等值查询没命中时不会什么都不做,它会退化成间隙锁,锁住那条不存在的记录本该落进去的那段空隙。rr 下任何一次加锁的查询都会留下痕迹。
误区二:以为间隙锁只在 delete/update 时出现普通的 select ... for update 一样会加。只要是当前读,规则就一样。
误区三:以为行锁一定比表锁开销小用不上索引的行锁等于遍历全表逐条加锁,这期间还要锁住所有扫描到的间隙。真要走全表,表锁反而更省资源。
**误区四:把 rc 当成"完全没有间隙锁"**绝大多数情况下成立,但外键约束检查、唯一键冲突检查这些内部操作依然会产生间隙锁。这个细节可以不主动说,被追问时能答上就是加分。
误区五:以为 rr 就一定能防住幻读快照读能防,因为整个事务用的是同一个 readview。但如果事务里混了当前读,同一个事务两次相同查询可能返回不同行数,第二次当前读之后,后续快照读看到的又是新的。这类场景下 rr 给不了你想象中的那种绝对保护。
⑦ 速查表
| 隔离级别 | 行锁 | 间隙锁 |
|---|---|---|
| rc | 有 | 基本没有 |
| rr | 有 | 有,默认 next-key lock |
| serializable | 有,普通 select 也会加锁 | 有 |
加锁单位记忆口诀:默认 next-key lock;唯一索引等值命中退化为记录锁;唯一索引等值未命中退化为间隙锁;范围查询一路加到第一个不满足条件的记录为止。
⑧ 一个可以自己试的问题
建议你真的去把第②节那段 sql 跑一遍,不同索引类型、不同隔离级别各跑一次,用 performance_schema.data_locks 看实际锁了什么。这比看十篇文章都管用。
我自己在写这篇的时候留了个疑问没解决:范围查询扫过之后,为什么 innodb 要把"第一个不满足条件的记录"也一并锁上,而不是停在上一条满足条件的记录那里。往特性上说,是为了保证可重复读下一次范围查询的结果不变,但这个解释我没亲眼验证过边界情况。
你在线上遇到过哪些因为间隙锁引起的阻塞?评论区说说你当时的排查路径。
完整的十二个模块(java / c++ / go / jvm / mysql / redis / mq / 分布式 / 事务 / 网络 / 系统设计 / 项目深挖)我整理成了一份手册,每题都标了考察点和加分答法。【草丛后端架构】,持续分享后端架构与底层原理。
到此这篇关于mysql行锁、间隙锁、next-key lock 到底锁住了谁的文章就介绍到这了,更多相关mysql 行锁、间隙锁、next-key lock内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!

发表评论