
 我要评论
如果你正准备上 rabbitmq,或者已经装了但心里没底,这篇就是你的“从 0 到 1 生产级落地手册”。不是 hello world,不是只讲概念,而是从真实订单场景出发,把选型、部署、配置、spring boot 集成、可靠性、集群、监控一次讲透。每一步都有命令、配置、代码,能直接搬进项目。
本文你会看到:
- 为什么用 mq:异步解耦、削峰填谷、可靠投递,一张图看懂订单链路
- 部署避坑:docker rpm 二进制怎么选?rabbitmq 和 erlang 版本怎么配?
- 单机落地:centos 7 + rpm 全流程,含 web 控制台、guest 删除、vhost 权限“开光”操作
- 生产配置:内存水位、磁盘下限、心跳、端口安全,默认配置别裸奔
- spring boot 集成:依赖、yaml、死信绑定、confirm + return、手动 ack、幂等消费
- 原生 java 客户端:发布确认、消息持久化、qos 限流,不依赖 spring boot 也能打
- 全链路可靠性:消息不丢、不重复、不积压、不乱序,一张闭环图 + 速查表
- 高可用集群:普通集群 vs 镜像队列,3 节点 + haproxy 生产方案
- 监控运维:prometheus + grafana + 告警,队列深度、消费速率、死信堆积全盯住
读完你能拿走:✅ 可直接复制的部署命令和配置
✅ spring boot + 原生 java 两套实战代码
✅ 7 大生产级难题的解决方案
✅ 一套 rabbitmq 生产落地 checklist
✅ 面试能讲、项目能用的可靠性设计
适合谁看:后端开发、架构师、运维工程师,以及正在做订单、秒杀、异步解耦、系统解耦的同学。
一句话总结:消息不能丢,服务不能挂,问题要能看到。rabbitmq 生产级落地,这篇全讲透了。
如果觉得有用,点个 赞 + 在看,收藏防丢;关注我,后续继续更新延迟队列、rpc 模式、多租户隔离等实战内容。
关于这个问题的底层原理和更多实战细节,我整理了一份《大厂面试手册》,包含大厂高频面试题、源码解析和性能调优案例。
√信搜【rain的java大神之路】,持续更新中。
rabbitmq 从 0 到 1 部署实战:从单机落地到 spring boot 全链路集成,这篇全讲透了
本文从真实项目出发,完整覆盖 rabbitmq 的选型分析、环境部署、生产配置优化、spring boot 集成、可靠性保障、高可用集群以及监控运维全流程。不是纸上谈兵,每一步都附带可直接落地的代码和命令。
一、为什么要引入 rabbitmq?先搞清楚场景
在聊部署之前,我们先想清楚一个问题:为什么要用消息队列?
以一个典型的订单系统为例,创建订单之后要做的事情可不少:发短信通知用户、加会员积分、写操作日志……如果全塞在主流程里同步执行,接口响应时间直接爆炸。更别提秒杀场景下瞬时流量打到数据库,分分钟教你做人。
rabbitmq 在这个场景里解决三个核心问题:
- 异步解耦:订单创建完成后,短信、积分、日志各自异步消费,主流程只负责投递消息,秒级返回
- 削峰填谷:秒杀流量先灌进队列,消费者按自己的节奏慢慢消化,数据库不再被打爆
- 可靠投递:下游系统偶尔宕机也不怕,消息持久化在 broker 里,恢复后继续消费
基于这个场景,我设计了如下架构:
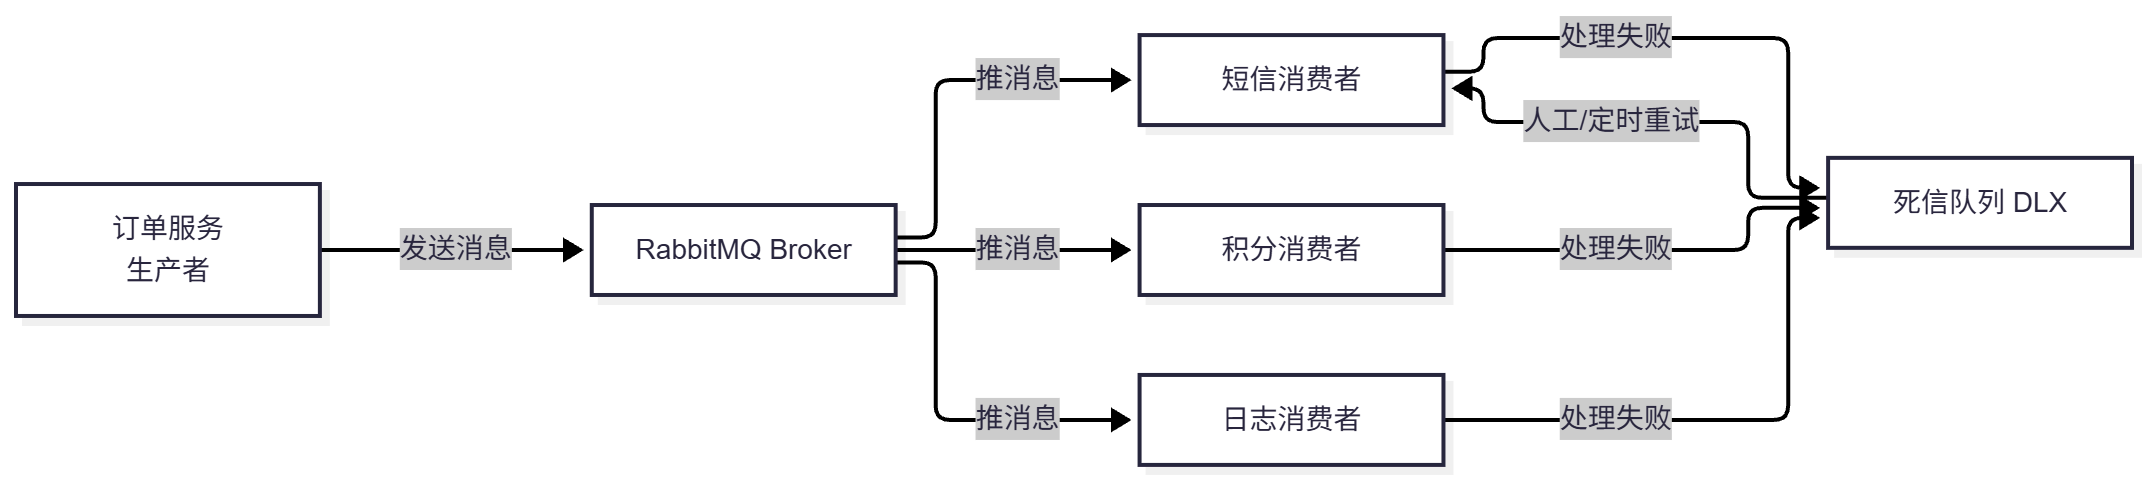
搞清楚"为什么用",接下来才是"怎么落地"。
二、部署前避坑:环境选型与版本匹配
rabbitmq 基于 erlang 开发,版本兼容性是部署的第一大坑。版本不匹配?服务直接启动失败,连报错日志都让你怀疑人生。
部署方式怎么选?
| 部署方式 | 优势 | 适用场景 |
|---|---|---|
| docker 部署 | 环境隔离、一键启动、运维成本低 | 开发测试、快速验证 |
| rpm/deb 包安装 | 性能损耗小、系统级服务管理 | 生产环境首选 |
| 二进制解压 | 高度可定制、支持多版本并存 | 特殊定制化场景 |
版本匹配铁律
严格遵循官方版本矩阵,别自己瞎组合:
- rabbitmq 3.12.x → erlang 25.0 ~ 26.x
- rabbitmq 3.10.x → erlang 24.2 ~ 25.x
血泪教训:禁止随意组合大版本,优先选用官方长期支持(lts)版本。我曾经因为 erlang 版本高了个小版本,插件加载直接报错,排查了大半天。
三、单机部署:从安装到"能跑"
以生产环境常用的 centos 7 + rpm 安装为例,走一遍完整流程。
3.1 安装核心步骤
# 1. 安装匹配版本的 erlang 依赖
yum install -y erlang-25.3.2.7
# 2. 安装 rabbitmq 服务包
rpm -ivh rabbitmq-server-3.12.12-1.el7.noarch.rpm
# 3. 启动服务 + 设置开机自启
systemctl start rabbitmq-server
systemctl enable rabbitmq-server
3.2 部署后必须做的"开光"操作
很多新手装完就以为完事了,下面这几步不做等于白装:
# ① 开启 web 管理控制台(运维必备,不开等于瞎子)
rabbitmq-plugins enable rabbitmq_management
# ② 删除默认 guest 用户(默认只允许 localhost 访问,远程连接直接报错)
rabbitmqctl delete_user guest
# ③ 创建管理员用户
rabbitmqctl add_user order_admin yourstrongpassword
rabbitmqctl set_user_tags order_admin administrator
rabbitmqctl set_permissions -p / order_admin ".*" ".*" ".*"
# ④ 创建业务 virtual host(资源隔离,不同项目的交换机和队列互不干扰)
rabbitmqctl add_vhost /order_vhost
rabbitmqctl set_permissions -p /order_vhost order_admin ".*" ".*" ".*"
3.3 部署验证
- 浏览器访问
http://服务器ip:15672,用新建的管理员账号登录 - 执行
rabbitmqctl status确认节点运行状态 - 看到管理后台界面,单机基础部署就算完成了
四、生产级配置优化:别让默认配置坑了你
默认配置是给开发环境用的,直接上生产就是"裸奔"。配置文件路径:/etc/rabbitmq/rabbitmq.conf
| 配置参数 | 作用 | 生产推荐值 | 设计目的 |
|---|---|---|---|
vm_memory_high_watermark.relative = 0.4 | 内存水位阈值 | 40% 物理内存 | 达到阈值后阻塞生产者,避免 oom |
disk_free_limit.absolute = 2gb | 磁盘最低剩余空间 | 2gb | 磁盘不足时触发流控,防止打满崩溃 |
heartbeat = 60 | tcp 心跳间隔 | 60 秒 | 自动清理死连接,释放资源 |
listeners.tcp.default = 5672 | amqp 协议端口 | 建议改非默认端口 | 基础安全防护 |
management.tcp.port = 15672 | 管理后台端口 | 限制内网 ip 访问 | 禁止公网暴露管理后台 |
注意:3.7+ 版本采用键值对格式配置,旧版是 erlang 语法的
rabbitmq.config,部署时注意区分,别抄错了格式。
五、spring boot 集成:核心代码全落地
这才是大部分同学实际工作中要用到的。先上依赖和配置,再逐个拆解。
5.1 maven 依赖
<dependency>
    <groupid>org.springframework.boot</groupid>
    <artifactid>spring-boot-starter-amqp</artifactid>
</dependency>
5.2 application.yml 配置
spring:
  rabbitmq:
    host: 192.168.1.100
    port: 5672
    username: order_admin
    password: yourstrongpassword
    virtual-host: /order_vhost
    # 开启发送端确认(消息到达 exchange 后有回调)
    publisher-confirm-type: correlated
    # 开启发送端回退(路由到 queue 失败可感知)
    publisher-returns: true
    # 消费端配置
    listener:
      simple:
        acknowledge-mode: manual   # 手动 ack,保证消费可靠性
        prefetch: 10               # 每次预取 10 条,配合限流防打爆
5.3 队列与交换机声明(绑定死信队列)
这一步是架构设计的关键——在声明队列的时候就绑定死信交换机,后续消费失败的消息会自动流转到死信队列,不会无限重试阻塞主队列。
@configuration
public class rabbitorderconfig {
    // 订单交换机
    @bean
    public directexchange orderexchange() {
        return new directexchange("order.exchange", true, false);
    }
    // 订单队列 —— 注意这里绑定了死信交换机
    @bean
    public queue orderqueue() {
        map<string, object> args = new hashmap<>();
        args.put("x-dead-letter-exchange", "order.dlx.exchange");     // 死信交换机
        args.put("x-dead-letter-routing-key", "order.dlx.routingkey"); // 死信路由 key
        args.put("x-message-ttl", 600000);                             // 消息 ttl 10 分钟
        return new queue("order.queue", true, false, false, args);
    }
    // 绑定关系
    @bean
    public binding orderbinding() {
        return bindingbuilder.bind(orderqueue()).to(orderexchange()).with("order.create");
    }
    // ===== 死信交换机 & 死信队列 =====
    @bean
    public directexchange orderdlxexchange() {
        return new directexchange("order.dlx.exchange", true, false);
    }
    @bean
    public queue orderdlxqueue() {
        return new queue("order.dlx.queue", true);
    }
    @bean
    public binding orderdlxbinding() {
        return bindingbuilder.bind(orderdlxqueue()).to(orderdlxexchange()).with("order.dlx.routingkey");
    }
}
5.4 生产者:消息落库 + confirm 回调 + 失败补偿
这是保证消息可靠投递的核心设计:消息先落库,发送成功后更新状态,失败的由定时任务补偿重发。
@service
public class ordermessagesender {
    @autowired
    private rabbittemplate rabbittemplate;
    @autowired
    private msglogrepository msglogrepository;
    /**
     * 发送订单消息
     * 核心思路:先落库 → 再发送 → 回调更新状态 → 失败定时补偿
     */
    public void sendordermessage(order order) {
        // 1. 消息落库,status=0(待确认)
        msglog msglog = new msglog();
        msglog.setmsgid(uuid.randomuuid().tostring());
        msglog.setcontent(json.tojsonstring(order));
        msglog.setstatus(0);
        msglogrepository.save(msglog);
        // 2. 携带 msgid 发送,用于回调匹配
        correlationdata correlationdata = new correlationdata(msglog.getmsgid());
        rabbittemplate.convertandsend("order.exchange", "order.create", order, correlationdata);
    }
    // 统一设置 confirm 和 return 回调
    @postconstruct
    public void initrabbittemplate() {
        // confirmcallback:消息是否到达 exchange
        rabbittemplate.setconfirmcallback((correlationdata, ack, cause) -> {
            string msgid = correlationdata.getid();
            if (ack) {
                msglogrepository.updatestatus(msgid, 1); // 成功
            } else {
                msglogrepository.updatestatus(msgid, 2); // 失败,等待补偿
                log.error("消息发送到 exchange 失败, msgid: {}", msgid);
            }
        });
        // returncallback:消息路由不到 queue 时触发
        rabbittemplate.setreturncallback((message, replycode, replytext, exchange, routingkey) -> {
            string msgid = message.getmessageproperties().getcorrelationid();
            msglogrepository.updatestatus(msgid, 2);
            log.error("消息路由失败, msgid: {}, replytext: {}", msgid, replytext);
        });
    }
}
5.5 消费者:手动 ack + 幂等校验 + 死信兜底
@component
public class orderconsumer {
    @autowired
    private msglogrepository msglogrepository;
    @autowired
    private businessservice businessservice;
    @rabbitlistener(queues = "order.queue")
    public void handleorder(message message, channel channel) throws ioexception {
        string msgid = message.getmessageproperties().getcorrelationid();
        order order = json.parseobject(message.getbody(), order.class);
        try {
            // ① 幂等判断:这条消息是否已经处理过了?
            if (msglogrepository.ismsgprocessed(msgid)) {
                channel.basicack(message.getmessageproperties().getdeliverytag(), false);
                return; // 已处理,直接 ack 丢弃
            }
            // ② 核心业务逻辑:发短信、加积分、写日志……
            businessservice.process(order);
            // ③ 标记已处理 + 手动 ack
            msglogrepository.markprocessed(msgid);
            channel.basicack(message.getmessageproperties().getdeliverytag(), false);
        } catch (exception e) {
            log.error("消费异常, msgid: {}", msgid, e);
            // 拒绝且不放回队列 → 消息进入死信队列,由独立任务处理
            channel.basicnack(message.getmessageproperties().getdeliverytag(), false, false);
        }
    }
}
六、原生 java 客户端实战(不依赖 spring boot 的场景)
如果你的项目没有用 spring boot,或者你需要更底层的控制,这里也给出原生客户端的写法。
6.1 maven 依赖
<dependency>
    <groupid>com.rabbitmq</groupid>
    <artifactid>amqp-client</artifactid>
    <version>5.20.0</version>
</dependency>
6.2 生产者(发布确认 + 消息持久化)
public class orderproducer {
    private static final string exchange = "order_direct_exchange";
    private static final string queue = "order_create_queue";
    private static final string routing_key = "order.create";
    public static void main(string[] args) throws exception {
        connectionfactory factory = new connectionfactory();
        factory.sethost("192.168.1.100");
        factory.setport(5672);
        factory.setusername("order_admin");
        factory.setpassword("yourstrongpassword");
        factory.setvirtualhost("/");
        try (connection conn = factory.newconnection();
             channel channel = conn.createchannel()) {
            // 声明交换机、队列(durable=true 持久化,broker 重启不丢失)
            channel.exchangedeclare(exchange, builtinexchangetype.direct, true);
            channel.queuedeclare(queue, true, false, false, null);
            channel.queuebind(queue, exchange, routing_key);
            // 开启生产者发布确认
            channel.confirmselect();
            string msg = "订单id:10086, 用户id:6666";
            // persistent_text_plain:消息持久化落盘
            channel.basicpublish(exchange, routing_key,
                    messageproperties.persistent_text_plain,
                    msg.getbytes(standardcharsets.utf_8));
            // 同步确认(生产环境推荐异步 confirmlistener 批量确认,性能更高)
            if (channel.waitforconfirms()) {
                system.out.println("消息投递成功");
            } else {
                system.out.println("消息投递失败,触发重试逻辑");
            }
        }
    }
}
6.3 消费者(手动 ack + 消费限流)
public class orderconsumer {
    private static final string queue = "order_create_queue";
    public static void main(string[] args) throws exception {
        connectionfactory factory = new connectionfactory();
        factory.sethost("192.168.1.100");
        factory.setusername("order_admin");
        factory.setpassword("yourstrongpassword");
        connection conn = factory.newconnection();
        channel channel = conn.createchannel();
        // 每次只拉 1 条消息,处理完再拉下一条,防止服务被打垮
        channel.basicqos(1);
        // autoack=false:关闭自动确认,手动 ack 保证消费可靠性
        channel.basicconsume(queue, false, (consumertag, delivery) -> {
            string message = new string(delivery.getbody(), standardcharsets.utf_8);
            try {
                system.out.println("处理订单:" + message);
                // 业务处理成功,手动确认
                channel.basicack(delivery.getenvelope().getdeliverytag(), false);
            } catch (exception e) {
                // 消费失败:nack 后消息重回队列
                // 生产建议:requeue=false 转死信队列,避免无限重试
                channel.basicnack(delivery.getenvelope().getdeliverytag(), false, true);
            }
        }, system.out::println);
    }
}
七、全链路可靠性保障:一张图看懂消息流转
把前面所有的设计串起来,消息从生产到消费的完整闭环如下:
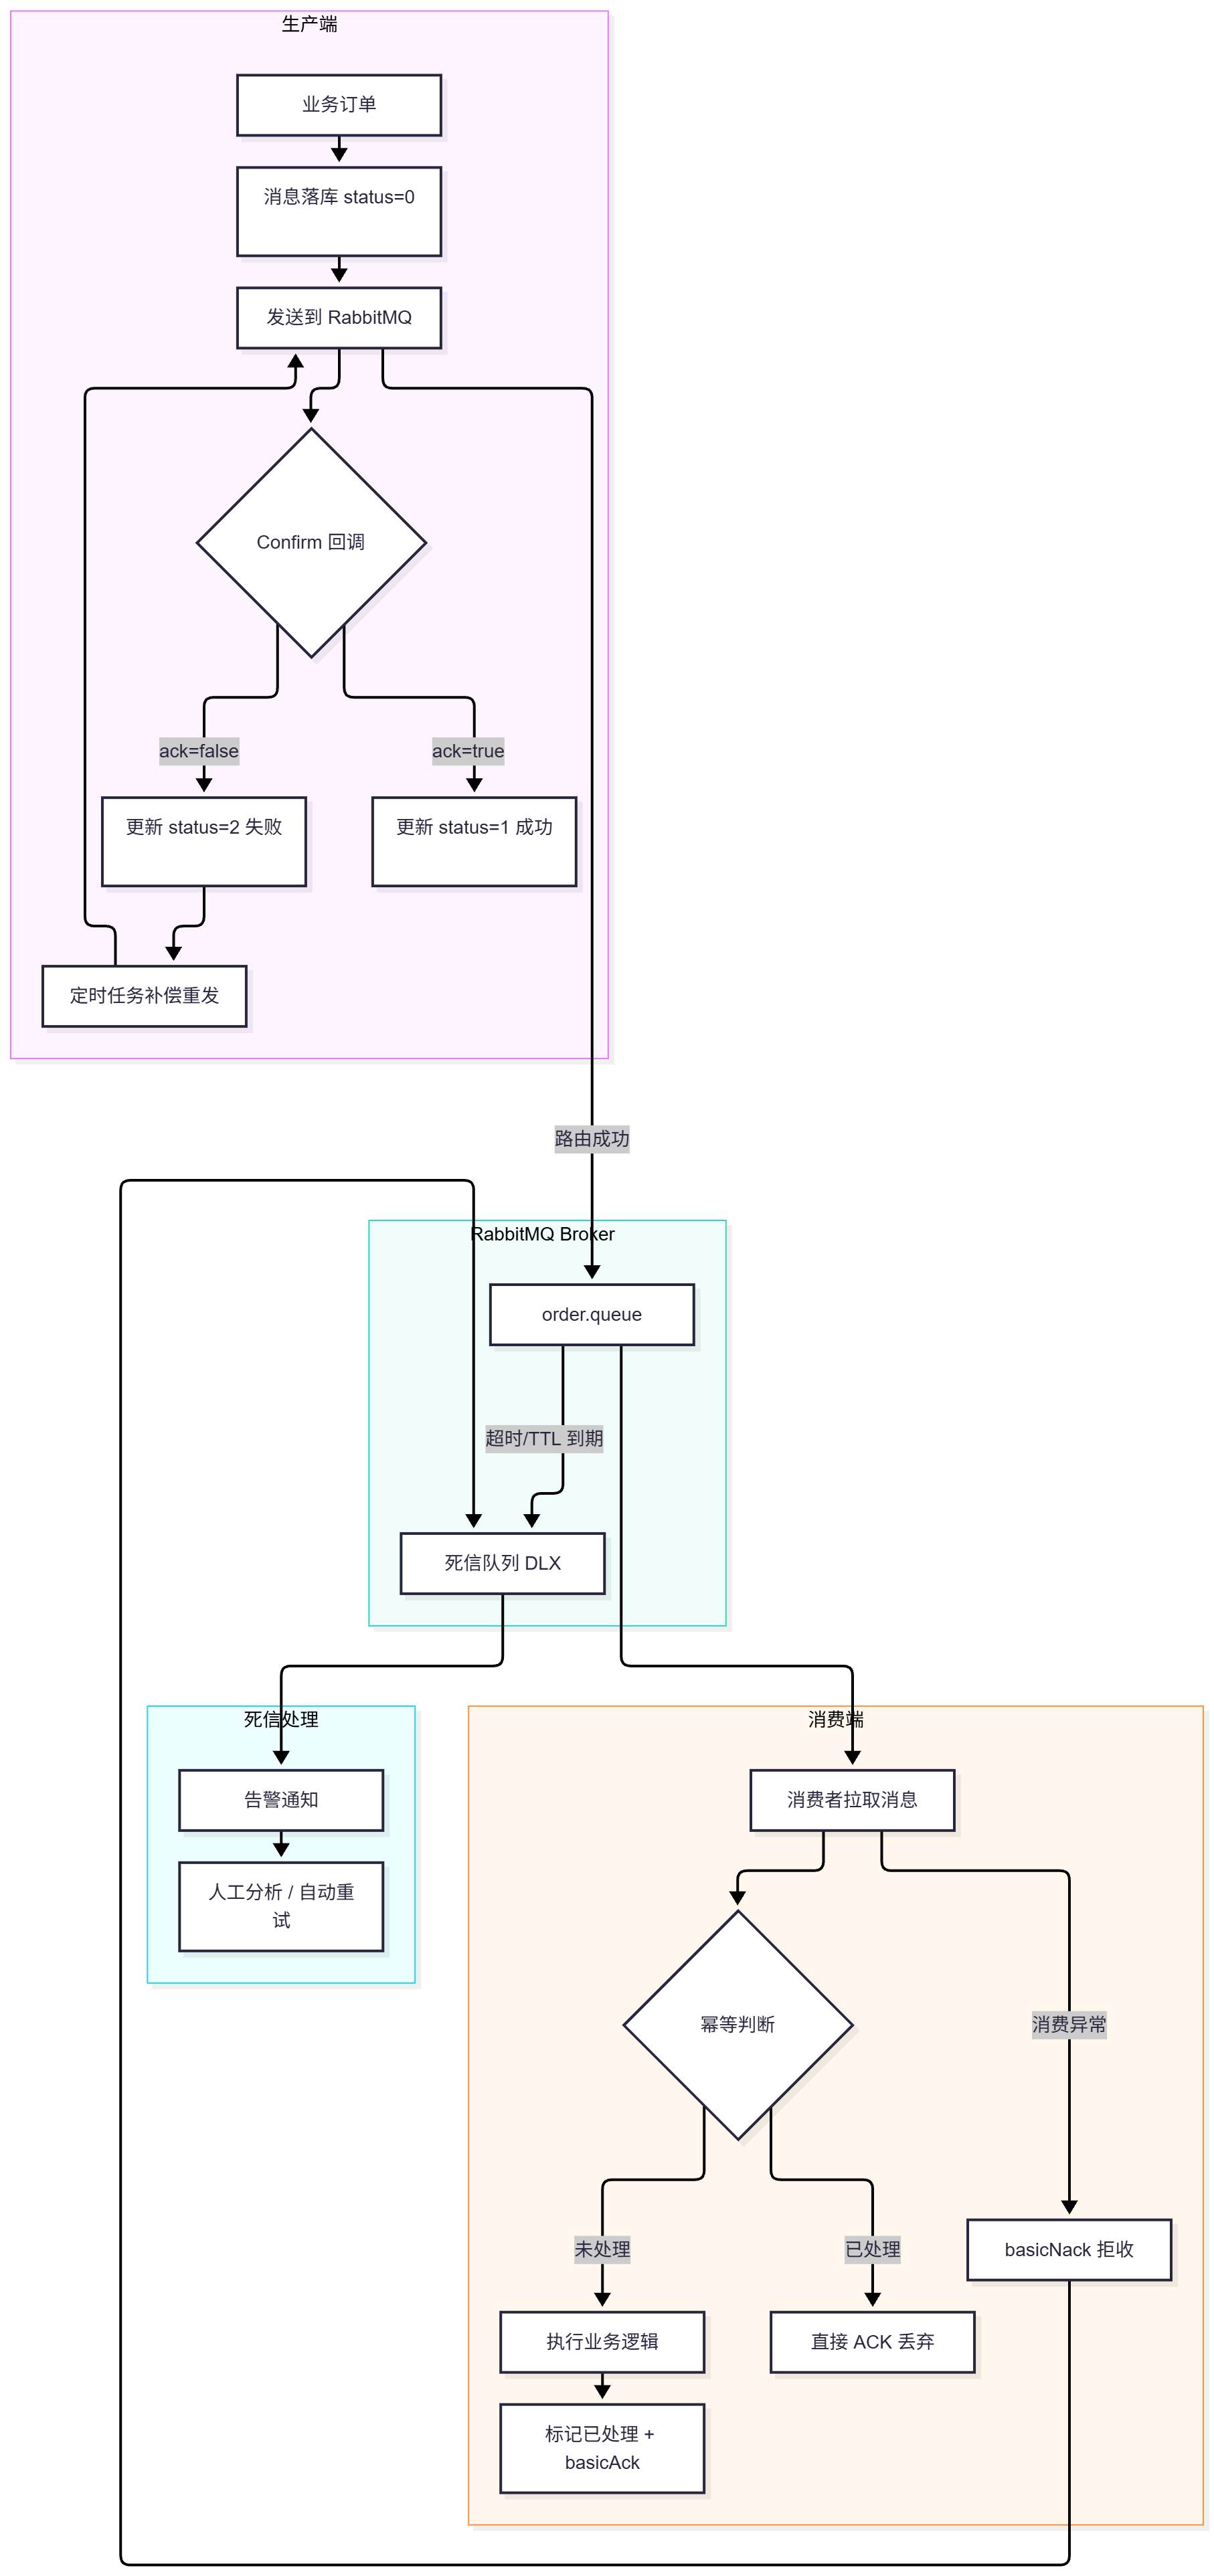
八、核心技术难点与解决方案速查表
这张表建议收藏,面试和实际排障都用得上:
| 技术难点 | 问题现象 | 落地解决方案 |
|---|---|---|
| 消息丢失 | 发送端、broker、消费端三个链路都可能丢消息 | ① 生产者 confirm + return 机制 + 消息日志落库,定时补偿重发② 交换机/队列/消息三级持久化(durable=true)③ 消费端关闭自动 ack,手动确认 |
| 重复消费 | 网络抖动、ack 超时导致消息重投 | ① 消费端基于业务唯一 id + 数据库唯一索引做幂等② redis 记录已处理消息 id(设置过期时间) |
| 服务 oom | 消息积压导致内存飙升,服务宕机 | ① 设置内存水位阈值(0.4),触发生产者流控② 配置队列最大长度,溢出转死信③ 消费端 qos 限流 |
| 消息积压 | 消费速度远低于生产速度 | ① 水平扩容消费者实例(k8s hpa 或手动加 pod)② 优化消费逻辑,缩短单条处理耗时③ 队列分片拆分,分散压力 |
| 消息顺序性 | 多消费者并发导致消息乱序 | ① 单队列单消费者保证严格顺序② 按业务 id 哈希路由到同一队列,实现局部有序 |
| 集群脑裂 | 网络分区导致多节点各自为主 | ① 配置 cluster_partition_handling = pause_minority② 内网部署,保障网络稳定性③ 增加网络分区监控告警 |
| 死信堆积 | 异常消息不断重试导致队列阻塞 | ① 绑定死信交换机 + 死信队列,失败消息转移而非无限重试② 独立告警任务轮询死信队列,人工/自动分析处理 |
九、高可用集群演进:从单机到镜像集群
单机跑稳之后,下一步就是解决"单点故障"问题。标准演进路径:普通集群 → 镜像队列集群。
| 集群模式 | 原理 | 可用性 | 适用场景 |
|---|---|---|---|
| 普通集群 | 队列数据仅存于单个节点,其他节点只同步元数据 | 低,节点故障队列不可用 | 纯性能扩容,无高可用要求 |
| 镜像队列集群 | 队列主副本 + 从副本分布在多节点,主故障自动切换 | 高,数据多副本冗余 | 生产环境标准方案 |
镜像队列核心配置
# 全局策略:所有队列开启镜像,同步到集群所有节点
rabbitmqctl set_policy ha-all "^" '{"ha-mode":"all"}'生产建议:至少 3 节点部署,客户端使用
addresses配置多个节点地址实现故障转移,前端挂 haproxy 或 nginx 做负载均衡。
十、监控与运维:没有监控就是瞎子上路
部署完不是结束,是开始。生产环境必须接入监控:
- prometheus + grafana:rabbitmq 自带
rabbitmq_prometheus插件,开启后直接暴露 metrics。重点关注的指标:队列深度、消费速率、未确认消息数、连接数 - 告警规则:队列消息数 > 1 万 → 钉钉/企微告警;死信队列有消息 → 立刻通知值班人员
- 日志采集:接入 elk 或 loki,方便排查消息流转异常
# 开启 prometheus 监控插件
rabbitmq-plugins enable rabbitmq_prometheus
总结
整篇文章从场景分析 → 环境部署 → 配置优化 → spring boot 集成 → 原生客户端 → 可靠性保障 → 高可用集群 → 监控运维,覆盖了 rabbitmq 从 0 到 1 落地的完整链路。
核心记住三句话:
- 消息不能丢:生产者 confirm + 消息落库 + 消费端手动 ack,三道保险
- 服务不能挂:镜像集群 + 内存水位 + 死信队列,层层兜底
- 问题要能看到:prometheus + grafana + 告警规则,生产不能靠猜
希望这篇文章对你有用,如果觉得有帮助,欢迎点赞收藏,后续还会更新 rabbitmq 的高级特性——延迟队列、rpc 模式、多租户隔离等实战内容,敬请期待。
到此这篇关于别再瞎装 rabbitmq 了!从 0 到 1 部署到 spring boot 全链路实战指南(生产级坑全填平)的文章就介绍到这了,更多相关spring boot 全链路实战内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!
发表评论