
 我要评论
数据清洗是每个和数据打交道的人都绕不开的日常。
无论是做分析、跑模型,还是给业务方出报表,拿到的原始数据往往都带着重复记录、缺失值、格式错误,甚至一些明显违背常识的条目。
我以前习惯每次遇到问题就临时写几行 drop_duplicates() 或 fillna(),但下次换一份数据,同样的脏法又得重写一遍。
与其这样反复救火,不如建一条可复用的数据管道:清洗、验证、报告一步到位,让脏数据经过流水线后变成可信的输入。
本文将用 pandas 和 pydantic 搭一条不到 100 行核心代码的数据清洗与验证管道。
读完之后希望能让朋友们理解管道的设计思路,还能把它直接套用到平时的生活和工作场景中。
1. 管道的三条职责:清洗、验证、报告
制造业的流水线之所以高效,是因为每个工位只做一件事,上一步的输出就是下一步的输入。
数据管道也可以这样设计。
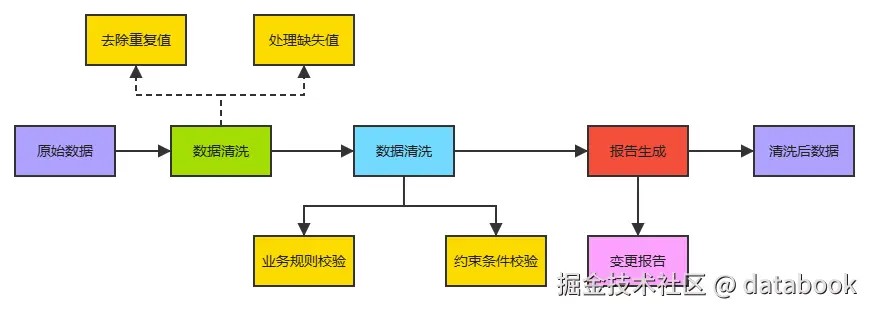
我们让管道承担三项职责:
- 清洗,负责去重、处理缺失值,并为后续扩展留出空间;
- 验证,确保每一行数据都满足业务规则,比如年龄不能是负数、手机号必须是 11 位;
- 报告,追踪整个过程中到底去掉了多少重复、补了多少空、拦下了多少错误。
这样一来,数据质量不再是模糊的感觉,而是可以量化的指标。
要搭建这条管道,只需要两个库:pandas 用来处理表格,pydantic 用来定义“什么算有效数据”。
如果你还没安装,在终端里执行 pip install pandas pydantic 即可。
2. 先定义“有效”,再谈清洗
很多人的清洗习惯是先把数据改得“看起来能看”,再去想验证的事。
但更好的顺序是反过来:先明确什么样的数据才算合格,然后再让清洗服务于这个标准。
pydantic 的 basemodel 正好适合做这件事。
我们以一个社区团购订单为例,定义 ordervalidator,字段包括姓名、年龄、手机号和订单金额。
from pydantic import basemodel, field_validator, validationerror
from typing import optional
import pandas as pd
import numpy as np

class ordervalidator(basemodel):
    name: str
    age: optional[int] = none
    phone: optional[str] = none
    amount: optional[float] = none

    @field_validator('age')
    @classmethod
    def validate_age(cls, v):
        if v is not none and (v < 0 or v > 100):
            raise valueerror('年龄必须在0到100之间')
        return v

    @field_validator('phone')
    @classmethod
    def validate_phone(cls, v):
        if v and (not v.isdigit() or len(v) != 11 or not v.startswith('1')):
            raise valueerror('手机号必须是11位数字且以1开头')
        return v

    @field_validator('amount')
    @classmethod
    def validate_amount(cls, v):
        if v is not none and v < 0:
            raise valueerror('金额不能为负数')
        return v
这里有几个关键点:
@field_validator必须和@classmethod搭配使用;- 年龄限制在 0 到 100 之间;
- 手机号要求 11 位数字且以 1 开头,这很符合国内手机号的格式;
- 金额不能为负。
有了这个模式,任何一行数据只要不满足规则,pydantic 就会抛出 validationerror,我们就能把它拦下来。
3. 给管道一个骨架,并让它学会记账
定义好验证模式后,我们创建一个 datapipeline 类。
它的构造函数里初始化一个统计字典,用来记录去重数量、空值处理数量和验证错误数量。
别小看这个字典,它让管道有了“记账”的能力,每次运行后你都能清楚知道数据被动了哪些手脚。
class datapipeline:
    def __init__(self):
        self.cleaning_stats = {
            'duplicates_removed': 0,
            'nulls_handled': 0,
            'validation_errors': 0
        }
4. 清洗:去重、补缺,但要有章法
清洗方法 clean_data 接收一个 dataframe,返回处理后的版本。
第一步是去重,而且必须在填充缺失值之前做——如果先填充再取中位数,重复记录会把中位数拉偏。
去重之后,数值列用中位数填充,因为中位数比均值更抗离群值;文本列则统一填成 'unknown',给后续人工排查留个标记。
每处理一处空值,统计字典里的 nulls_handled 就累加一次。
    def clean_data(self, df: pd.dataframe) -> pd.dataframe:
        initial_rows = len(df)
        df = df.drop_duplicates()
        self.cleaning_stats['duplicates_removed'] = initial_rows - len(df)

        numeric_columns = df.select_dtypes(include=[np.number]).columns
        for col in numeric_columns:
            null_count = df[col].isnull().sum()
            if null_count > 0:
                df[col] = df[col].fillna(df[col].median())
                self.cleaning_stats['nulls_handled'] += null_count

        string_columns = df.select_dtypes(include=['object']).columns
        for col in string_columns:
            null_count = df[col].isnull().sum()
            if null_count > 0:
                df[col] = df[col].fillna('unknown')
                self.cleaning_stats['nulls_handled'] += null_count

        return df
5. 验证:逐行检查,但不让坏数据中断管道
清洗完成后,数据看起来完整了,但未必正确。
validate_data 方法会逐行迭代,把每一行转成字典后传给 ordervalidator。
有效行收集到 valid_rows,无效行则捕获 validationerror,记录下行号和错误详情。
这样做的好处是,单条坏数据不会让整个管道崩溃——能处理的尽量处理,同时把问题记录在案,供后续人工审查。
    def validate_data(self, df: pd.dataframe):
        valid_rows = []
        errors = []
        for idx, row in df.iterrows():
            try:
                validated = ordervalidator(**row.to_dict())
                valid_rows.append(validated.model_dump())
            except validationerror as e:
                errors.append({'row': idx, 'errors': str(e)})
        self.cleaning_stats['validation_errors'] = len(errors)
        return pd.dataframe(valid_rows), errors
6. 编排:让清洗和验证串起来
最后,用一个 process 方法把清洗和验证串联起来,返回一个包含清洗后数据、验证错误列表和统计信息的综合报告。
这样调用方只需要一个入口,就能拿到全部结果。
    def process(self, df: pd.dataframe):
        cleaned_df = self.clean_data(df.copy())
        validated_df, validation_errors = self.validate_data(cleaned_df)
        return {
            'cleaned_data': validated_df,
            'validation_errors': validation_errors,
            'stats': self.cleaning_stats
        }
7. 在社区团购订单场景中试一试
社区团购在国内非常普遍,订单数据通常来自微信群接龙、小程序下单或团长手动录入。
这类数据往往存在一些典型问题:同一用户重复下单、手机号少填几位、年龄栏被乱填、金额出现负数或空白。
我们构造一份示例数据来模拟这种情况:
if __name__ == "__main__":
    # 模拟社区团购订单数据:包含重复、缺失、非法年龄、非法手机号
    sample_data = pd.dataframe(
        {
            "name": ["张伟", "李娜", "王芳", none, "刘洋", "李娜"],
            "age": [28, -5, 35, 42, 150, -5],
            "phone": [
                "13812345678",
                "12345",
                "13987654321",
                "13712345678",
                "13612345678",
                "12345",
            ],
            "amount": [45.5, 60.0, 45.5, none, 88.8, 60.0],
        }
    )

    print("=" * 60)
    print("原始数据:")
    print(sample_data)
    print("=" * 60)

    pipeline = datapipeline()
    result = pipeline.process(sample_data)

    print("\n清洗后的有效数据:")
    print(result["cleaned_data"])

    print("\n验证错误清单:")
    if result["validation_errors"]:
        for err in result["validation_errors"]:
            print(f"  行号 {err['row']}:{err['errors']}")
    else:
        print("  无")

    print("\n统计信息:")
    for key, value in result["stats"].items():
        print(f"  {key}: {value}")

    print("\n" + "=" * 60)
    print(
        "处理完成。有效数据 {} 行,错误 {} 行。".format(
            len(result["cleaned_data"]), len(result["validation_errors"])
        )
    )
运行后,管道会先去掉一条完全重复的“李娜”记录,把缺失的姓名填成 'unknown',用中位数填补缺失的金额。
接着逐行验证:李娜的年龄 -5 和手机号 12345 会被拦下,刘洋的年龄 150 也会被标记为错误。
最终输出的有效数据里,张伟、王芳和那位姓名被补为 'unknown' 的用户顺利通过;错误清单则清晰列出问题所在的行和原因。
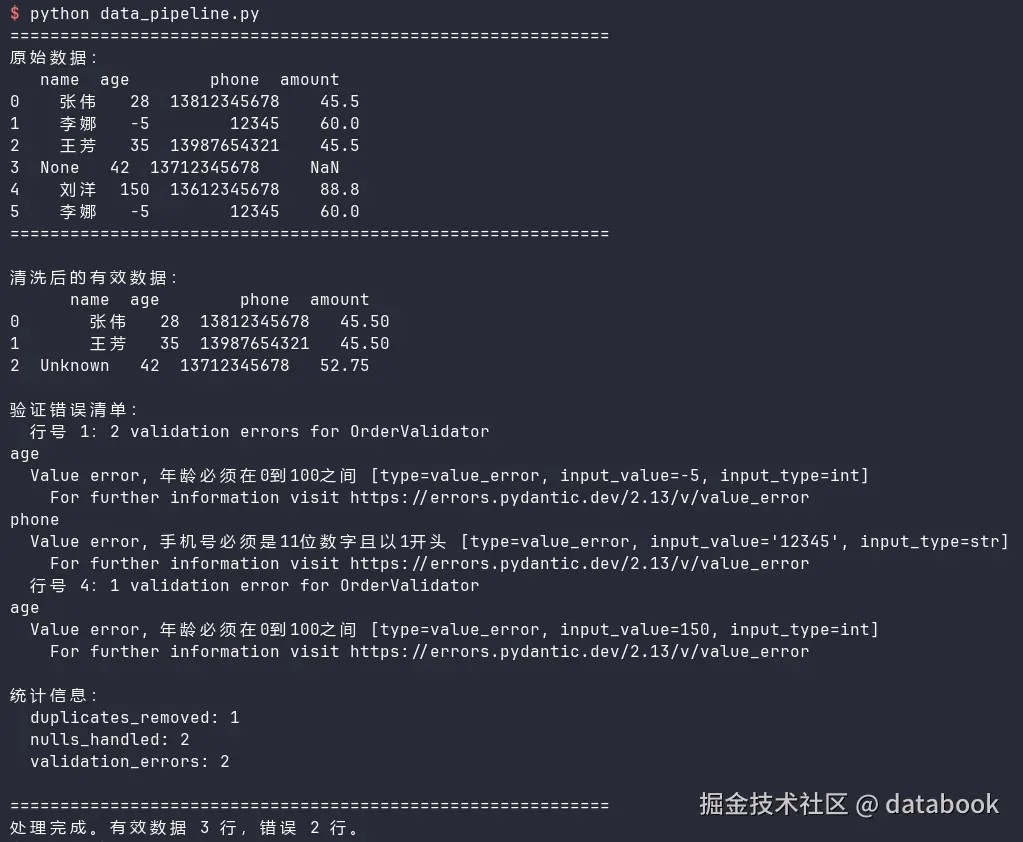
团长拿到这份报告,就能直接知道哪些订单需要人工核对手机号,哪些年龄明显是误填,而不必在一堆脏数据里反复翻找。
8. 管道之外:还能怎么扩展
这条管道只有不到 100 行核心代码,但它已经具备了可维护系统的雏形。
你可以根据具体场景继续扩展,比如:
- 增加自定义清洗规则,比如标准化地址、脱敏手机号;
- 也可以让 pydantic 模式可配置,使同一管道适配不同来源的数据;
- 如果数据量很大,还可以把逐行验证换成向量化操作或并行处理。
关键不在于一次写得多完美,而在于拥有一个可复用的骨架,把重复性的清洗和验证工作交给管道,自己则把精力放在从干净数据中提取洞察上。
到此这篇关于pandas如何结合pydantic搭建数据清洗与验证管道的文章就介绍到这了,更多相关pandas数据清洗内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!



发表评论