
 我要评论
乱码问题产生的根本原因
编码
编码:将人类可读的字符,按照指定字符集规则转换为二进制数据(如:utf-8 下 “中”→0xe4b8ad)
解码
将二进制数据,按照相同字符集规则还原为字符(如:0xe4b8ad→utf-8→“中”)。
原因
- 数据的编码和解码使用的不是同一个字符集
例如:当我们把字符通过utf-8进行编码(字符->1010,编码过程),再用gbk进行解码成字符的时候就会乱码
写入文件时用 utf-8 编码,读取时用 gbk 解码;或文件本身编码与编辑器打开编码不一致
如:用记事本以 ansi(gbk)保存的文件,用 vs code 以 utf-8 打开会乱码
- 使用了不支持某个语言文字的字符集
例如,一些iso系列的字符集就没有记录中文字符和1010的关系,若使用该系列字符集进行中文字符的处理,就一定出现乱码
单字节字符集(如 ascii、iso-8859-1):仅支持英文字符、部分符号,无中文、日文等多字节字符的映射;
区域性字符集(如 gbk、big5):仅支持特定区域的字符(gbk 支持中文,big5 支持繁体中文,shift_jis 支持日文);
通用字符集(如 utf-8、utf-16):支持全球几乎所有字符(基于 unicode 字符库)。
各个字符集的兼容性
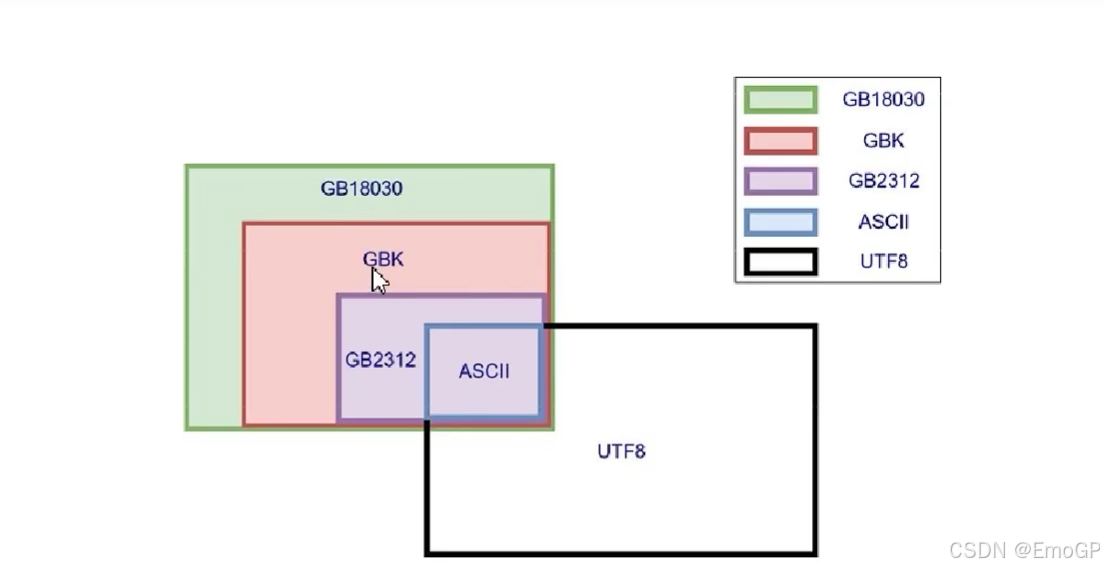
由上图得知,上述字符集都兼容了ascii
ascii中有什么?英文字母和一些通常使用的符号,所以这些东西无论使用什么字符集都不会乱码
html乱码问题
设置项目文件的字符集要使用一个支持中文的字符集
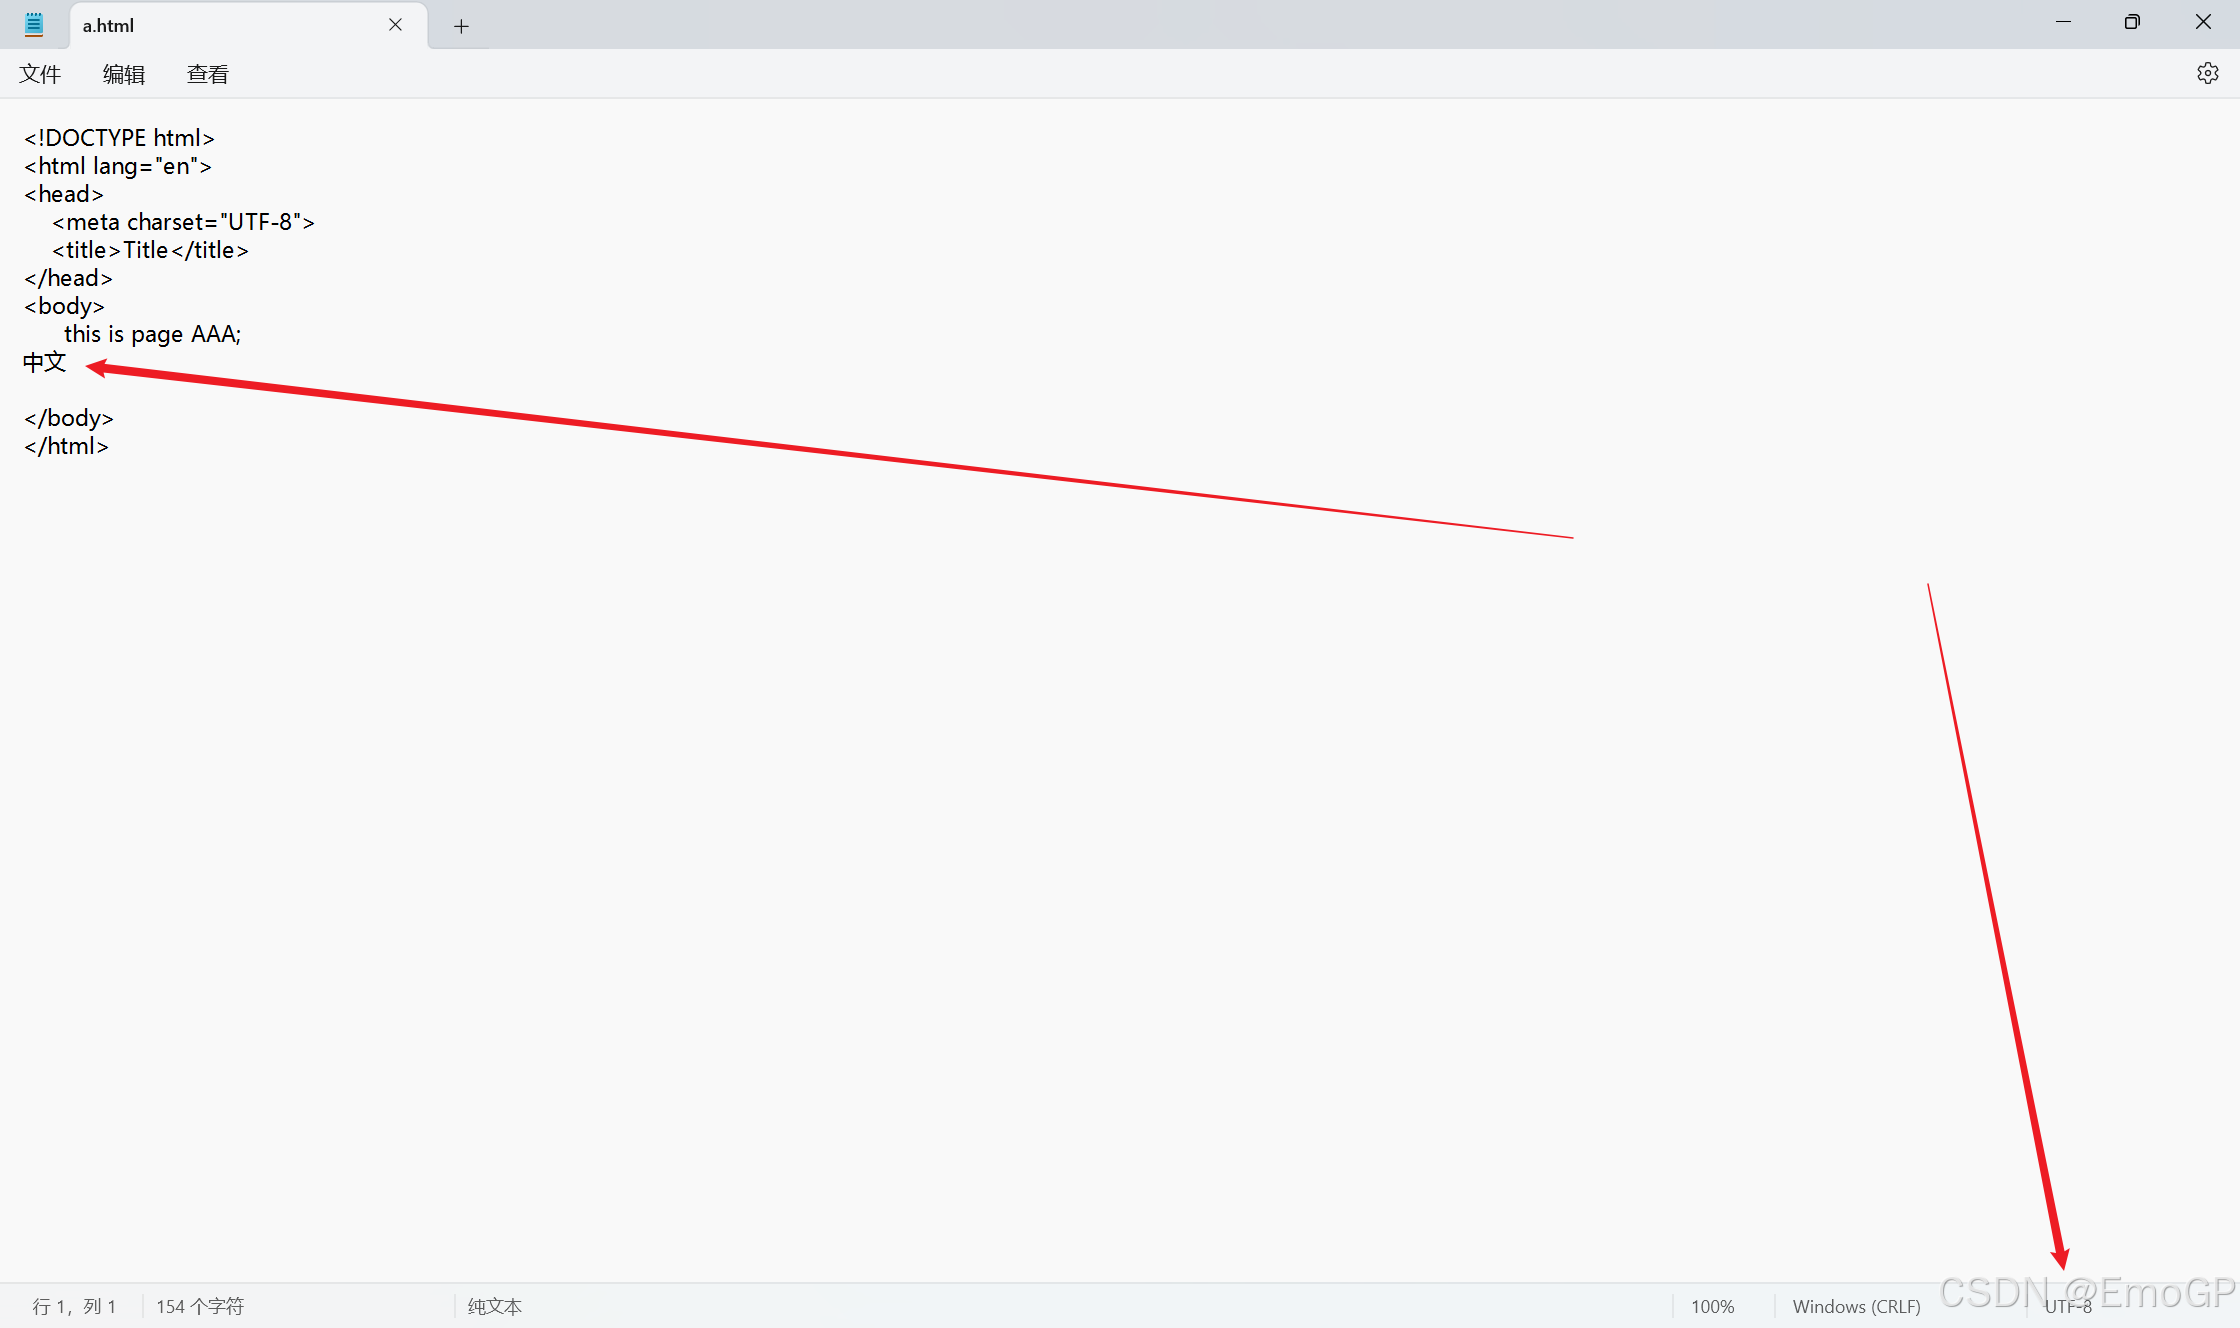
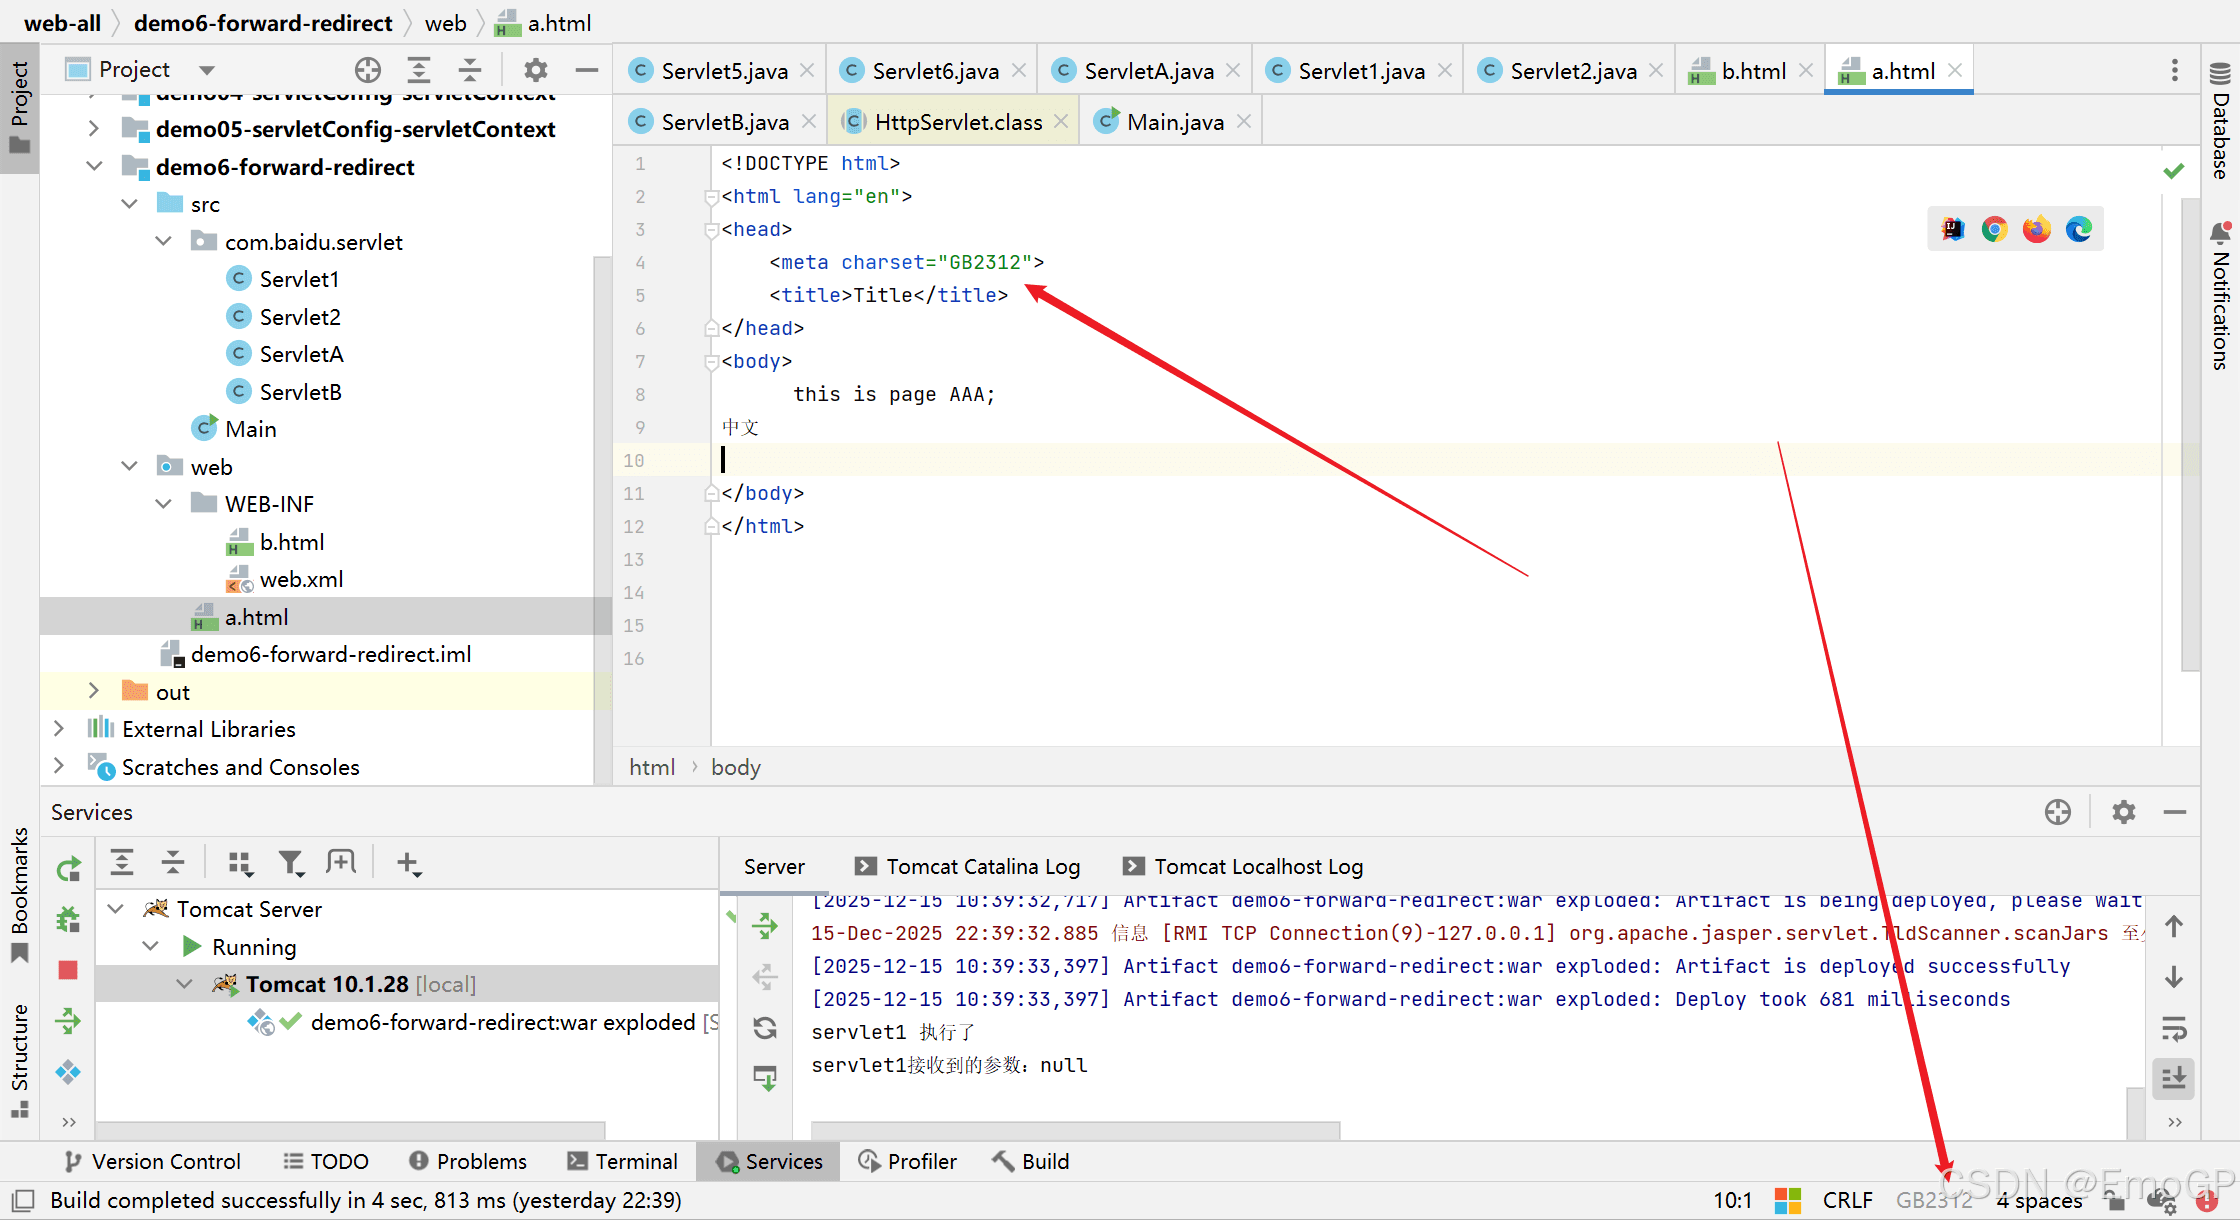
有如下html文件,右下角表示编码方式是utf-8
告诉浏览器用utf-8进行解码
<meta charset="utf-8">
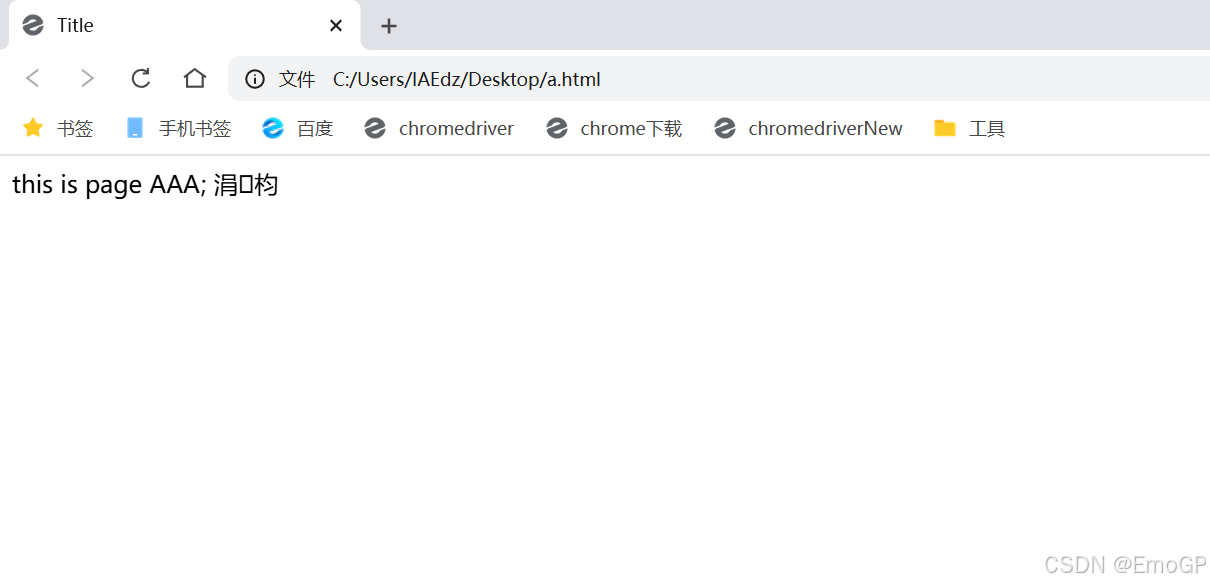
如果将meta charset改为gbk
用浏览器打开就会乱码
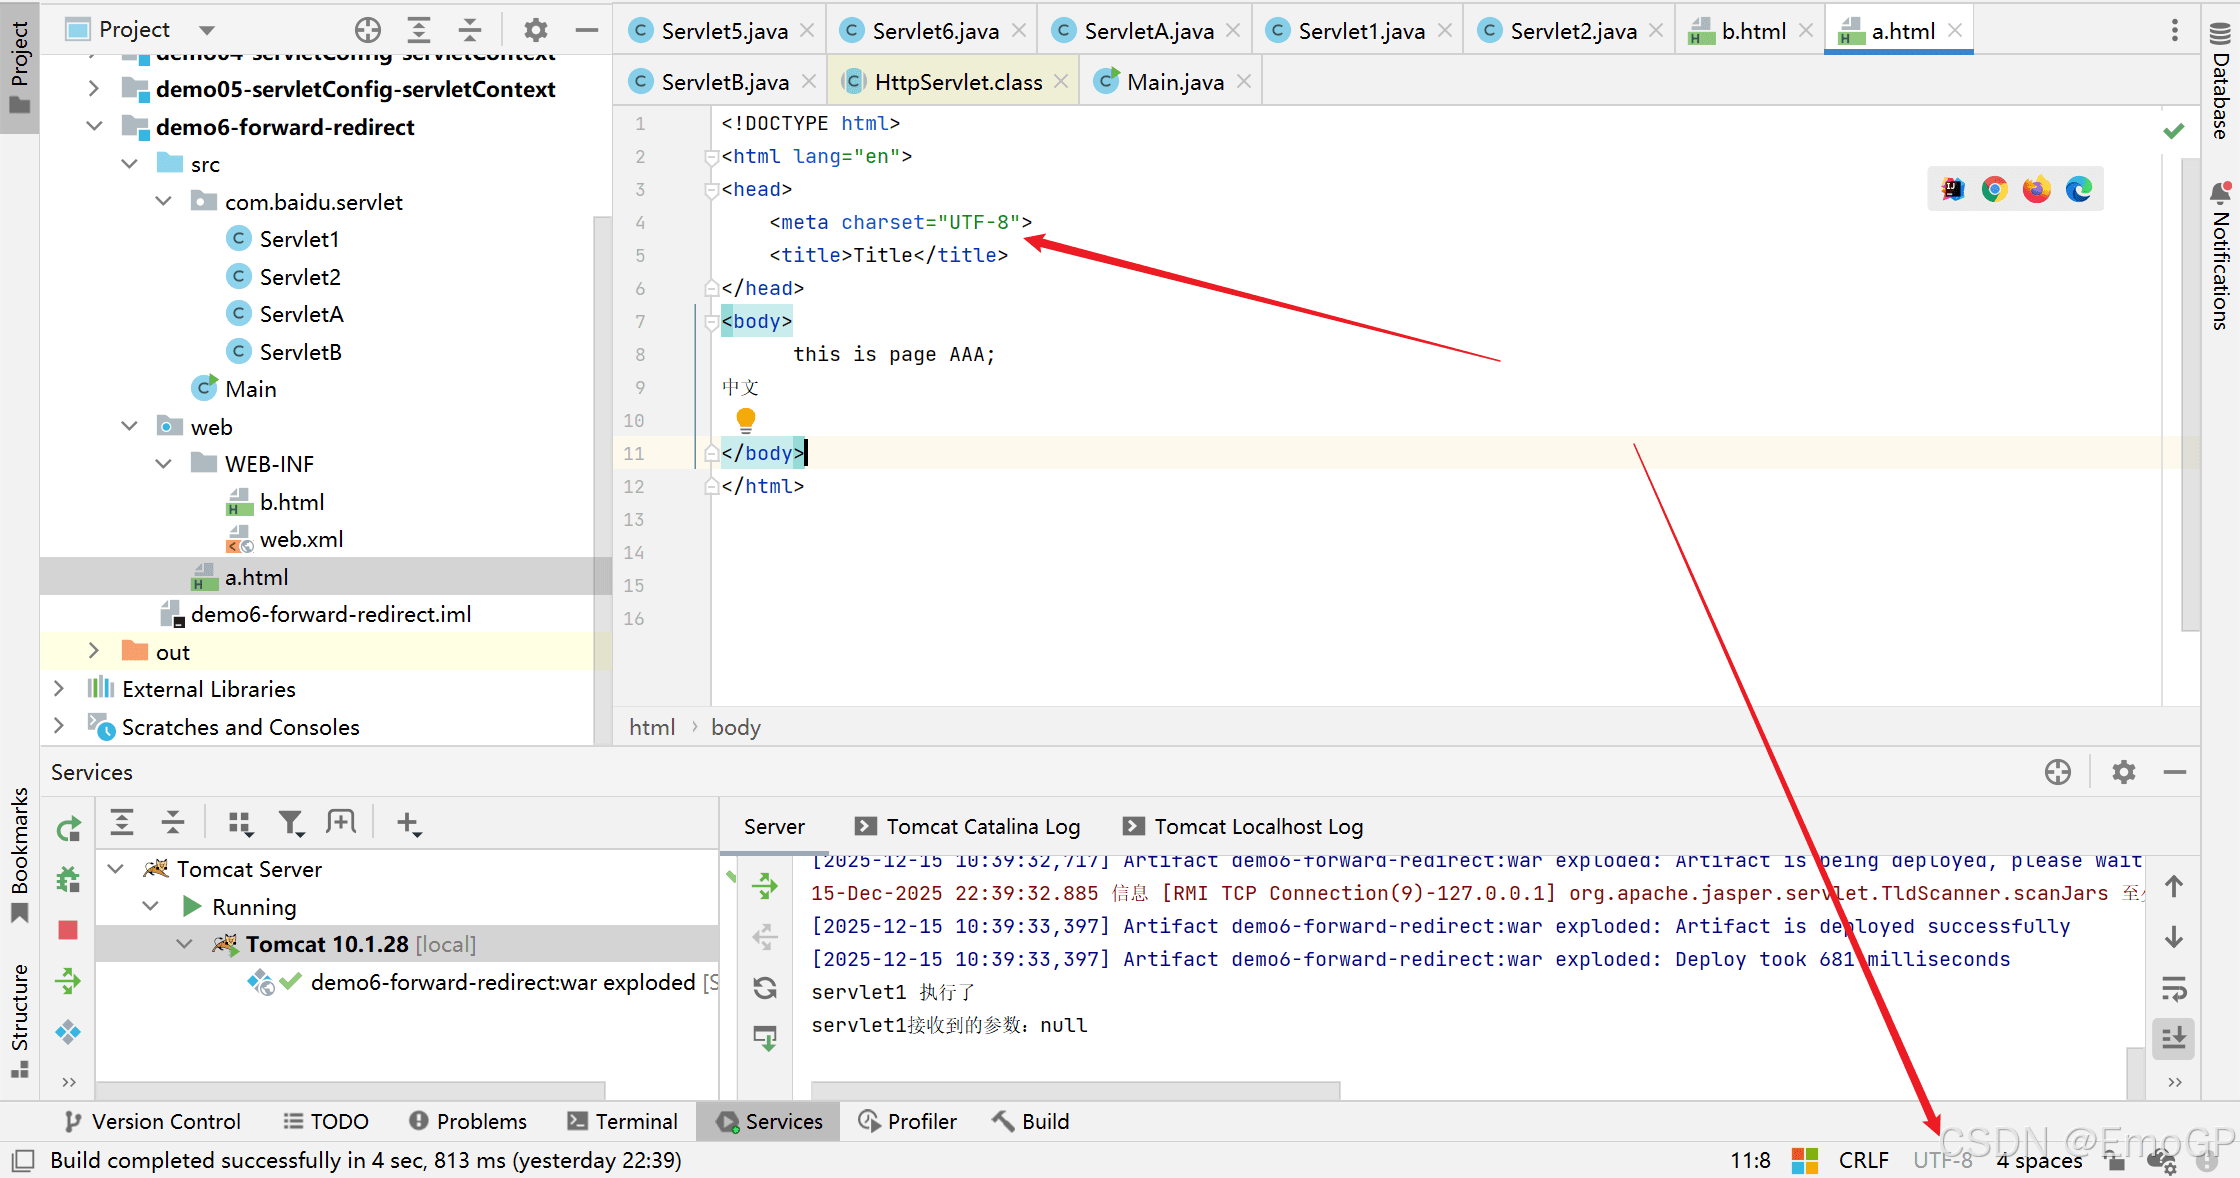
idea中比较智能
charset发生改变的时候,保存文件,会自动改变字符集
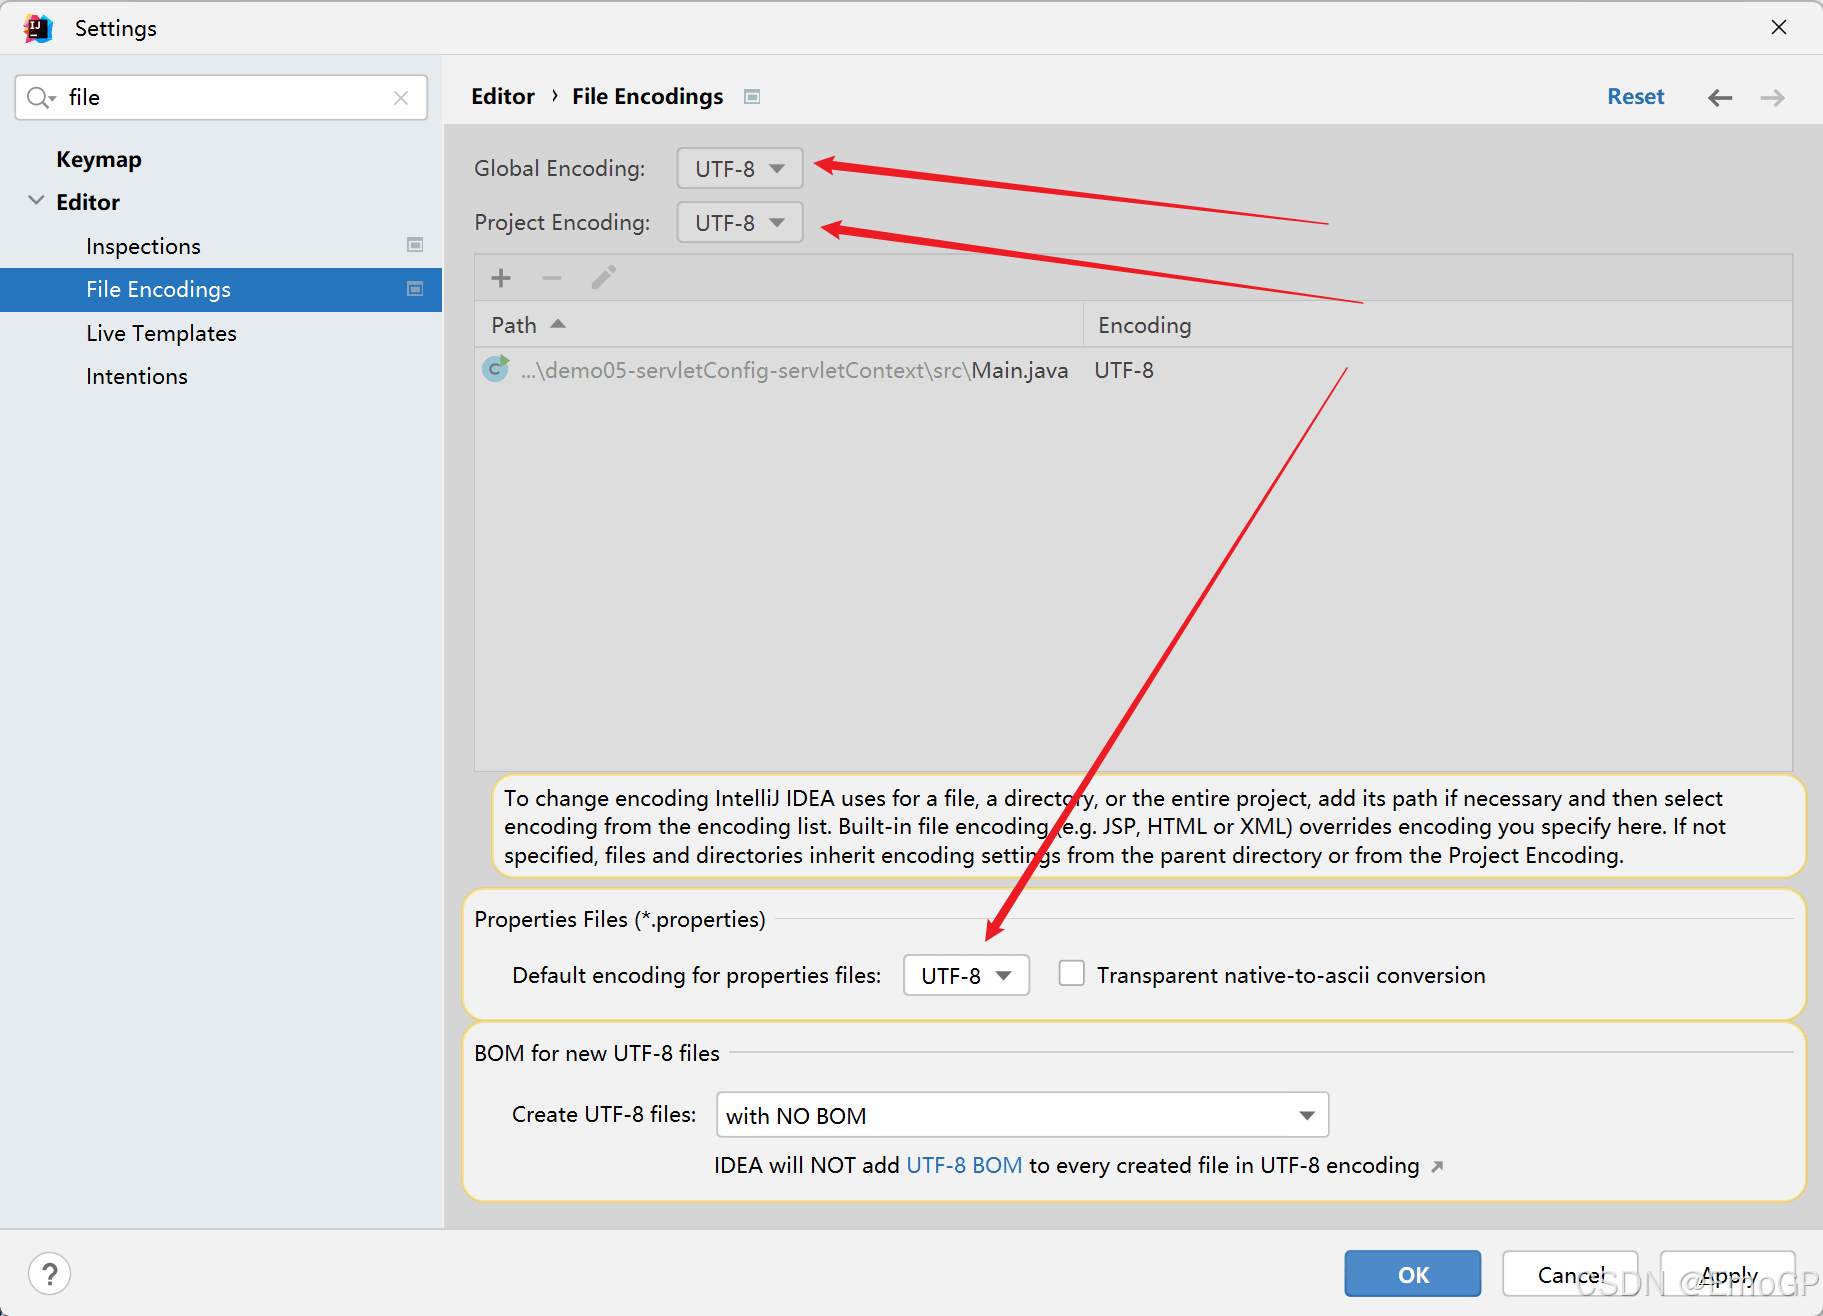
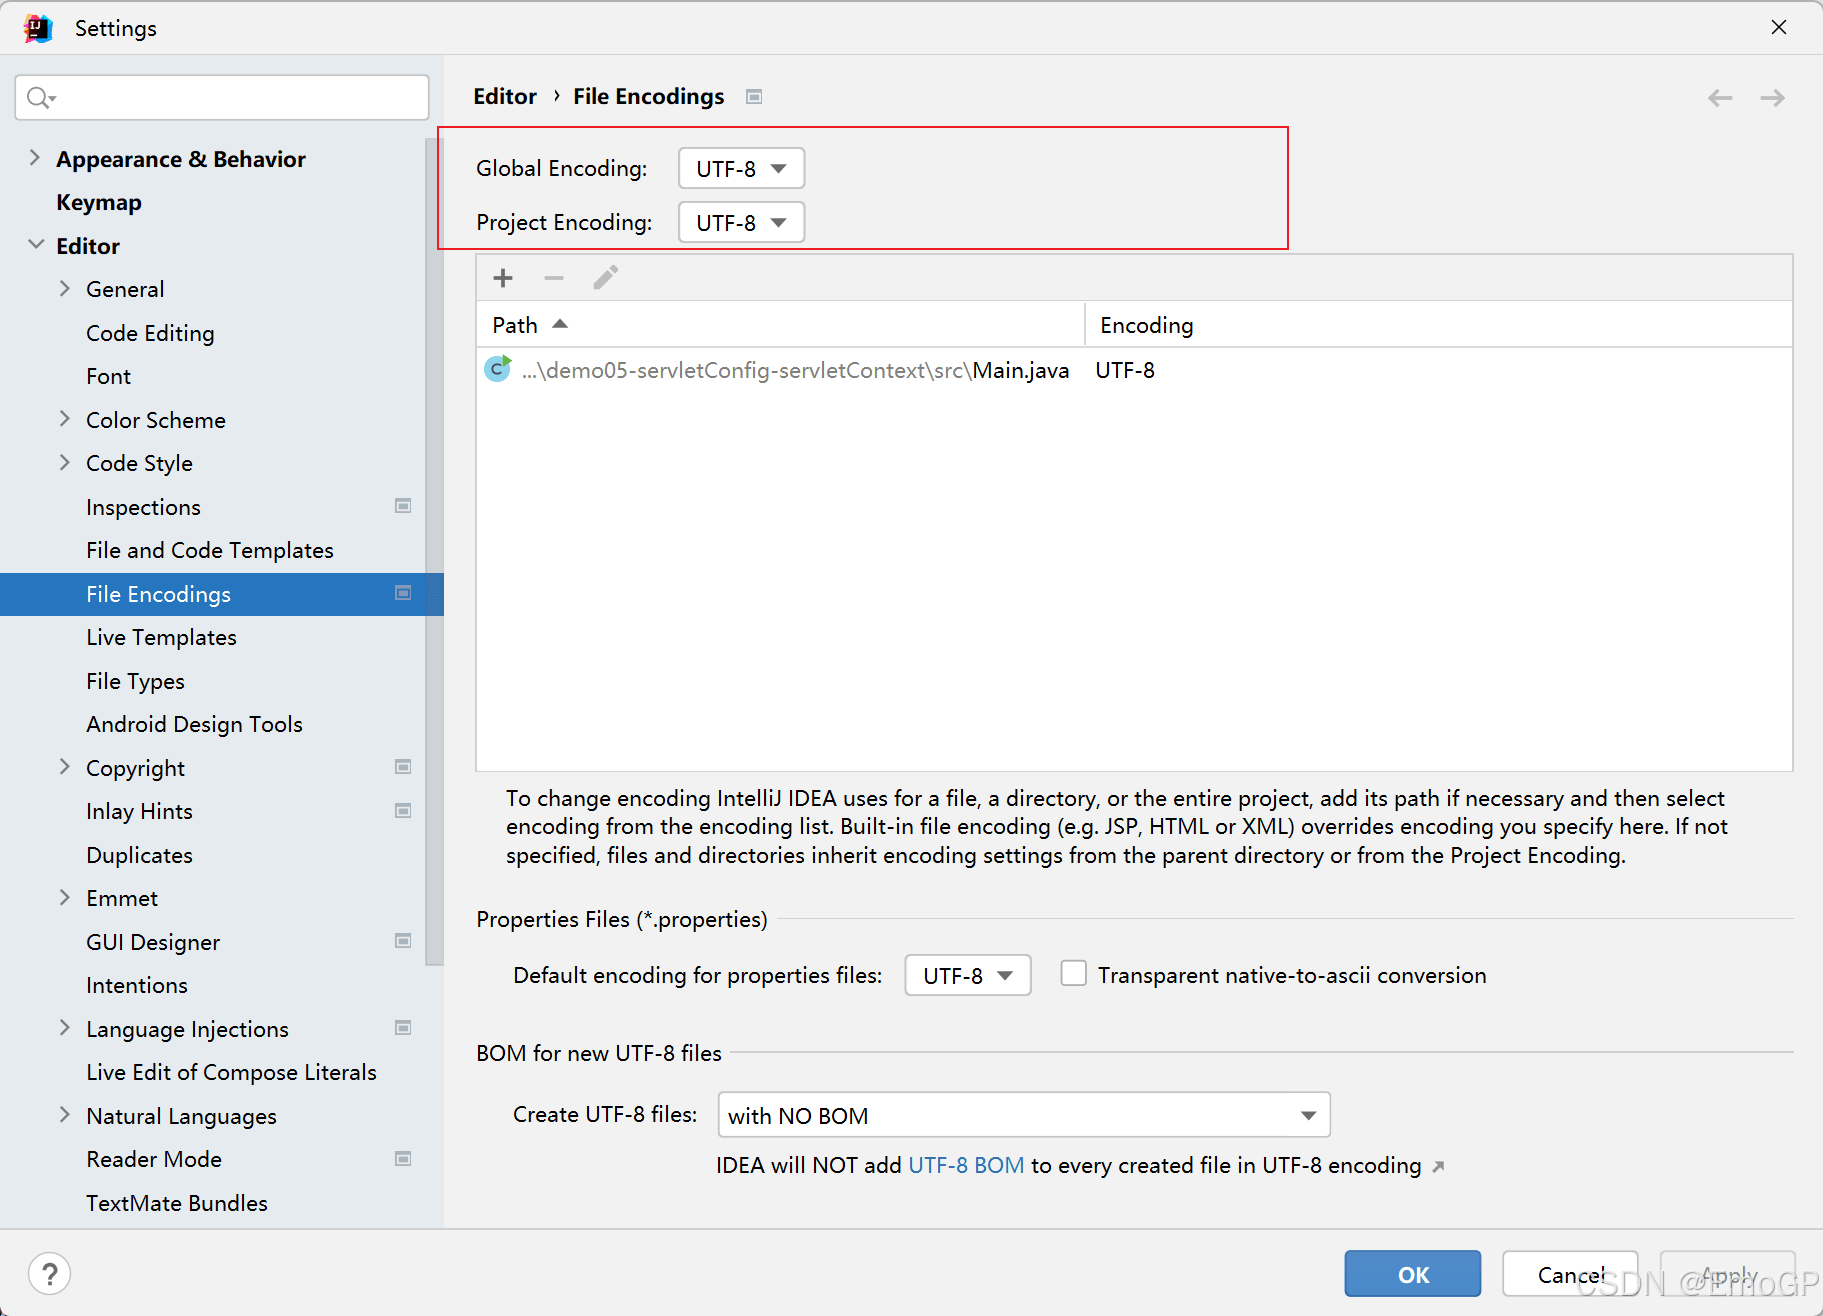
修改字符集
可在idea中修改如下几处都为utf-8
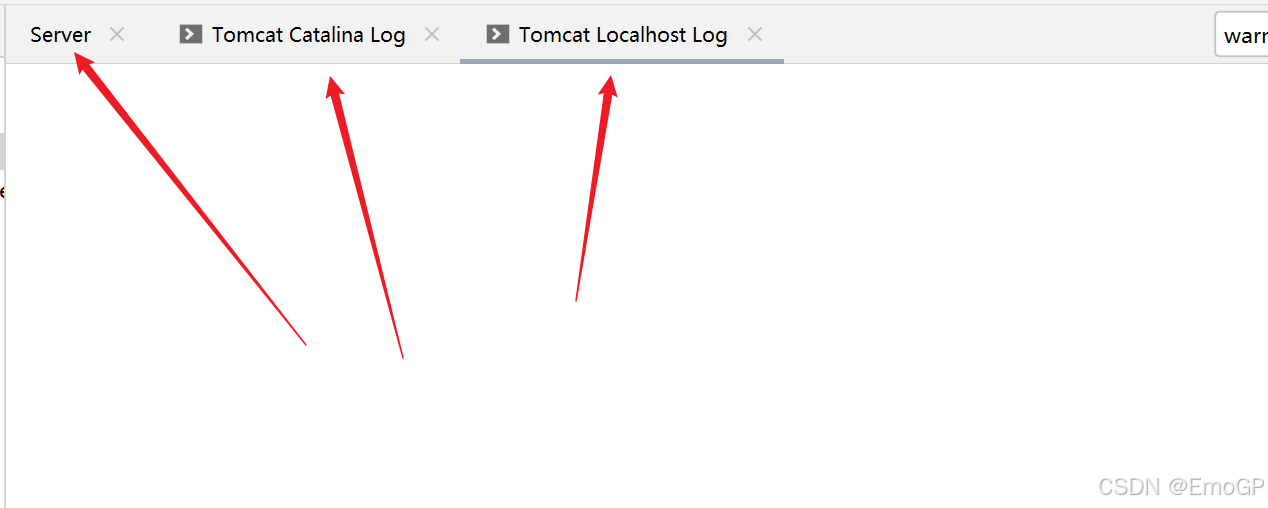
tomcat控制台乱码
tomcat在idea中启动时候,有三个打印日志窗口
consolehandler对应的就是server窗口
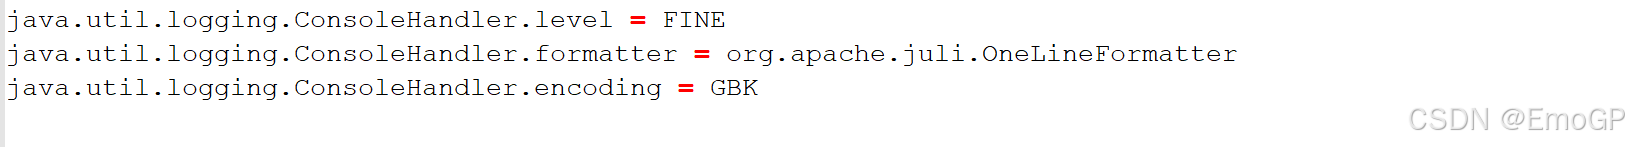
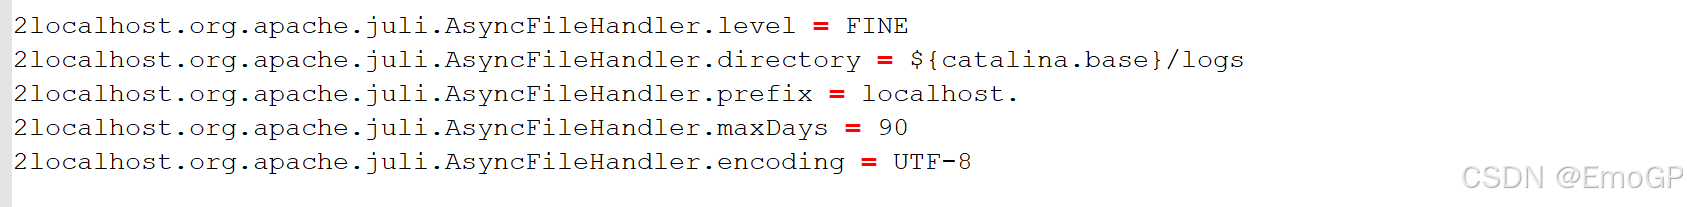
localhost对应tomcat localhost log
catalina对应tomcat catalina log
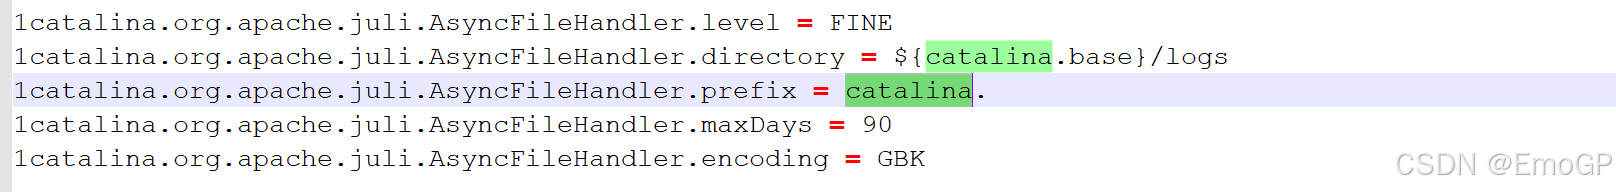
哪个乱码改哪个
sout乱码
如下内容设置为utf-8后,idea在编译的时候也会使用utf-8
可以设置jvm加载.class文件时使用utf-8字符集
-dfile.encoding=utf-8
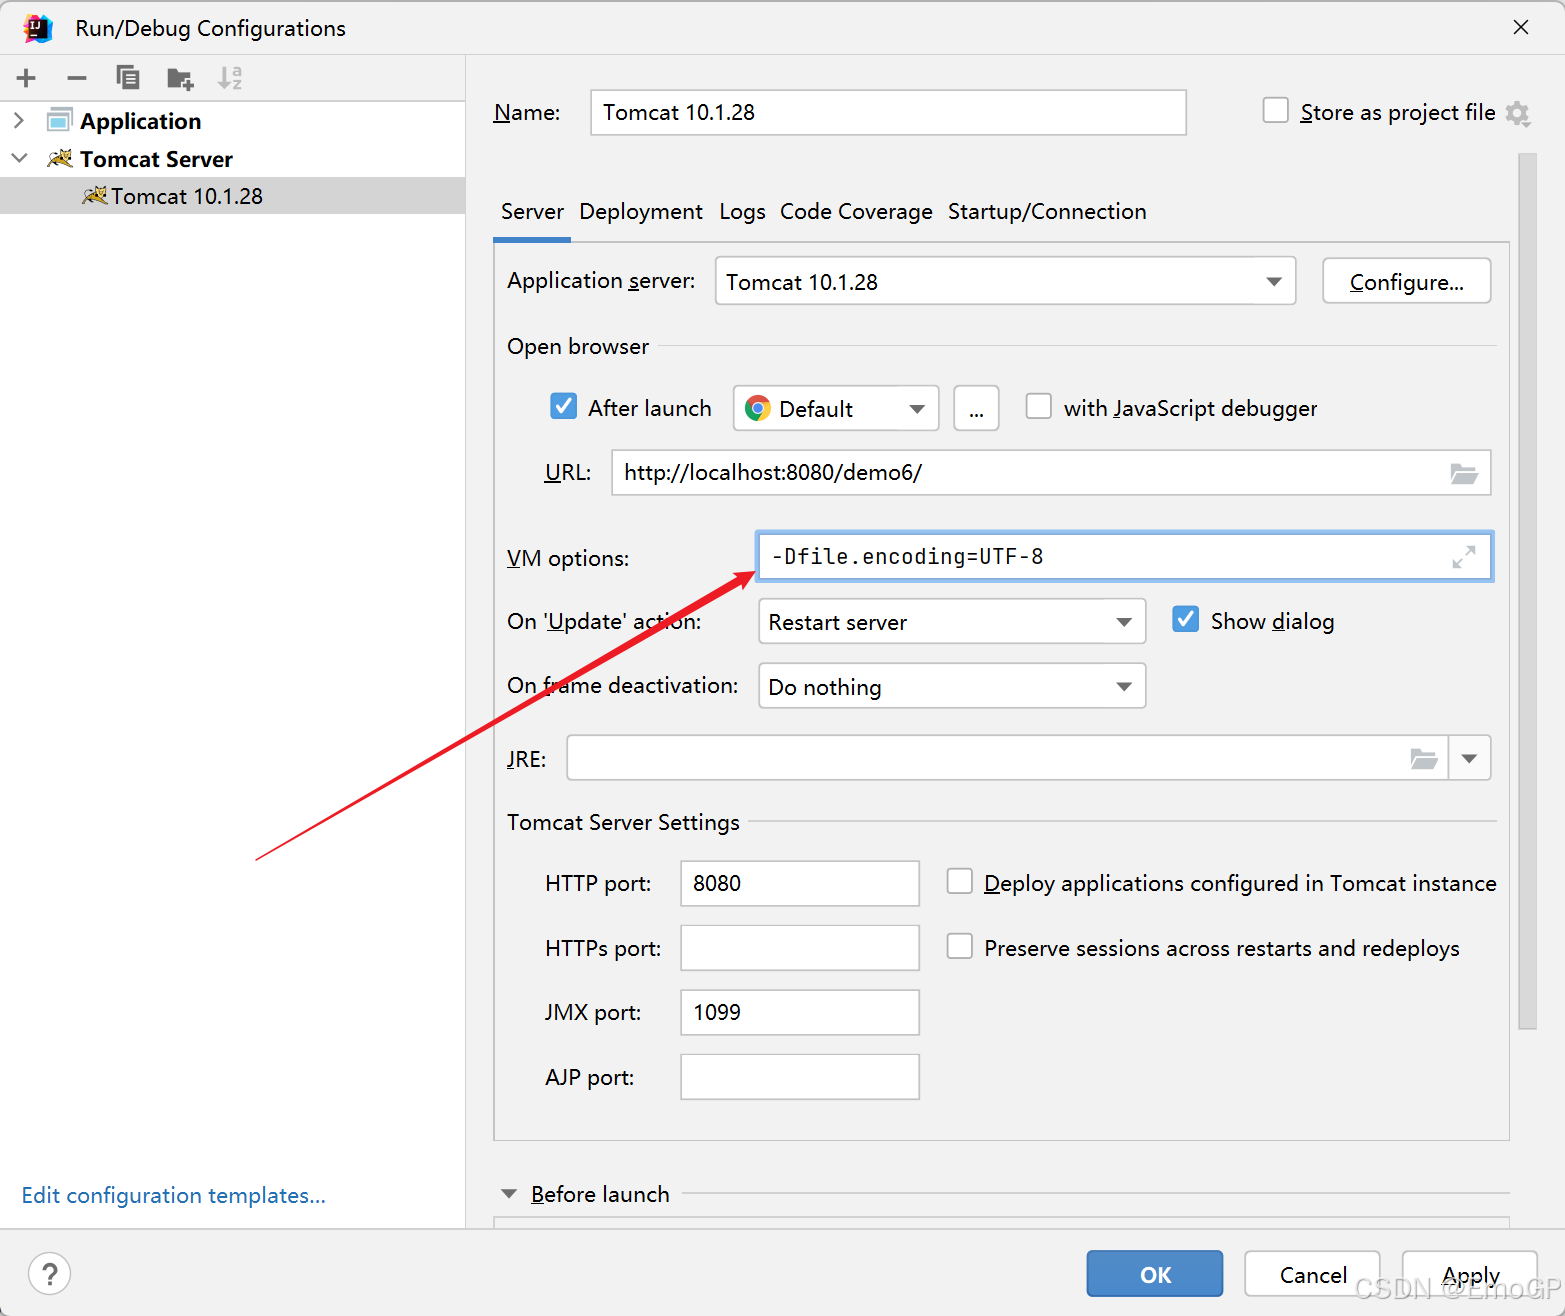
原理就是编译时和jvm加载字节码时字符集保持一致
总结
到此这篇关于javaweb中_html_tomcat日志_sout乱码问题解决办法的文章就介绍到这了,更多相关javaweb乱码问题内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!





发表评论