
 我要评论
一、设置索引
索引是一种可以让select语句提高效率的数据结构,可以起到快速定位的作用。
索引的优缺点
- 优点:某些情况下使用select语句大幅度提高效率,合适的索引可以优化mysql服务器的查询性能,从而起到优化mysql的作用。
- 缺点:表行数据的变化(index、update、delect),简历在表列上的索引也会自动维护,一定程度上会使dml操作变慢。索引还会占用磁盘额外的存储空间。
mysql索引操作
给表列创建索引:
建表时创建索引:
create table t(id int,name varchar(20),index idx_name (name));
给表追加索引:
alter table t add unique index idx_id(id);
给表的多列上追加索引
alter table t add index idx_id_name(id,name);
或者:
create index idx_id_name on t(id,name);
查看索引
使用show语句查看t表上的索引:
show index from t;
或者:
show keys from t;–mysql中索引也被称作keys
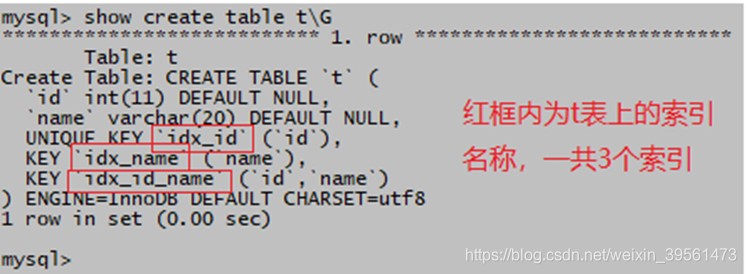
使用show create table语句查看索引:
show create table t\g
删除索引:
使用alter table命令删除索引:
alter table 表 drop index 索引名
使用drop index命令删除索引:
drop index 索引名 on 表
索引原理
例如一个学生信息表,我们设置学号(stu_id)为索引:
- 索引页之间存在一定的关联关系,一般为树形结构;分为根节点、分支节点、和叶子节点
- 根节点页中存放分段stu_id的起始值,以及值所对应的分支索引页号
- 分支索引页中存放分段stu_id的起始值,以及值所对应的叶子索引页号
- 叶子索引页中存放排序后的stu_id值,该值所对应的表页号, 下一个叶子索引页的页号
stu_id建立索引后,执行select name,sex,height from stu where stu_id=13查询过程如下:
1. 索引页存在关联关系,先找索引页号20的根节点,13在>=11和<17的范围内,需要查找25号索引页
2. 读取25号索引页,13在>=11和<14范围内,得到了26号叶子索引页
3. 读取26号叶子索引页,找到了13这个值,以及该值所对应表页的页号161,目前只得到了stu_id的值,还要得到name,sex,height等,因此需要再读一次编号为161的表页,里面存放了stu_id之外的值。
4. 读取161号表页,获得sname,sex,height等值
以上4步,只读取了3个索引页1个表页,共4个页,比读取所有表页(5000个页),按照stu_id=13挨个翻一遍效率要高,这也是有些情况下索引可以加速查询的原因。
二、使用explain 来查看你的 select 查询
关于mysql服务器是如何执行sql语句的相关信息可以用explain语句来查看,可以用explain语句查看执行过程的语句主要有select、insert、update、delete等,其使用方式是explain后接具体的增删改查sql语句。
例如:explain select * from test.t; 其返回形式为数据表,如下图所示:
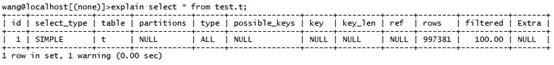
其中每个字段代表的含义如下:
通过:type、possible_keys和key三个字段,我们能清楚的知道查询语句是否使用了索引和使用了哪个索引。
| 列名 | 说明 |
|---|---|
| id | sql语句标识符,如果仅包含一个表的简单查询id始终为1;如果查询是多表连接查询,id按照顺便往下排 |
| select_type | 查询类型,例如:simple(简单查询不包括子查询和union运算符) |
| table | 语句相关的表名 |
| partitions | 语句相关的表分区,非分区表始终为null |
| type | 语句中表对象间的连接类型。如果值为all代表使用低效的全表扫方式;如果值为const代表仅有一行匹配的结果记录;如果值为range代表使用了索引范围查找 |
| possible_keys | 执行时有可能用到的索引名称 |
| key | 执行时实际用到的索引名称 |
| key_len | 执行时使用索引的长度 |
| ref | 哪些表列或常数列与“key”列出的索引名进行了比较操作 |
| rows | 执行的语句所涉及的行记录数,该数值对于innodb引擎的表为估算值不是实际真实值 |
| filtered | 返回结果的行记录数占执行中所有读取到的行记录数的百分比,该数值为估算值,最高为100 |
| extra | 执行sql语句时一些相关的补充信息 |
三、不要使用表达式作为查询条件
假设有一库为test,其中有一个以百万行记录的t表,t表的id列建有索引。
比较以下两种sql语句书写方式,比较运行时间:
方式一:
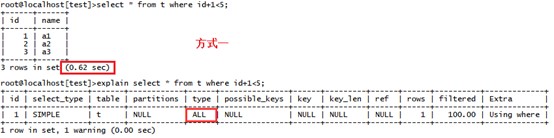
select * from t where id+1<5;
方式二:
select * from t where id<5-1;
方式一结果如下:
用时0.62秒,通过explain查看使用的查询key发现并没有使用索引来进行查询:
方式二结果如下:
用时小于0.00秒,通过explain查看使用的查询key发现使用了索引进行查询。
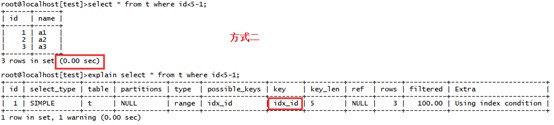
从实验结果看出,如果采用方式一(运行时间0.62秒),使用采用表达式的方式作为查询条件,条件列中的索引会失效,即便返回行数非常少,优化器也会使用低效的全表扫方式来解析sql语句;如果同样效果的语句采用方式二的写法,索引不会失效,查询效率高。
发生这种事情的深层原因在于:
大多数的mysql服务器都开启了查询缓存。这是提高性最有效的方法之一,而且这是被mysql的数据库引擎处理的。当有很多相同的查询被执行了多次的时候,这些查询结果会被放到一个缓存中,这样,后续的相同的查询就不用操作表而直接访问缓存结果了。 但是当使用表达式的时候,就会不使用缓存,因为这些函数的返回是会不定的易变的。
四、尽量使用in运行符来替代or运算
比较以下两种sql语句书写方式,比较运行时间:
方式一:
select * from t where id=1 or id=2 or id=3;
方式二:
select * from t where id in (1,2,3);
由于t表id列已添加索引,可以使用mysql自带压力测试工具mysqlslap,增加并发用户数量和查询次数比较两种方式的运行效率。
mysqlslap命令常用选项如下所示:
- -u:连接数据库用户名
- -p:链接数据库密码
- -concurrency:并发谅解客户端数量
- -query:运行的测试sql语句
- -create-schema:测试sql语句所在数据库
- -number-of-queries:所有链接客户端运行测试sql语句的次数
- -itreations:本次测试的重复执行次数
将方式一和方式二的sql语句,使用mysqlslap进行测试,采用100个并发客户端,所有客户端一共运行5000次,可以写成以下方式:
方式一:
mysqlslap -uroot -p --create-schrma=test --query='select * from t where id=1 or id=2 or id=3' --concurrency=100 --number-of-queries=5000
方式二:
mysqlslap -uroot -p --create-schema=test --query='select * from t where id in (1,2,3)' --concurrency=100 --number-of-queries=5000
测试结果如下:
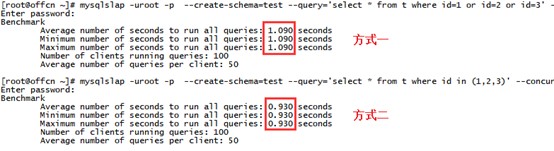
从实验结果可以看出,sql语句采用方式一的or方式50个并发用户执行5000次查询所用的时间为1.09秒;sql语句采用方式二的in方式50个并发用户执行5000次查询所用的时间为0.93秒,在写法等效的情况下,使用in来替代or效率更高。
五、条件列表值如果连续使用between替代in
继续以上实验,从t表中仅要找出id值为1,2,3的行,因为id值连续,可以使用以下第三种方式书写sql语句:
- 方式三:
select * from t where id between 1and 3
使用mysqlslap验证执行效率:
mysqlslap -uroot -p --create-schema=test --query='select * from t where id between 1 and 3' --concurrency=100 --number-of-queries=5000
结果如下:
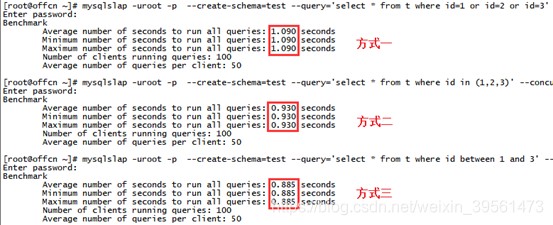
sql语句采用方式三between的写法,在50个并发用户执行5000次查询的测试时间为0.885秒,参照前述实验的测试结果,执行效率进一步提高。
可以看出如果条件列表数值连续的情况下,sql语句采用between的方式比用in方式效率更高。
六、无重复记录的结果集使用union all合并
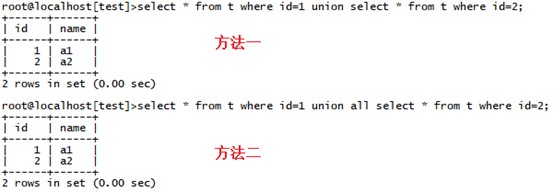
mysql数据库中使用union或union all运算符将一个或多个列数相同的查询结果集上下合并成为一个查询结果集。其中union会合并各个结果集中相同的记录行,重复记录只显示一次外加自动排序,而union all运算符不去重不排序。因此,对于无重复记录的多个查询结果集应当使用union all合并。
参见如下实验:
- 方法一:
select * from t where id=1 union select * from t where id=2;
- 方法二:
select * from t where id=1 union all select * from t where id=2;
结果如下:
使用mysqlslap测试:
- 方法一:
mysqlslap -uroot -p --create-schema=test --query='select * from t where id=1 union select * from t where id=2' --concurrency=100 --number-of-queries=5000;
- 方法二:
mysqlslap -uroot -p --create-schema=test --query='select * from t where id=1 union all select * from t where id=2' --concurrency=100 --number-of-queries=5000;
在50个并发用户执行5000次查询的测试中执行效率有所差异,如下图所示:
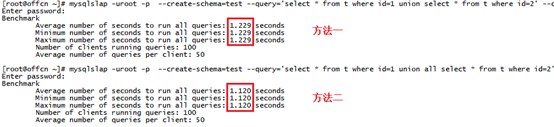
从测试结果可以看出,使用union运算符由于需要去除重复记录和排序,查询时间为1.229秒高于union all运算符的1.120秒。因此,对于无重复记录的结果集使用union all合并的效率要高。
七、有条件使用where就不使用having
在select查询语句中,where子句和having子句都起到对行记录过滤的作用,主要区别在于having子句是对group by子句产生的结果(可能包含聚合函数),而where子句先于having子句运行,主要目的是缩减查询结果集的行记录数。
实验需要复杂一些的数据表,可以通过http://downloads.mysql.com/docs/world.sql.zip链接下载mysql例子数据库。
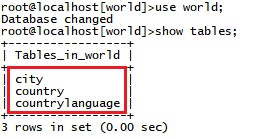
该数据库包含,country(国家),city(城市)和countrylanguage(国家语言)三张数据表。
例子数据库下载解压后包含world.sql文件,使用mysql客户端的source命令运行后,会创建包含前述三张表的world数据库。
mysql> select code,name from country where name='china';
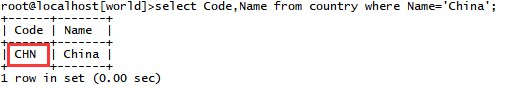
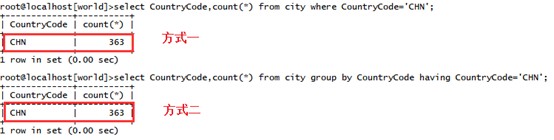
中国的国家编号是“chn”,如果要在city(城市)表中统计中国的城市数量,可以通过以下两种方式sql语句获取,其结果集相同:
- 方式一:
select countrycode,count(*) from city where countrycode='chn';
方式二:
select countrycode,count(*) from city group by countrycode having countrycode='chn';
将方式一和方式二的sql语句,使用mysqlslap进行测试,采用100个并发客户端,所有客户端一共运行5000次,可以写成以下方式:
- 方式一:
mysqlslap -uroot -p --concurrency=100 --iterations=1 --number-of-queries=5000 --create-schema=world --query="select countrycode,count(*) from city where countrycode='chn'"
- 方式二:
mysqlslap -uroot -p --concurrency=100 --iterations=1 --number-of-queries=5000 --create-schema=world --query="select countrycode,count(*) from city group by countrycode having countrycode='chn'"
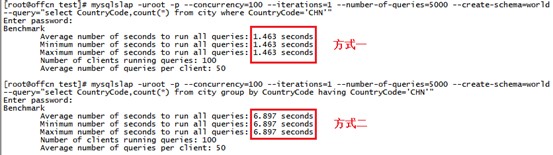
从以上测试结果看,使用where子句的方式一的sql书写方式仅仅耗时1.463秒,远低于耗时6.897秒的使用having子句的sql书写方式二。其主要原因是方式二的sql写法是在分组统计了所有国家城市的数量,然后再使用having子句将统计结果过滤出仅仅是中国的城市数量,sql解析器耗费了大量资源统计了与需求无关的数据,致使查询效率下降。因此,当需求明确时,应尽量使用where子句缩小查询结果集,然后再使用相关聚合函数进行统计分析。
八、使用like操作符时通配符要放在右侧
在书写sql语句时,如果在where或having子句中使用like模糊匹配操作符,通配符“%”或“_”不要写在匹配字符串的左侧,参见以下两种书写方式:
- 方式一:
select * from t where name like '_150_';
- 方式二:
select * from t where name like 'a150_';
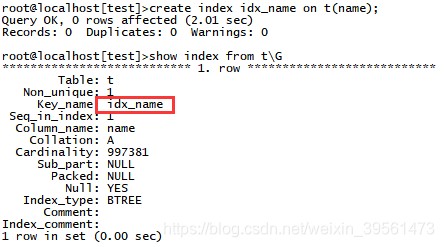
为test库t表的name列添加索引,索引名称idx_name:
mysql> create index idx_name on t(name);
mysql> show index from name;
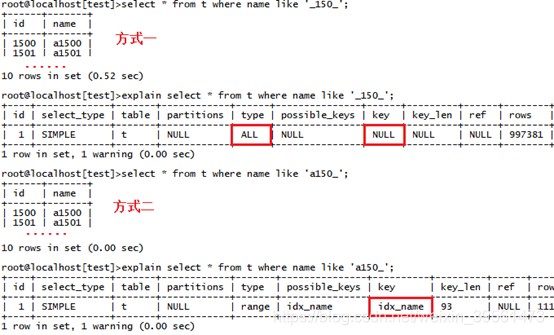
对比方式一和方式二的执行效果:
mysql> select * from t where name like '_150_';
mysql> explain select * from t where name like '_150_';
mysql> select * from t where name like 'a150_';
mysql> explain select * from t where name like 'a150_';
结果如下:
从测试结果可以看出,使用like操作符的查询条件列带有索引时,如果通配符放在最左边,索引会失效,sql优化器会选择效率低的全表扫解析方式,主要原因是对字符串类型创建索引时,mysql将从最左开始选取一部分(767字符,最多到3072字符)字符串,将其内容存入到索引中。
如果查询条件最左侧是可以匹配任意字符的通配符,无法定位具体的索引键值,优化器就会选择其他获取数据的方式而忽略索引的存在。因此,当带有索引的查询条件列是字符类型,如果使用模糊匹配操作符,不要将其放在最左侧,要放到第一个具体字符的右侧。
九、补充
数据库怎么优化查询效率?
储存引擎选择:
- 如果数据表需要事务处理,应该考虑使用 innodb,因为它完全符合 acid 特性。
- 如果不需要事务处理,使用默认存储引擎 myisam 是比较明智的分表分库,主从。
对查询进行优化,要尽量避免全表扫描,首先应考虑在 where 及 order by 涉及的列上建立索引
- 应尽量避免在 where 子句中对字段进行 null 值判断,否则将导致引擎放弃使用索引而进行全表扫描
- 应尽量避免在 where 子句中使用 != 或 <> 操作符,否则将引擎放弃使用索引而进行全表扫描
- 应尽量避免在 where 子句中使用 or 来连接条件,如果一个字段有索引,一个字段没有索引,将导致引擎放弃使用索引而进行全表扫描
update 语句,如果只更改 1、2 个字段,不要 update 全部字段,否则频繁调用会引起明显的性能消耗,同时带来大量日志
对于多张大数据量(这里几百条就算大了)的表 join,要先分页再 join,否则逻辑读会很高,性能很差。
十、总结
以上为个人经验,希望能给大家一个参考,也希望大家多多支持代码网。





发表评论