
 我要评论
一、先说结论:为什么社交场景需要图数据库
做社交应用最头疼的不是存储用户,而是理清用户之间的关系。拿 mysql 举例子,用户表、关注表、好友表、点赞表,各是一张表。查“朋友的朋友”要 join 三次,查“共同关注”要 join 两次再加一个 group by,查“两点最短路径”基本靠递归 cte 或者干脆在业务代码里循环——数据量一旦上来,sql 写起来痛苦,跑起来更痛苦。
图数据库的思路完全不一样。节点就是实体,边就是关系。你想知道 alice 和 bob 之间有什么联系,直接沿着边在图上走一遍就行。不用 join,不存在“关联查询”的概念,因为关系就是数据本身。
neo4j 是目前用得最多的开源图数据库,原生图存储、acid 事务、cypher 查询语言,生态也很成熟。spring boot 集成 neo4j 有官方 starter,几乎和 jpa 一样省事。本文就从实际的社交场景出发,把建模、集成、查询、以及性能优化这些事儿捋一遍,最后带一个简单的动态流 demo。
二、社交场景的图模型设计
2.1 我们到底要建模什么业务
模拟一个微博/twitter 类型的平台,核心就几件事:
- 好友关系:双向确认,强连接
- 关注关系:单向订阅,随时能取消
- 点赞:用户对动态的反馈
- 发布:用户产出动态
在关系型模型里,这四件事分别对应至少三张关联表加一个内容表。图模型里,它们都是节点之间的“边”。
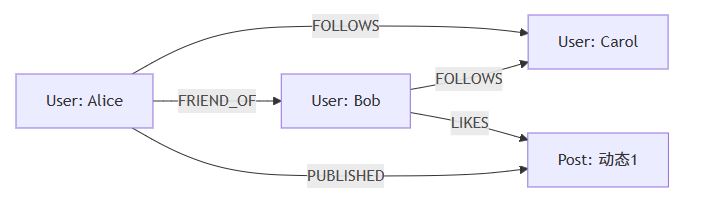
实体就两个:user 和 post。user 有 userid、name、age、city 这些属性;post 有 postid、content、createtime、likescount。关系就四条:
(user)-[:friend_of]->(user)好友关系(user)-[:follows]->(user)关注关系,方向是从关注者到被关注者(user)-[:published]->(post)发布(user)-[:likes]->(post)点赞
这里面有个建模习惯值得说一句:别什么都往节点上塞。比如“点赞”这个动作,有人会想着建一个 like 的中间节点,而不是一条 likes 边。在 neo4j 里,如果这个点赞本身需要携带额外的信息(比如点赞时间、点赞时的客户端类型),那完全可以给 likes 边加属性。图的边是可以带属性的,这一点和关系型数据库里“关联表才能带字段”的思路不同,刚开始从 sql 转过来的人容易不习惯。
举个实际例子。friend_of 关系可以加一个 since 属性表示成为好友的时间,加一个 level 表示亲密度。follows 加一个 createdat。likes 加一个 time。后面做推荐排序的时候这些属性就能派上用场。
2.2 属性和关系设计的取舍
图建模的核心原则就一句话:频繁出现在查询条件和结果展示里的业务属性,放在节点或关系上,别藏着掖着。
user 节点的属性大概长这样:
- userid:业务唯一标识,强烈建议保留。虽然 neo4j 有内部 id(
id()函数能取),但那个是物理 id,节点删除重建后就会变,不适合暴露给上层业务。 - name、age、city 这些就不多解释了,按需增减。
post 节点:
- postid:同上,业务 id 必须有。
- content:动态文本。
- createtime:发布时间,排序必用。
- likescount:冗余字段。严格来说这个值可以通过计算 likes 边的数量拿到,但那样每次查询都要遍历一遍边。如果目标是列表页快速展示,不如在写操作的时候顺带维护一个计数器。这种冗余在 nosql 和图数据库里非常常见,别怕冗余,怕的是查询慢。当然如果数据一致性要求高,也可以不冗余,看业务取舍。
2.3 关系方向的约定
这里有一个容易踩的坑,说清楚点。
follows 关系的方向,我约定的是“关注者”指向“被关注者”。比如 alice follows bob,那边的方向是 alice -[:follows]-> bob。这意味着查询 alice 关注了谁,走 outgoing;查询 alice 的粉丝,走 incoming。这个方向一旦定了,整个项目的查询都要遵守,部门里如果有多个人在写代码,这个方向的约定最好写在文档里,不然后面写查询的人大概率会搞反。
friend_of 比较特殊,它是双向的。我建议图里只建一条边,查询的时候方向用 undirected。如果你在代码里建了两条边(a->b 和 b->a),那你维护的时候必须保证两条边同时存在或同时删除,否则数据就出现幽灵关系了。spring data neo4j 里 direction.undirected 就是干这个用的。
下面是模型的可视化表示,用 mermaid 画一下:
三、spring boot 集成 neo4j
3.1 依赖和配置
maven 加一个依赖就行:
<dependency>
    <groupid>org.springframework.boot</groupid>
    <artifactid>spring-boot-starter-data-neo4j</artifactid>
</dependency>
配置文件里面注意几点。neo4j 的连接协议现在是 bolt://,不是 http://。用户名密码就是 neo4j 数据库本身的认证信息。如果你启用了多数据库功能,还可以指定 database,不指定就默认用 neo4j 库:
spring:
  data:
    neo4j:
      uri: bolt://localhost:7687
      username: neo4j
      password: password
      database: social
有一点需要提前说明:spring boot 2.x 和 3.x 在这块的配置前缀不同。spring boot 2.x 用 spring.data.neo4j.* 也有用 spring.neo4j.* 的,到 3.x 统一成了 spring.neo4j.*。上面示例写的是 spring.data.neo4j,是 spring boot 3 之前的写法;如果你用的是 3.x,记得写成 spring.neo4j。这个坑比较隐蔽,不报错但连不上,遇到就检查一下这个。
3.2 实体类定义
spring data neo4j 的注解风格跟 jpa 很像,但语义有差别。看代码:
import org.springframework.data.neo4j.core.schema.*;

@node("user")
public class user {

    @id
    @generatedvalue
    private long id;  // neo4j 内部 id,只有这个支持自增

    @property("userid")
    private string userid;  // 业务 id,别拿这个当 @id

    @property("name")
    private string name;

    @property("age")
    private integer age;

    @property("city")
    private string city;

    // 好友关系。注意 direction.undirected,因为好友是双向的
    @relationship(type = "friend_of", direction = relationship.direction.undirected)
    private set<user> friends;

    // 关注的人(出边)
    @relationship(type = "follows", direction = relationship.direction.outgoing)
    private set<user> following;

    // 粉丝(入边)
    @relationship(type = "follows", direction = relationship.direction.incoming)
    private set<user> followers;

    // 发布的动态(出边)
    @relationship(type = "published", direction = relationship.direction.outgoing)
    private set<post> posts;

    // 点赞过的动态(出边)
    @relationship(type = "likes", direction = relationship.direction.outgoing)
    private set<post> likedposts;

    // getters/setters 省略
}
有个细节要单独说一下:@id 标注的那个字段,是一个 long 类型的 neo4j 内部 id。这个 id 是 neo4j 自己管理的,你不需要也不能去设置它。业务上的 userid 用 @property 映射成一个普通属性就行。如果你想让 userid 在数据库层面唯一,加 @unique 注解;如果要加普通索引,用 @index。
还有关系如果自带属性,就需要单独定义一个类。用 @relationshipproperties 注解,@targetnode 表示这个字段指向目标节点:
@relationshipproperties
public class friendship {

    @relationshipid
    private long id;

    @property("since")
    private localdatetime since;

    @property("level")
    private integer level;

    @targetnode
    private user friend;
}
然后在 user 里这样用:
@relationship(type = "friend_of", direction = relationship.direction.undirected)
private list<friendship> friendships;
注意这里有版本差异:spring data neo4j 6.x 之前,关系实体用的是 @relationshipentity 和 @startnode、@endnode;6.x 之后就改成了 @relationshipproperties 和 @targetnode。网上很多老文章还在用旧写法,如果你是新项目,直接用新的。
3.3 repository 层
neo4jrepository<t, id> 接口和 jparepository 用法几乎一样:
public interface userrepository extends neo4jrepository<user, long> {

    optional<user> findbyuserid(string userid);

    @query("match (u:user) where u.city = $city return u")
    list<user> findbycity(@param("city") string city);
}
保存的逻辑要单独说一句,因为这里跟 jpa 的直觉不太一样。在 spring data neo4j 里,save() 是深度保存——你把整个实体对象图丢给它,它会自动对比数据库里已有的节点和关系,然后做增量更新。比如:
user user = userrepository.findbyuserid(userid).orelsethrow();
user target = userrepository.findbyuserid(targetuserid).orelsethrow();
user.getfollowing().add(target);
userrepository.save(user);
这一顿操作下来,follows 关系就建好了,不需要你显式地再调一个 saverelation() 之类的方法。这个特性在早期版本里有一些性能问题(比如更新一个字段会把整个对象图都检查一遍),但从 6.x 开始,spring data neo4j 的映射机制已经做得比较聪明了。不过我还是建议:如果只是要加一条关系,用 cypher 直接写更轻量。比如:
@modifying
@query("match (a:user {userid: $userid}), (b:user {userid: $targetid}) " +
       "merge (a)-[:follows]->(b)")
void addfollowing(@param("userid") string userid, @param("targetid") string targetid);
这个写法只涉及两个节点和一条边的操作,性能比加载整个实体再 save 高得多。而且 merge 天然幂等,重复执行不会创建重复关系。
四、cypher 查询实战
4.1 朋友的朋友推荐
这是社交网络里最经典的查询。逻辑说起来很简单:我 -> 我的朋友 -> 他的朋友,排除已经是我好友的人和我自己,按共同好友数排序:
match (me:user {userid: $userid})-[:friend_of]->(friend:user)-[:friend_of]->(candidate:user)
where not (me)-[:friend_of]->(candidate) and candidate <> me
return candidate, count(*) as mutualcount
order by mutualcount desc
limit 10
翻译成大白话:“先找到我的所有好友,再找到这些好友的好友,他们就是候选用户。然后排除掉已经是我的好友的人,剩下的就是陌生人了。按共同好友数量排个序,取前 10 个。”
这个查询如果要用 sql 写,基本就是 4 个 join 加一个 outer join 排除已关注的,再 group by,性能还不行。
如果要把深度扩到三度,就在 match 里多写一跳:
match (me:user {userid: $userid})-[:friend_of]->(:user)-[:friend_of]->(:user)-[:friend_of]->(candidate:user)每多一层,遍历成本会大不少,后面性能优化的部分会细说。
4.2 共同关注分析
这个需求也特别常见:“我和你都关注了谁”。cypher 写起来很直观——关注关系的交汇点:
match (u1:user {userid: $userid1})-[:follows]->(common:user)<-[:follows]-(u2:user {userid: $userid2})
return common
从 u1 出发走到 common,再从 u2 出发也能走到 common,那 common 就是共同关注。这个查询在 sql 里就是两个子查询做 intersect。
4.3 最短路径
“我和某个大 v 之间隔了几个人?”这是图数据库的看家本领。cypher 里的 shortestpath 函数:
match (start:user {userid: $startid}), (end:user {userid: $endid}),
      path = shortestpath((start)-[:friend_of|follows*..6]-(end))
return [n in nodes(path) | n.userid] as userids, length(path) as depth
这里有两个细节值得注意。一是 *..6 限制最大路径深度为 6,这是必须的——如果用户之间的图是连通的,无限深度下去查询可能跑几分钟都结束不了。二是我同时允许了 friend_of 和 follows 两种关系类型,因为在现实场景里,一个人可能不是你朋友但你关注了他,你们之间也许已经有一条路径了。
nodes(path) 返回路径上所有节点列表,然后我把它映射成了 userid 的列表。最后返回 {userids: ["a","b","c"], depth: 2} 这样的结构给前端渲染。
4.4 动态流拉取
获取我关注的所有人发布的动态,按时间倒序。cypher 里就是一个 2 跳遍历:
match (me:user {userid: $userid})-[:follows]->(followee:user)-[:published]->(post:post)
where not (me)-[:blocked]-(followee)
return post, followee.name as author
order by post.createtime desc
limit $limit
注意里面那个 not (me)-[:blocked]-(followee) 是拉黑过滤。这个在 sql 里又得加一个 left join 来排除,图数据库里写一个 not 模式就行。
五、性能优化:从索引到查询设计
5.1 为什么图查询比 sql 深层关联快
关系型数据库模拟图遍历的方式是“索引 + join”。每深一层,就是一次新的 join。join 本身的成本还好,问题是对于“找朋友的朋友”这种查询,你根本不知道要 join 几次、每次有多少行需要参与匹配。sql 优化器面对这种情况往往只能生成一个很笨的执行计划,不是索引失效,而是这些查询本身就和关系型模型“八字不合”。
neo4j 的底层存储是一种叫 index-free adjacency 的结构,简单说就是每个节点直接存储所有邻接边的引用。遍历的时候做的不是“查找”,而是“顺着指针走”,跟链表遍历差不多。这种遍历的成本和整个图的大小没有关系,只看你从起点出发搜索了多少个节点。你从 100 万人的社交网络里找一个人的二度好友,和从 1 万人的网络里找,如果搜索的邻居数量差不多,耗时也差不多。
这就解释了为什么图规模大了以后,关系型数据库扛不住深度查询,而图数据库却依然稳定。但注意,这不是说图数据库在所有场景下都更快。如果你的查询是“全表扫描然后做个聚合”,比如统计每个城市的用户数——这种是典型的 olap 场景,图数据库反而要遍历所有节点,性能一点都不好。选型要看核心查询是不是“关系深度”相关的。
5.2 索引该建在哪
一个常见的误区:图数据库不需要索引。准确的表述是:遍历不需要索引,但你找起始节点需要。
拿前面那个朋友推荐查询举例。match (me:user {userid: $userid}) 这一步,如果 userid 没有索引,neo4j 就得全库扫一遍 user 节点才能找到 me。这跟在 mysql 里 where 一个没有索引的字段是一个道理,查起来很费劲。
所以该建的索引还是要建:
- userid 建唯一约束,这个必须有
- name 如果经常按用户名搜,建普通索引
- post.createtime 如果经常做时间范围查询,建索引
- user.city 如果按城市筛选用户多,建索引
spring data neo4j 的实体类上可以直接用注解:
@property("userid")
@unique
private string userid;
或者用 @index:
@property("name")
@index
private string name;
更推崇的方式是直接用 cypher 显式建,这样索引的可见性更高:
create constraint unique_user_id if not exists for (n:user) require n.userid is unique;
create index user_city_index if not exists for (n:user) on (n.city);
create index post_createtime_index if not exists for (n:post) on (n.createtime);
5.3 查询设计层面的注意事项
cypher 的坑主要在两个地方。
第一,避免无界路径。(a)-[:follows*]-(b) 这种不带深度上限的写法,基本等于让数据库在整张图上做 bfs,数据一多必卡。所有路径查询都带上界,*..6 这种,哪怕是 *..10 也算有个约束。
第二,用 profile 检查执行计划。neo4j 浏览器里对查询加 profile 前缀,能看到每个算子消耗了多少行、做了多少次 db hits。刚开始写复杂查询的时候强烈建议过一遍,很多时候你会发现某个 cypher 写法实际扫描的行数比预想的大一个数量级。
应用层缓存也值得做。neo4j 自身的 page cache 负责把热数据留在内存里,这个可以通过调整 jvm 配置来扩大,但对应用层来说更可控的是 spring cache。比如共同关注分析这个接口,如果两个用户之间的关系只有他们自己触发刷新才会变,完全可以缓存个 1~5 分钟:
@cacheable(value = "commonfollowing", key = "#userid1 + ':' + #userid2")
public list<user> getcommonfollowing(string userid1, string userid2) {
    return userrepository.findcommonfollowing(userid1, userid2);
}
缓存了之后记得设计失效策略。最简单的做法是设置 ttl,比如 5 分钟过期;如果要做精准失效,就得在用户取关或者新增关注的业务逻辑里主动 evict。这个看你们团队的容错程度,社交场景里数据短暂不一致一般可以接受。
5.4 写入性能
大批量导数据的时候别用 save() 一条一条插入,慢到怀疑人生。正确做法是分批量用 unwind:
unwind $batch as row
match (u:user {userid: row.userid})
match (f:user {userid: row.followsuserid})
merge (u)-[:follows]->(f)
$batch 是一个 list 参数,每次传几百上千条进去,一条 cypher 就能完成批量关系创建。初次迁移千万级数据的话,更推荐用 neo4j 自带的 neo4j-admin import 工具做离线导入,那玩意儿是纯批量写入,速度是 api 方式的几十倍。
六、demo:朋友圈动态流
前面讲的都偏理论,这里做一个能直接跑的最小实现。
repository 层:
public interface postrepository extends neo4jrepository<post, long> {

    @query("match (me:user {userid: $userid})-[:follows]->(followee:user)-[:published]->(post:post) " +
           "where post.createtime >= $since " +
           "return post, followee.name as author " +
           "order by post.createtime desc limit $limit")
    list<map<string, object>> findfeedbyuser(@param("userid") string userid,
                                             @param("since") localdatetime since,
                                             @param("limit") int limit);
}
service 层:
@service
public class feedservice {

    private final postrepository postrepository;
    private final userrepository userrepository;

    public feedservice(postrepository postrepository, userrepository userrepository) {
        this.postrepository = postrepository;
        this.userrepository = userrepository;
    }

    @transactional(readonly = true)
    public feedresult getfeed(string userid) {
        localdatetime since = localdatetime.now().minusdays(7);
        list<map<string, object>> feed = postrepository.findfeedbyuser(userid, since, 50);

        // 顺便给用户推荐一波可能感兴趣的人
        list<map<string, object>> suggestions = userrepository.findfriendsuggestions(userid, 10);

        feedresult result = new feedresult();
        result.setfeed(feed);
        result.setsuggestedusers(suggestions);
        return result;
    }
}
controller 层:
@restcontroller
@requestmapping("/api/social")
public class socialcontroller {

    private final feedservice feedservice;

    public socialcontroller(feedservice feedservice) {
        this.feedservice = feedservice;
    }

    @getmapping("/feed/{userid}")
    public feedresult getfeed(@pathvariable string userid) {
        return feedservice.getfeed(userid);
    }
}
一个简单的接口串起了动态流拉取和好友推荐两条查询链路。假设测试数据是 alice 关注了 bob 和 carol,bob 发了一条动态,carol 发了一条动态,那 alice 访问 /api/social/feed/alice 就会看到这两条动态,按时间倒序排列。同时还能看到推荐的 dave——因为 dave 和 alice 有 2 个共同关注的人。
七、最后聊几句图数据库的边界
neo4j 这种原生图数据库解决的是“关系深度”问题。你的业务如果核心是找路径、分析关系链、做社交图谱这类,那就选它。但别听说图数据库好就啥都往里塞。下面几种情况用它就不太合适:
- 纯属性聚合,比如“统计 30 岁北京用户数量”。这种场景 mysql 分组聚合比图数据库快得多。
- 数据模型极端规整,比如电商订单表,永远是一对多的固定层级关系,关系型数据库就是最简单直接的方案,没必要引入额外的技术组件。
- 亿级节点以上。neo4j 社区版是单机的,数据量到了一个量级,你得引入分布式图数据库,运维成本会明显上升。
一个务实的做法是混合架构:mysql 负责核心事务和业务数据,neo4j 负责关系深度分析,通过消息队列或者事件机制同步数据。
spring boot 和 neo4j 的集成体验,从工程角度说的话,spring data neo4j 帮我们把大部分样板代码省掉了,熟悉 jpa 的人基本能无缝切换。至于 cypher 本身,花个半天看看文档、跑一遍例子就能上手,算是图数据库里最好学的查询语言了。建议直接拿一个真实场景的查询需求练一下手,比看着文档硬啃有意思得多。
以上就是springboot集成neo4j构建社交关系图的实践指南的详细内容,更多关于springboot neo4j构建社交关系图的资料请关注代码网其它相关文章!




发表评论