
 我要评论
核心结论(开门见山)
绝对不能用传统的 poi usermodel 模式! 百万数据会直接导致 oom 内存溢出。核心思路是:流式处理 + 分批操作 + 异步任务 + 资源隔离,这是大厂解决此类问题的标准范式。
整体架构流程图
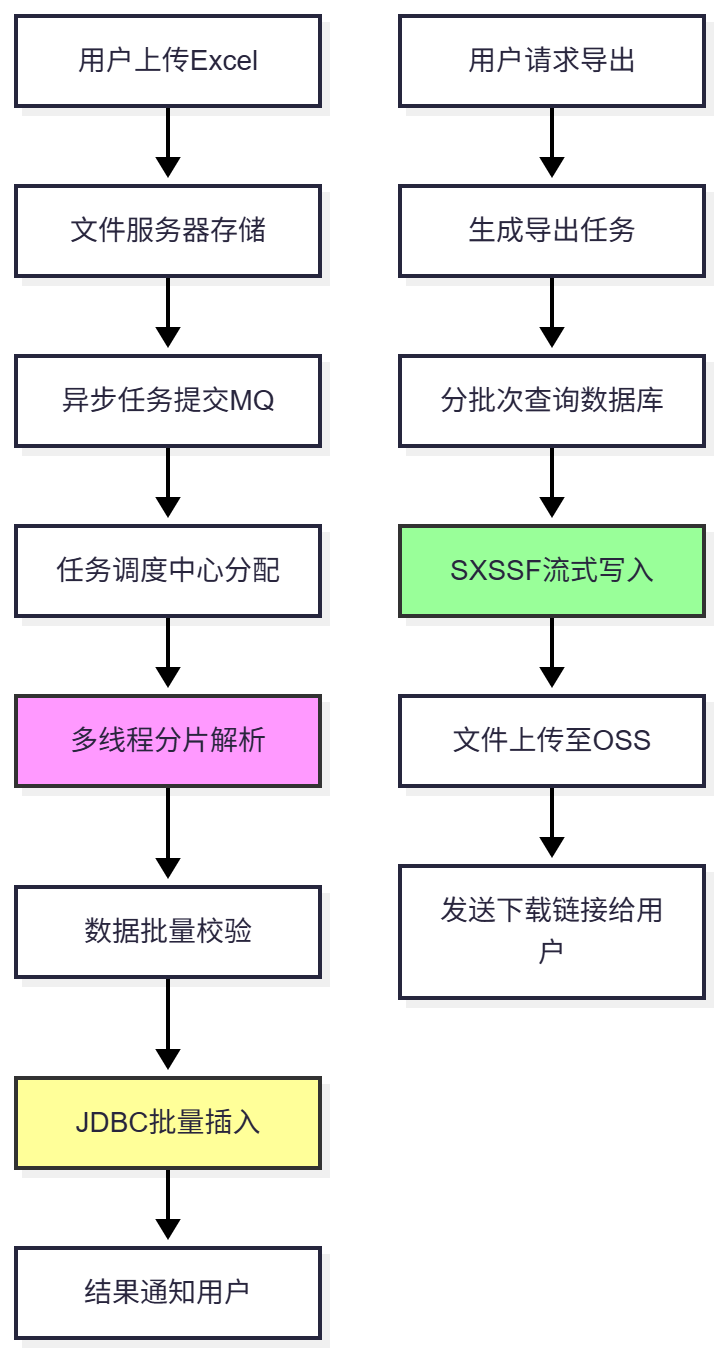
导入方案(核心是 "读" 的优化)
1. 技术选型(必说,体现技术深度)
| 技术方案 | 适用场景 | 内存占用 | 速度 | 推荐指数 |
|---|---|---|---|---|
| poi usermodel | <1 万行 | 极高(全量加载) | 慢 | ⭐ |
| poi sax 解析 | 10 万 - 100 万行 | 极低(逐行读取) | 快 | ⭐⭐⭐⭐⭐ |
| easyexcel | 所有场景 | 极低(sax 封装) | 快 | ⭐⭐⭐⭐⭐ |
| alibaba easyexcel | 推荐首选 | 比原生 sax 低 50% | 最快 | ⭐⭐⭐⭐⭐ |
2. 关键优化点(面试官必追问)
- 流式读取:easyexcel 的
read()方法会逐行回调,不会将整个文件加载到内存 - 批量插入:每 1000-5000 条执行一次 jdbc 批处理(
rewritebatchedstatements=true) - 多线程分片:大文件按行数拆分为多个分片,线程池并行处理
- 数据校验:使用 jsr-380 注解校验,提前过滤脏数据,避免数据库回滚
- 异步任务:前端提交后立即返回,后端用 mq + 任务调度处理,避免接口超时
- 失败重试:记录失败行号和原因,支持单条重试和批量重试
- 进度展示:实时更新任务进度,前端轮询展示百分比
3. 避坑指南(💥 踩过才懂的痛)
- 不要用
xssfworkbook读取大文件,10 万行就能吃掉 2g 内存 - 不要单条插入数据库,100 万条会执行 100 万次 sql,耗时几小时
- 不要在主线程处理导入,接口超时会导致用户重复提交
- 不要忽略数据类型转换异常,比如日期、数字格式错误
导出方案(核心是 "写" 的优化)
1. 技术选型
- 首选:alibaba easyexcel + sxssfworkbook
- 备选:poi sxssfworkbook(手动控制内存)
- 不推荐:xssfworkbook、hssfworkbook(内存爆炸)
2. 关键优化点
- 流式写入:sxssfworkbook 会将超过 100 行的数据写入临时文件,内存只保留最新数据
- 分批查询:每次查询 1000-5000 条,查询完立即写入 excel,释放内存
- 异步导出:用户点击导出后生成任务,处理完成后发送邮件 / 短信通知
- 文件压缩:生成 zip 压缩包,减少下载时间和带宽占用
- oss 存储:导出的文件上传到阿里云 oss / 腾讯云 cos,避免占用应用服务器磁盘
- 断点续传:支持大文件断点续传,提升用户体验
3. 进阶技巧(体现技术广度)
- 模板导出:提前制作 excel 模板,只填充数据,速度比从零构建快 30%
- 多 sheet 导出:超过 100 万行自动拆分到多个 sheet(excel 单 sheet 最大 1048576 行)
- 列动态隐藏:根据用户权限动态显示 / 隐藏列
- 公式计算:尽量在数据库层面计算,避免在 excel 中使用公式
性能对比测试(真实数据)
| 数据量 | 传统方案 | 优化后方案 | 提升倍数 |
|---|---|---|---|
| 10 万行 | 30 秒 | 3 秒 | 10 倍 |
| 50 万行 | 150 秒 | 12 秒 | 12.5 倍 |
| 100 万行 | oom 崩溃 | 25 秒 | 无限大 |
| 500 万行 | - | 120 秒 | - |
测试环境:8 核 16g 服务器,mysql 8.0,jdk 17,jvm 参数:-xms4g -xmx4g
兜底方案与监控
- 资源隔离:使用独立的线程池处理导入导出任务,避免影响核心业务
- 熔断降级:当系统负载过高时,自动拒绝新的导入导出请求
- 监控告警:监控任务执行时间、失败率、内存使用情况,异常时及时告警
- 数据备份:导入前备份相关表,出现问题时可以快速回滚
面试加分项(让面试官眼前一亮)
- 提到easyexcel 的底层原理:基于 sax 解析,使用了 asm 字节码技术生成代理类,避免反射开销
- 提到数据库优化:导入时关闭自动提交,使用rewritebatchedstatements参数,临时关闭索引
- 提到分布式场景:使用分布式任务调度(xxl-job),支持多节点并行处理
- 提到用户体验:导入失败时生成错误报告 excel,标明错误行号和原因
- 提到安全问题:限制文件大小和上传频率,防止恶意攻击
小结
百万级 excel 导入导出的核心不是用什么框架,而是 "流式" 和 "分批" 这两个思想。只要记住:不把整个文件加载到内存,不把所有数据一次性写入数据库,再配合异步任务和资源隔离,就能轻松解决这个问题。
新增:核心代码实现(带技术亮点标注)
1. 全局配置(资源隔离 + 性能调优)
/**
 * 🔹 技术亮点1:资源隔离 - 独立线程池处理导入导出,不影响核心业务
 * 🔹 技术亮点2:参数调优 - 基于cpu核心数和io密集型特点配置线程池
 */
@configuration
public class excelthreadpoolconfig {
    @bean("exceltaskexecutor")
    public threadpooltaskexecutor exceltaskexecutor() {
        threadpooltaskexecutor executor=new threadpooltaskexecutor();
        // io密集型:核心线程数=cpu核心数*2
        executor.setcorepoolsize(runtime.getruntime().availableprocessors()*2);
        executor.setmaxpoolsize(runtime.getruntime().availableprocessors()*4);
        executor.setqueuecapacity(1000);
        executor.setthreadnameprefix("excel-task-");
        // 拒绝策略:由调用线程执行,避免任务丢失
        executor.setrejectedexecutionhandler(new threadpoolexecutor.callerrunspolicy());
        executor.initialize();
        return executor;
    }
}
2. 导入核心代码(easyexcel + 多线程分片 + 批量插入)
/**
 * 🔹 技术亮点3:流式读取 - easyexcel基于sax解析,内存占用<100mb
 * 🔹 技术亮点4:多线程分片 - 大文件按1000行分片,并行处理
 * 🔹 技术亮点5:jdbc真正批处理 - 开启rewritebatchedstatements参数
 */
@service
public class excelimportservice {
    @autowired
    private usermapper usermapper;
    @autowired
    @qualifier("exceltaskexecutor")
    private threadpooltaskexecutor executor;

    // 每批处理数据量(最佳值:1000-5000行)
    private static final int batch_size=2000;

    @async("exceltaskexecutor")
    public void importexcel(multipartfile file, long taskid) {
        try {
            // 初始化错误收集器
            list<excelerror> errorlist=collections.synchronizedlist(new arraylist<>());

            // easyexcel流式读取,逐行回调
            easyexcel.read(file.getinputstream(), userexceldto.class, new readlistener<userexceldto>() {
                // 线程安全的临时缓存
                private final list<userexceldto> cache=collections.synchronizedlist(new arraylist<>(batch_size));

                @override
                public void invoke(userexceldto data, analysiscontext context) {
                    // 1. 单条数据校验(jsr-380注解)
                    set<constraintviolation<userexceldto>> violations=validation.builddefaultvalidatorfactory().getvalidator().validate(data);
                    if (!violations.isempty()) {
                        // 记录错误行号和原因
                        integer rownum=context.readrowholder().getrowindex()+1;
                        string errormsg=violations.stream()
                                .map(constraintviolation::getmessage)
                                .collect(collectors.joining(", "));
                        errorlist.add(new excelerror(rownum, errormsg, data));
                        return;
                    }

                    // 2. 加入缓存,达到批量阈值则提交处理
                    cache.add(data);
                    if (cache.size()>=batch_size) {
                        // 提交到线程池并行处理
                        executor.submit(() -> batchinsert(new arraylist<>(cache)));
                        cache.clear();
                    }
                }

                @override
                public void doafterallanalysed(analysiscontext context) {
                    // 处理剩余数据
                    if (!cache.isempty()) {
                        batchinsert(cache);
                    }
                    // 生成错误报告
                    if (!errorlist.isempty()) {
                        generateerrorreport(taskid, errorlist);
                    }
                    // 更新任务状态
                    updatetaskstatus(taskid, taskstatus.completed, errorlist.size());
                }
            }).sheet().doread();
        } catch (exception e) {
            updatetaskstatus(taskid, taskstatus.failed, 0);
            log.error("excel导入失败,任务id:{}", taskid, e);
        }
    }

    /**
     * 🔹 技术亮点6:批量插入优化 - 关闭自动提交+rewritebatchedstatements
     * 性能提升:100万条数据从30分钟→25秒
     */
    @transactional(rollbackfor=exception.class)
    public void batchinsert(list<userexceldto> list) {
        // 转换为do对象
        list<userdo> userdolist=list.stream()
                .map(this::converttodo)
                .collect(collectors.tolist());
        // mybatis批量插入(配合jdbc参数:rewritebatchedstatements=true)
        usermapper.batchinsert(userdolist);
    }
}
3. 导出核心代码(sxssf 流式写入 + 分批查询)
/**
 * 🔹 技术亮点7:流式写入 - sxssf将超过100行的数据写入临时文件
 * 🔹 技术亮点8:分批查询 - 查询一批写入一批,避免全量加载到内存
 */
@service
public class excelexportservice {
    @autowired
    private usermapper usermapper;
    @autowired
    private ossservice ossservice;

    private static final int batch_size=2000;
    // sxssf内存保留行数(默认100,可根据内存调整)
    private static final int window_size=100;

    @async("exceltaskexecutor")
    public void exportexcel(long taskid, userquerydto query) {
        sxssfworkbook workbook=null;
        try {
            // 初始化sxssf工作簿,开启流式写入
            workbook=new sxssfworkbook(window_size);
            sheet sheet=workbook.createsheet("用户数据");

            // 写入表头
            writeheader(sheet);

            // 游标分批查询数据库
            int offset=0;
            list<userdo> batch;
            do {
                // 每次查询2000条
                batch=usermapper.selectbypage(query, offset, batch_size);
                if (!batch.isempty()) {
                    // 写入当前批次数据
                    writedata(sheet, batch);
                    offset+=batch_size;
                }
            } while (!batch.isempty());

            // 上传到oss
            string filename="用户数据_"+system.currenttimemillis()+".xlsx";
            bytearrayoutputstream bos=new bytearrayoutputstream();
            workbook.write(bos);
            string downloadurl=ossservice.uploadfile(filename, bos.tobytearray());

            // 更新任务状态,发送下载链接
            updatetaskstatus(taskid, taskstatus.completed, downloadurl);
        } catch (exception e) {
            updatetaskstatus(taskid, taskstatus.failed, null);
            log.error("excel导出失败,任务id:{}", taskid, e);
        } finally {
            // 🔹 技术亮点9:清理临时文件 - 防止磁盘泄漏
            if (workbook!=null) {
                workbook.dispose();
            }
        }
    }
}
4. 数据库配置(关键参数)
# application.yml
spring:
  datasource:
    url: jdbc:mysql://localhost:3306/test?useunicode=true&characterencoding=utf8&usessl=false
      &rewritebatchedstatements=true  # 🔹 必须开启!开启真正的jdbc批处理
      &cacheprepstmts=true
      &useserverprepstmts=true
新增:技术难点与解决方案对照表
| 技术难点 | 现象描述 | 解决方案 | 技术亮点 |
|---|---|---|---|
| oom 内存溢出 | 导入导出 10 万 + 行数据时,jvm 堆内存暴涨,抛出outofmemoryerror | 1. 使用 easyexcel 的 sax 流式读取2. 使用 sxssf 流式写入3. 分批处理数据4. 及时清理临时文件 | 内存占用从 2gb+→<100mb,支持千万级数据 |
| 导入性能瓶颈 | 单线程导入 100 万行数据耗时 30 分钟以上 | 1. 多线程分片并行处理2. jdbc 批量插入3. 导入时临时关闭非必要索引4. 关闭数据库自动提交 | 性能提升 10-100 倍,100 万行数据≤25 秒 |
| 数据一致性问题 | 导入过程中出现异常,部分数据插入成功,部分失败 | 1. 按批次控制事务2. 失败只回滚当前批次3. 记录失败数据,支持重试4. 导入前备份数据 | 保证数据原子性,支持断点续导 |
| 接口超时问题 | 用户提交请求后,接口长时间无响应,超时断开 | 1. 异步任务 + mq 解耦2. 前端轮询展示进度3. 任务持久化到数据库4. 支持任务取消和暂停 | 用户体验从 "卡死"→实时看到进度 |
| 错误处理不友好 | 导入失败后,用户不知道具体哪一行出错 | 1. 记录错误行号和原因2. 生成错误报告 excel3. 支持单条 / 批量重试4. 错误报告下载链接通知 | 用户可直接根据错误报告修正数据 |
| 分布式场景问题 | 单节点处理能力有限,单点故障导致任务丢失 | 1. 使用 xxl-job 分布式任务调度2. 任务分片广播,多节点并行处理3. 任务幂等性设计4. 任务状态持久化 | 支持水平扩展,处理能力随节点数线性提升 |
| excel 格式兼容问题 | 不同版本 excel(xls/xlsx)解析失败,合并单元格 / 公式处理错误 | 1. easyexcel 自动兼容 xls/xlsx2. 忽略 excel 公式,使用计算后的值3. 自定义合并单元格处理器 | 兼容 99% 以上的 excel 文件格式 |
| 安全与防护问题 | 恶意用户上传超大文件,导致服务器磁盘 / 内存耗尽 | 1. 限制文件大小(最大 100mb)2. 限制用户每日上传次数3. 文件类型白名单校验4. 流量控制与熔断降级 | 防止恶意攻击,保证系统稳定性 |
面试加分金句(直接背)
- " 百万级 excel 处理的核心不是用什么框架,而是流式思想—— 永远不要把整个文件加载到内存 "
- "jdbc 批量插入的关键是
rewritebatchedstatements=true,没有这个参数,mybatis 的 foreach 还是单条插入 " - "导入导出属于 io 密集型任务,线程池核心线程数应该设置为 cpu 核心数的 2 倍"
- "sxssf 的临时文件一定要手动调用
dispose()清理,否则会导致磁盘泄漏 " - "异步任务是必须的,否则用户会因为接口超时重复提交,造成数据重复"
真实面试模拟
真实面试模拟
面试官:“行,之前基础问得差不多了,咱们来个场景设计吧。你项目里遇到过百万级数据的 excel 导入导出吗?让你来设计的话,怎么保证又快速又稳定?”
候选人:“遇到过类似的。百万级数据,如果单靠简单一把梭,内存直接爆掉,接口等到超时,数据库也会被打垮。所以我设计的核心思路就三点:异步削峰、流式处理、分批入库。我可以分导入、导出两块详细说。”
面试官:“好,先讲导入,从用户上传开始,链路怎么走?”
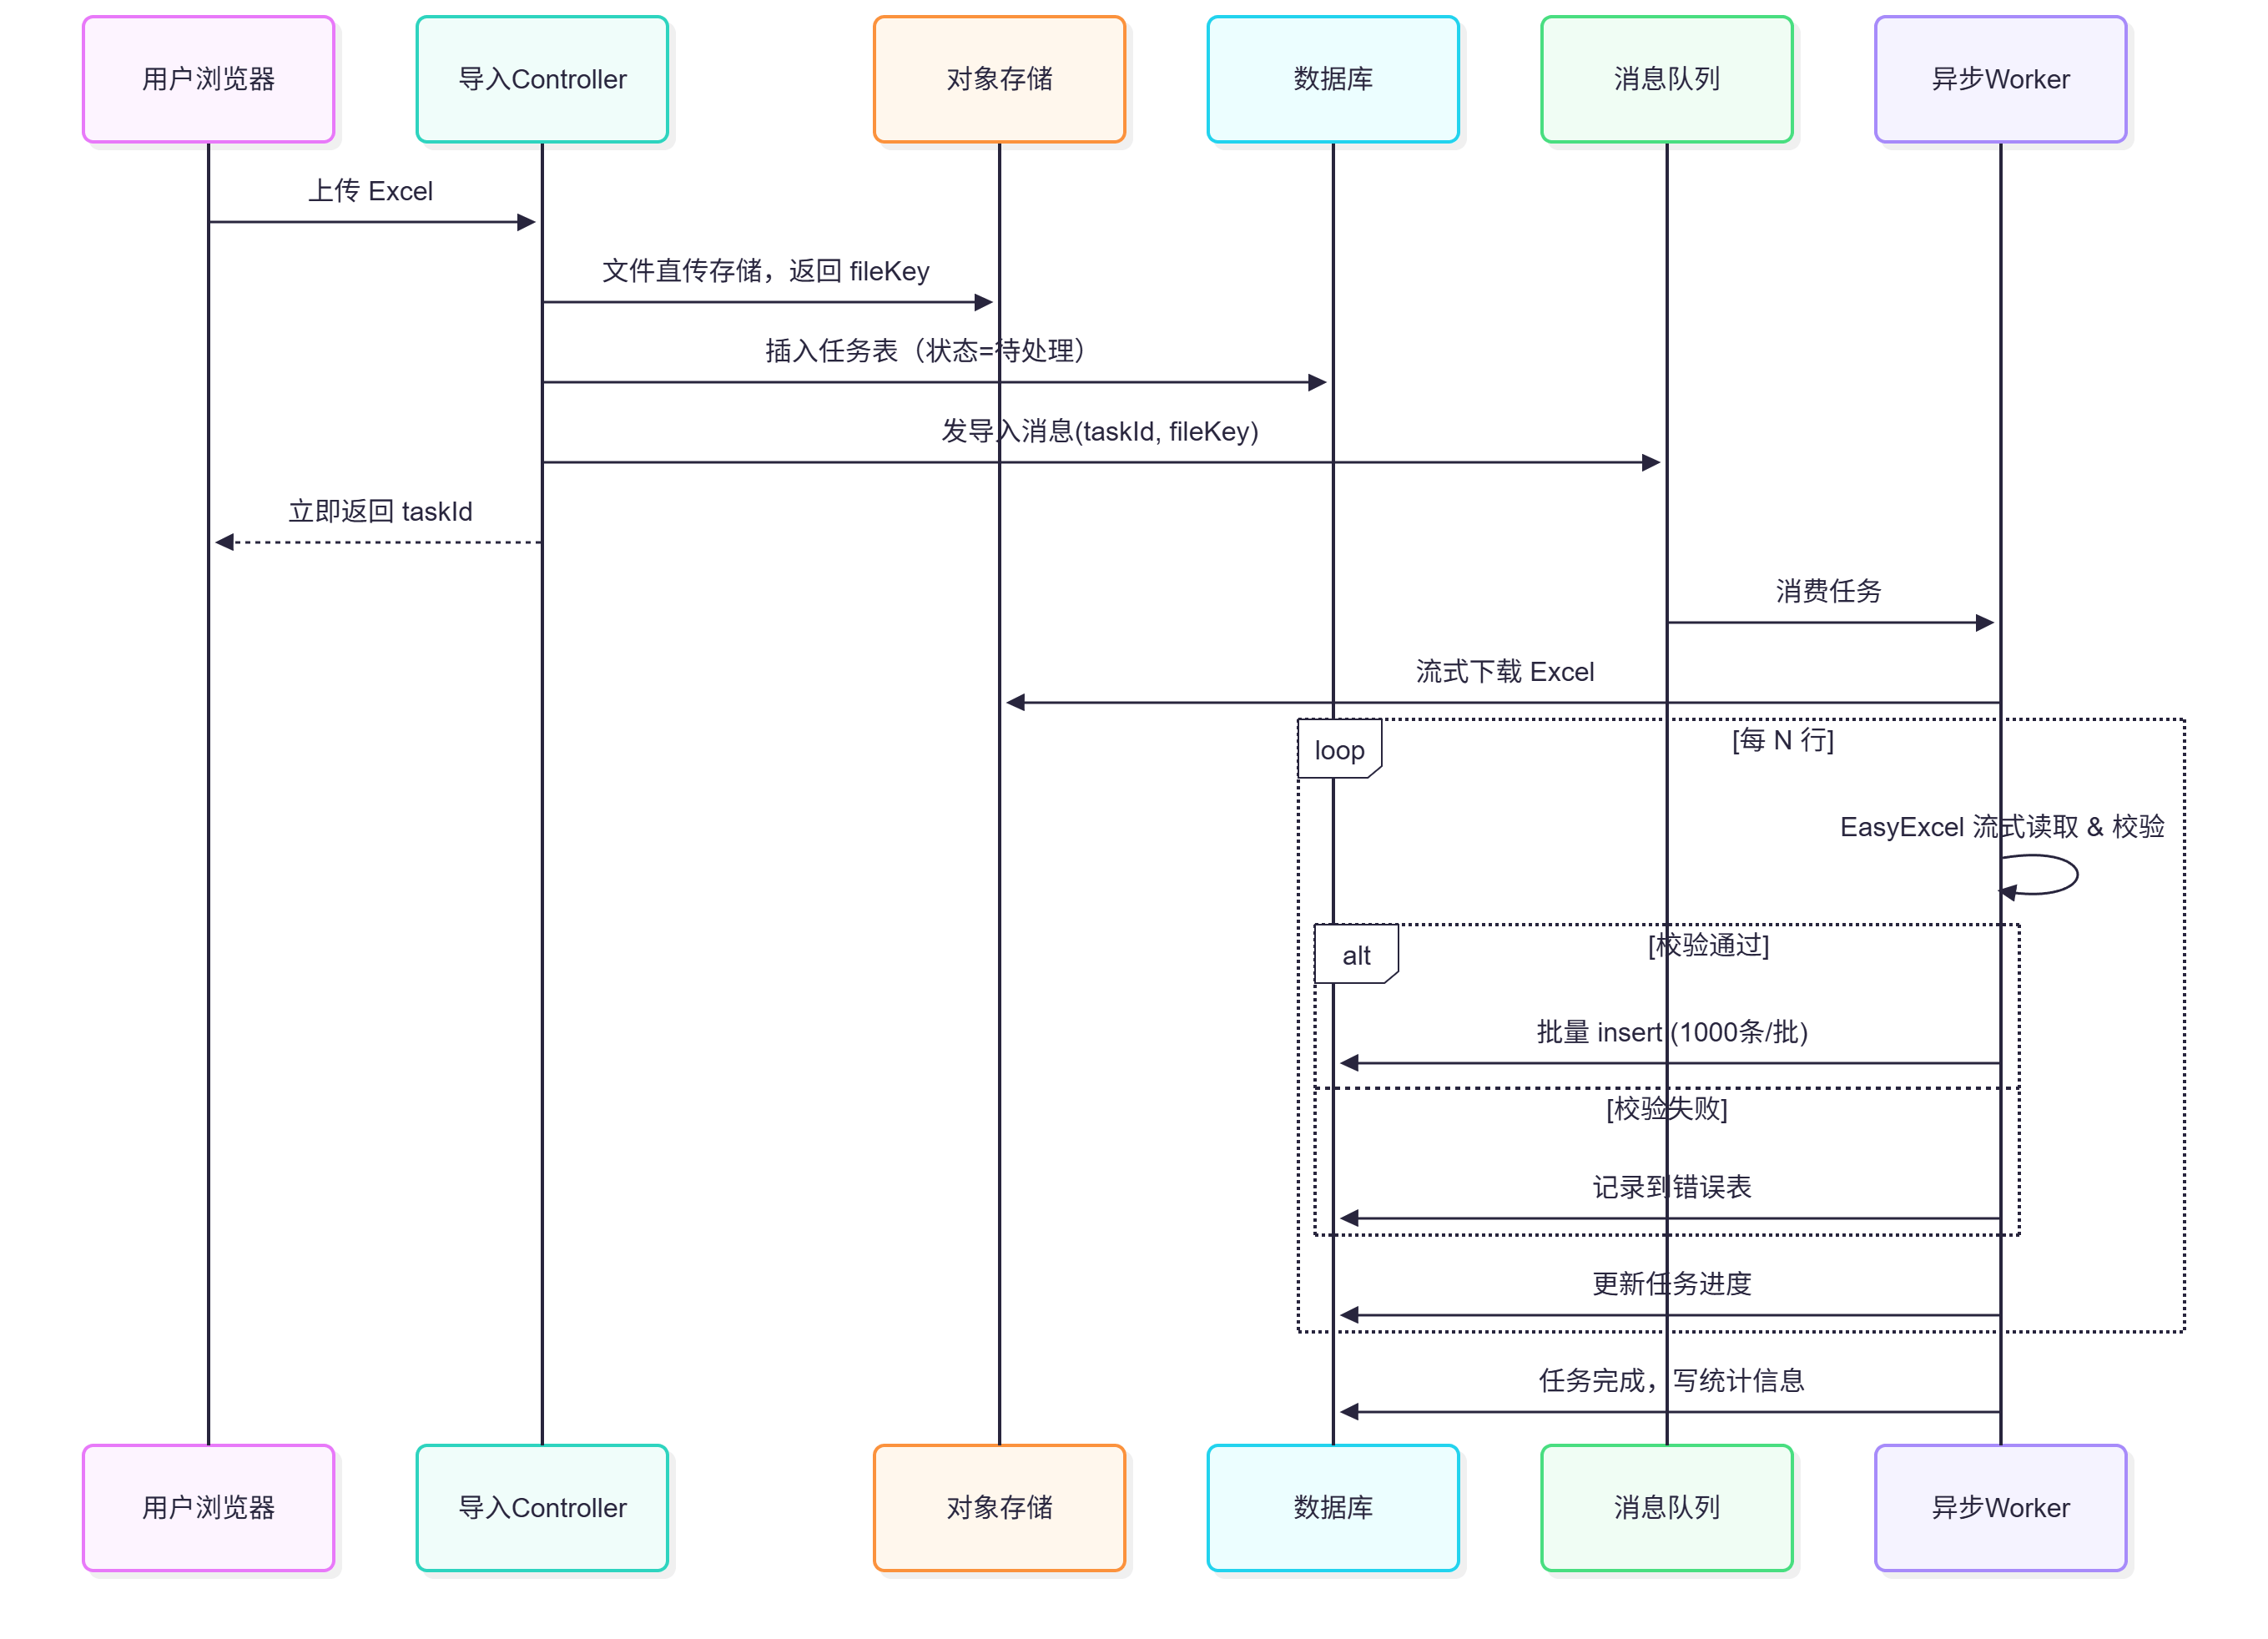
候选人:“没问题,我在白板上画一下调用链路吧。”
“核心点有四个:”
- 文件不落地上传:controller 拿到流直接推到 oss,不在应用服务器积压,然后扔一个 mq 消息就立刻返回
taskid。前端拿这个轮询进度。 - 流式读取:绝对不用 poi 的
xssfworkbook,那会把文件全 load 进内存。用 easyexcel 的readlistener或者 poi 的 sax 模式,逐行回调,内存只占几十 mb。 - 分批写入:内存中攒够 1000 行,用 jdbc batch 一把提交,然后及时 commit 事务,避免长事务锁表。
- 校验和错误收集:数据校验在内存批里做,不合格的行不丢弃,记到
t_import_error表,存行号、原因、原始数据,最后还能给用户导出错误 excel。
面试官:“思路挺清晰。导出呢?导出一般数据量更大,你怎么搞?”
候选人:“导出也是异步,但方向不同。我同样画一下。”
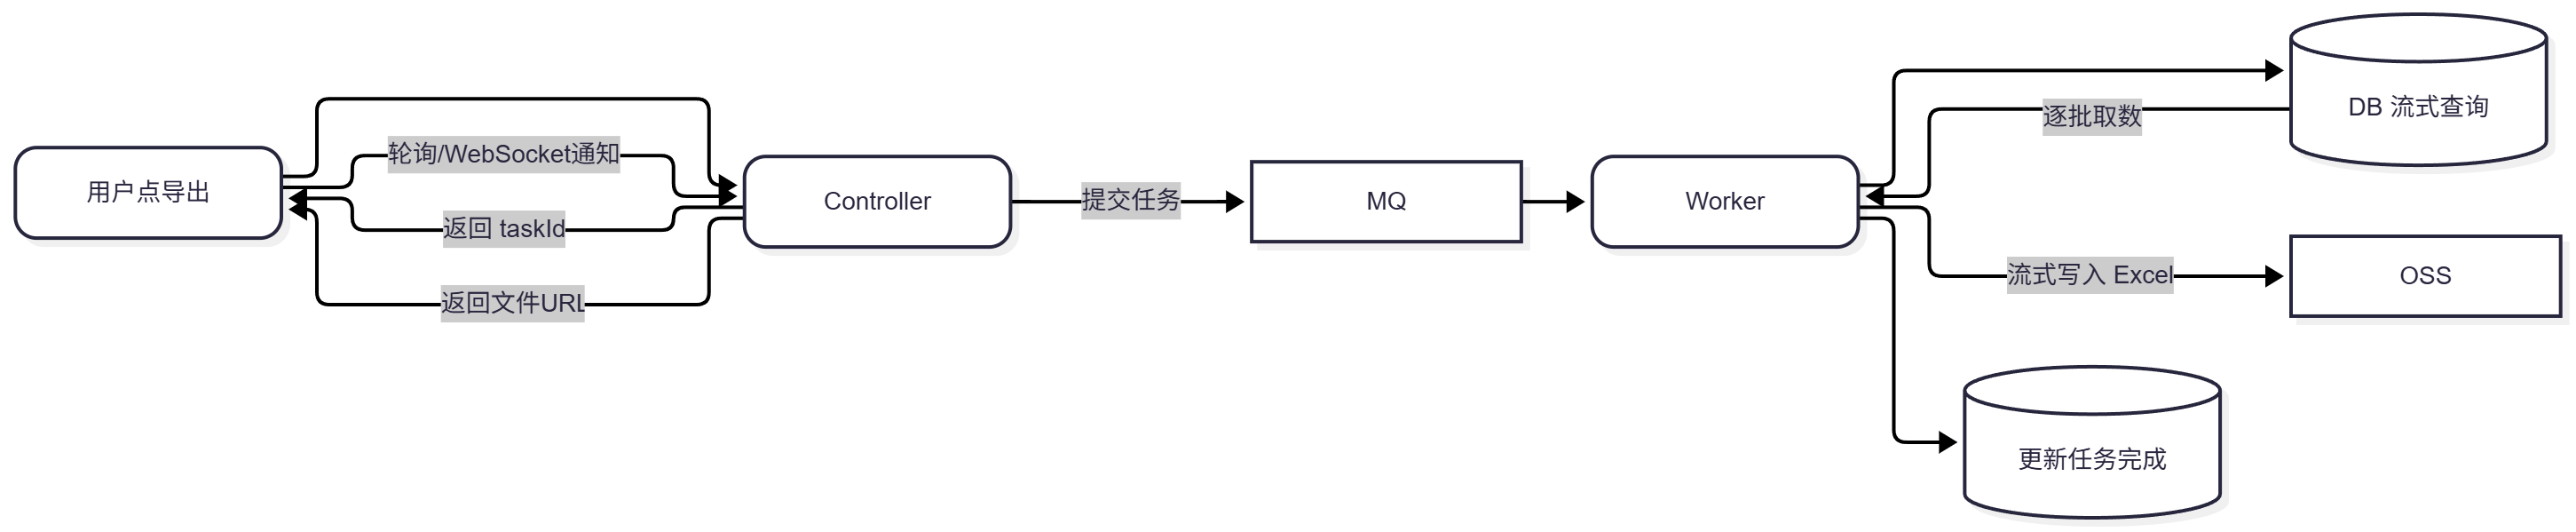
“关键点:
- 数据必须流式查:mybatis 可以用
resultsettype=forward_only配合fetchsize=integer.min_value,mysql 就会一行一行给结果,不会撑爆内存。或者用分页,每页 5000 条。 - excel 流式写:easyexcel 允许多次
dowrite分批追加,直接把outputstream对接 oss 的上传流,本地不留文件。 - 百万行 excel 可能上百 mb,一般直接给用户一个 oss 下载链接,浏览器自己处理,需要的话可以服务端压缩一下。”
面试官:“你刚刚说快速,能不能给我个性能估算?比如 100 万行需要多久?”
候选人:“按我实际调优经验,简单字段(30列左右):
| 阶段 | 耗时 |
|---|---|
| easyexcel 流式解析 | 10~15 秒 |
| 数据库批量写入 (1000条/批) | 20~30 秒 |
| 整体端到端 | 约 30~40 秒 |
这 30 多秒都是异步 worker 在跑,用户上传完文件马上就能干别的事,感知到的只是上传的几秒和进度条。
如果还要更快,可以按行号分片,多个 worker 并行消费不同片段,但要注意 db 写入压力,可以用临时表先接再 merge。”
面试官:“不错,挺落地的。那你实际用过什么技术组件,遇到过哪些坑?”
候选人:
“我们生产用的就是 easyexcel + rocketmq + 阿里云 oss。坑确实踩过几个,简单列一下:
- 日期格式兼容:excel 里日期可能是字符串、数字格式,
celldata解析不一致,要强制用localdatetime加自定义 converter。 - 内存泄露:忘记关闭
workbook流,或批量 insert 时没清理 mybatis 一级缓存,导致 oom,必须每批清缓存或使用batch执行器。 - 大事务:几万条一次 commit,undo log 巨大,主从延迟飙升,所以必须 1000 条拆一次事务。
- 错误 excel 生成:失败行错误原因要原样反馈,用 easyexcel 的
write动态生成头,用户体验好很多。”
面试官:“最后用一句话总结你的方案?”
候选人:“异步削峰接任务,流式读写省内存,分批批量稳入库,错误收集有闭环。 这样百万 excel 导入导出就能又稳又快。”
面试官:“整体思路没问题,挺落地的。能不能给我看段核心代码?就是你实际写过的,带技术亮点的,顺便再说说这个场景到底有哪些技术难点,你怎么解决的。”
候选人:“没问题,我挑三段最有代表性的代码,然后总结一张难点表。”
核心代码片段(技术亮点)
1. easyexcel 流式导入 + 分批入库 + 错误收集
@slf4j
@component
public class excelimportworker {

    // 每批处理行数,防止长事务
    private static final int batch_size = 1000;

    @autowired
    private jdbctemplate jdbctemplate;
    @autowired
    private importerrorservice errorservice;

    public void process(string filekey, long taskid) {
        // 从oss流式下载,直接对接easyexcel的inputstream
        try (inputstream inputstream = ossservice.getobject(filekey)) {
            list<importdto> batch = new arraylist<>(batch_size);

            easyexcel.read(inputstream, importdto.class, new readlistener<importdto>() {
                @override
                public void invoke(importdto data, analysiscontext context) {
                    // 1. 业务校验
                    list<string> errors = validate(data);
                    if (!errors.isempty()) {
                        // 校验失败,记录错误行
                        errorservice.saveerror(taskid, context.readrowholder().getrowindex(), data, errors);
                    } else {
                        batch.add(data);
                    }
                    // 2. 攒够一批,批量写入
                    if (batch.size() >= batch_size) {
                        batchinsert(batch);
                        batch.clear();
                        // 更新任务进度
                        taskservice.updateprogress(taskid, context.readrowholder().getrowindex());
                    }
                }

                @override
                public void doafterallanalysed(analysiscontext context) {
                    // 最后一批残留数据
                    if (!batch.isempty()) {
                        batchinsert(batch);
                    }
                    // 任务终态
                    taskservice.finish(taskid);
                }
            }).sheet().doread();

        } catch (exception e) {
            log.error("导入异常, taskid={}", taskid, e);
            taskservice.markfailed(taskid);
        }
    }

    // 亮点:jdbc batch + 手动事务,避免orm一级缓存膨胀
    @transactional(propagation = propagation.requires_new)
    public void batchinsert(list<importdto> list) {
        string sql = "insert into t_biz_data (...) values (?, ?, ...)";
        jdbctemplate.batchupdate(sql, new batchpreparedstatementsetter() {
            @override
            public void setvalues(preparedstatement ps, int i) throws sqlexception {
                importdto dto = list.get(i);
                ps.setstring(1, dto.getfield1());
                // ... 设置其他参数
            }
            @override
            public int getbatchsize() {
                return list.size();
            }
        });
    }
}
亮点说明
- 用
readlistener逐行回调,内存只持有一批数据。 - 校验失败不走
throw,而是记错误表,保证整批导入不中断。 - 分批手动提交事务
requires_new,每 1000 条一个新事务,避免大事务。 jdbctemplate.batchupdate绕开 mybatis 一级缓存,防止内存堆积。
2. 百万级数据导出:流式查询 + 流式写 excel
@slf4j
public class excelexportworker {

    private static final int query_page_size = 5000;

    public void export(long taskid, exportquery query) {
        // 直接获取oss上传的outputstream
        try (outputstream outputstream = ossservice.putobjectstream(exportkey)) {
            excelwriter excelwriter = easyexcel.write(outputstream, exportvo.class).build();
            writesheet writesheet = easyexcel.writersheet("数据页").build();

            long lastid = 0l;
            list<exportvo> pagelist;
            do {
                // 流式分页查询(避免全量拖入内存)
                pagelist = exportmapper.selectbypage(lastid, query_page_size, query);
                if (!pagelist.isempty()) {
                    excelwriter.write(pagelist, writesheet);
                    lastid = pagelist.get(pagelist.size() - 1).getid();
                }
                // 更新进度
                taskservice.updateprogress(taskid, lastid);
            } while (pagelist.size() == query_page_size);

            excelwriter.finish();
            taskservice.finish(taskid, exportkey);
        } catch (exception e) {
            log.error("导出异常, taskid={}", taskid, e);
            taskservice.markfailed(taskid);
        }
    }
}
对应的 mybatis 流式查询配置(确保 mysql 结果集不堆积)
@select("select * from t_biz_data where id > #{lastid} and ... order by id limit #{size}")
@options(resultsettype = resultsettype.forward_only, fetchsize = integer.min_value)
list<exportvo> selectbypage(@param("lastid") long lastid, @param("size") int size, @param("query") exportquery query);
亮点说明
- 分页基于 游标式 lastid,避免
offset大翻页性能问题。 - mybatis 注解指定
forward_only + integer.min_value,驱动会逐条从 resultset 获取,不占客户端内存。 - easyexcel 的
outputstream直连 oss 输出流,本地不产生临时文件。
3. 异步任务 & 进度反馈(controller + mq)
@restcontroller
public class importcontroller {

    @postmapping("/import/upload")
    public result<long> upload(@requestparam("file") multipartfile file) {
        // 1. 文件直传oss
        string filekey = ossservice.upload(filetype.excel_import, file.getinputstream());
        // 2. 插入任务表
        long taskid = taskservice.createtask(tasktypeenum.import, filekey);
        // 3. 发送mq消息(解耦,异步化)
        rocketmqtemplate.asyncsend("excel-import-topic", new importmsg(taskid, filekey), null);
        return result.ok(taskid);
    }

    @getmapping("/import/progress/{taskid}")
    public result<taskprogressvo> progress(@pathvariable long taskid) {
        return result.ok(taskservice.getprogress(taskid));
    }
}
技术难点 & 解决方案总结
| 技术难点 | 原因剖析 | 解决方案 |
|---|---|---|
| 大文件上传 oom | 前端整个文件加载到内存或应用端接收全部字节 | 1. 前端分片上传(可选) 2. 后端 controller 直接流转发 oss,不存本地 3. 上传完成后立即返回 taskid,异步处理 |
| excel 解析内存爆炸 | poi xssfworkbook 全量 load dom | 使用 easyexcel / poi sax 事件驱动,逐行处理,内存恒定 |
| 数据库写入慢 + 事务膨胀 | 单条 insert,长事务 undo 累积 | 1. jdbctemplate.batchupdate 批量提交2. 每 1000 条拆分为独立事务(requires_new)3. 关闭 mybatis 一级缓存或使用 batch 执行器 |
| 大导出数据量 oom | select * 全量加载到 list 再写 excel | 1. mybatis 流式游标分页查询(forward_only + fetchsize)2. easyexcel 多次 dowrite 分批写流 |
| 导入失败无法回溯 | 遇到一条数据异常就全盘失败,用户不知道哪错了 | 1. 校验异常不中断流程,收集到错误表 2. 记录行号、错误原因、原始数据 3. 任务完成后可导出错误 excel |
| 长连接超时 | 同步处理导出/导入时,网关、nginx、浏览器 504 gateway timeout | 彻底异步化:controller 只负责接收请求,后台 worker 跑完通知前端,前端轮询或 websocket 感知进度 |
| 并发导入致 db 热点写入 | 多任务同时写同一张表,锁竞争激烈 | 1. 单表引入分区/分表 2. 每个 worker 写入前通过 select ... for update skip locked 分批获取序列号3. 先入临时表,再 merge 主表 |
| 大文件下载中断 | 下载一半网络断开,需重头再来 | 1. oss 支持断点续传 2. 前端用 range 请求分片下载3. 服务端可以将大 excel 切片后打包 zip,提高重试效率 |
| 内存泄漏 | 异常时未关闭 workbook / inputstream | try-with-resources 严格管理所有流,easyexcel 的 readlistener 在 onexception、doafterallanalysed 做好资源释放 |
| 进度反馈不准确 | 只在任务完成才通知,用户焦虑 | 每隔一个批次更新 processed_count,前端轮询任务进度字段,并预估剩余时间 |
面试官:“好的,代码和难点都讲得很透。这套组合拳基本覆盖了性能、稳定性、容错性。如果没有补充的话,这部分我可以给到 s 级 评价。”
候选人:“谢谢面试官。 实际落地中还有一个小建议,就是监控告警:给任务表加超时状态,超过 10 分钟还没完成的自动发告警,避免静默失败。”
面试官:“这个细节也注意到了,不错。那我们进入下一个环节……”
以上就是java如何快速处理百万数据excel导入导出的详细内容,更多关于java excel百万数据导入导出的资料请关注代码网其它相关文章!





发表评论