
 我要评论
redis 作为高性能的键值对存储系统,已成为现代分布式架构中不可或缺的基础设施。从理解其 nosql 本质到掌握核心数据结构,再到解决 java 客户端集成中的序列化痛点,本文旨在系统梳理 redis 的核心知识体系与实战避坑指南。
redis 与 nosql 基础认知
为什么需要 nosql?
传统关系型数据库(sql)在处理高并发读写、海量数据存储及灵活 schema 变更时面临瓶颈。nosql(not only sql)应运而生,其核心特征包括:
- 非结构化/半结构化数据:不再强制要求固定的表结构。
- 高性能:基于内存操作,读写速度远超磁盘 i/o。
- 高扩展性:天然支持分布式集群,易于水平扩展。
- base 理论:强调基本可用(basically available)、软状态(soft state)和最终一致性(eventually consistent),而非强 acid 事务。
redis 简介
redis(remote dictionary server)是一个基于内存的键值型 nosql 数据库。它支持多种数据结构,提供持久化机制(rdb 和 aof),并具备发布订阅、lua 脚本等高级功能。
之前做项目,缓存这块我一直停留在"会往 redis 里塞个值、取个值"的程度,命令全靠现查,数据结构到底该用哪个也说不清。这周下定决心把 redis 的地基补一遍:从 nosql 为什么存在,到 linux 上怎么装、怎么后台跑,再到五种数据结构的适用场景,最后落到 java 客户端和那个能把人逼疯的序列化乱码问题。这篇就是我这一周的笔记整理,写给和我一样"用过但没学透"的人。
一、nosql 到底特殊在哪:先搞清楚为什么需要它
我最早接触数据库就是 mysql,一直以为"数据库"就等于"表 + 行 + sql"。直到看 redis 的文档发现它被归到 nosql,才意识到自己的认知太窄了。
nosql 可以读作 “not only sql”(不仅仅是 sql),也可以读作 “no sql”(非关系型)。它跟关系型数据库的差异,我梳理成四个维度:
| 维度 | 关系型(mysql) | 非关系型(redis) |
|---|---|---|
| 数据结构 | 严格表结构,字段名/类型/约束都要定义 | 松散,键值/文档/图都行 |
| 关联 | 表之间可用外键关联 | 无关联,靠业务逻辑或数据冗余维护 |
| 查询 | 统一的 sql 标准 | 各家语法五花八门,没有标准 |
| 事务 | 严格满足 acid | 大多不支持或只能保证基本一致性 |
这里我想多说一句"关联"这个差异。关系型数据库里,用户表和订单表用外键一关联,查"张三的所有订单及其商品"就是一句 join。但 nosql 里没有外键这回事,想表达关联只能把数据塞在一起:
{
  "id": 1,
  "name": "张三",
  "orders": [
    { "id": 1, "item": { "id": 10, "title": "手机a", "price": 4999 } },
    { "id": 2, "item": { "id": 20, "title": "手机b", "price": 3999 } }
  ]
}
问题一眼就能看出来:同一个"手机a"的信息,在张三、李四……每个买过它的用户订单里都得冗余存一份。所以 nosql 里我学到的原则是——不要用数据模型去表达关联,用业务代码去表达。
那既然 nosql 这么多"不方便",为什么还要用它?关键就在最后两行没写进表格的差异:存储方式和扩展性。
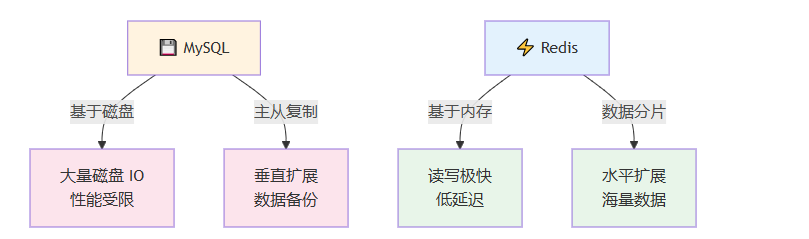
这张图说的是两类数据库各自的取舍:mysql 把数据落在磁盘、靠主从做备份,擅长强一致和复杂关联查询;redis 把数据放内存、靠分片横向扩展,擅长快和能扛量。它俩不是替代关系,是各干各的活。我现在理解 redis 的定位就是一句话——用内存换速度,用放弃部分约束换灵活性。
二、在 linux 上把 redis 跑起来
redis 官方不提供 windows 安装包,企业也都是 linux 部署,所以我是装在 centos 7 虚拟机上的。整个流程不复杂,但有两个坑我踩了。
先装 c 语言的编译依赖(redis 是 c 写的),再解压源码包编译:
yum install -y gcc tcl
tar -xzf redis-6.2.6.tar.gz
cd redis-6.2.6
make && make install
装完默认落在 /usr/local/bin 目录,里面有三个可执行文件:redis-server(服务端)、redis-cli(命令行客户端)、redis-sentinel(哨兵)。这个目录已经在环境变量里,所以任意路径都能直接敲命令。
第一个坑:redis-server 直接回车是前台启动,会话窗口一关、或者按个 ctrl+c,redis 就没了。想让它后台常驻,得改 redis.conf(改之前我习惯先 cp redis.conf redis.conf.bck 备份一份):
bind 0.0.0.0          # 默认127.0.0.1只能本机访问;生产环境千万别开0.0.0.0
daemonize yes         # 改成yes就能后台运行
requirepass 123456    # 设了密码,之后每次访问都得带密码
改完用 redis-server redis.conf 启动,用 redis-cli -u 123456 shutdown 停。这里我踩的第二个坑就是:配了 requirepass 之后,忘了 shutdown 也得带 -u 指定密码,不然关不掉。
生产环境更推荐做成 systemd 服务,用开机自启:
vi /etc/systemd/system/redis.service
[unit]
description=redis-server
after=network.target
[service]
type=forking
execstart=/usr/local/bin/redis-server /usr/local/src/redis-6.2.6/redis.conf
privatetmp=true
[install]
wantedby=multi-user.target
systemctl daemon-reload
systemctl enable redis   # 开机自启
systemctl start redis    # 之后就能用 start/stop/restart/status 一套命令管理了
配好之后连客户端有三种选择:命令行 redis-cli、图形化的 redis desktop manager、以及后面会讲的 java 编程客户端。图形化工具最直观,能像文件树一样看数据,我调试期基本一直开着它。
三、五种数据结构:别死记命令,先记场景
以前我背命令背得痛苦,后来发现思路错了——命令是查不完的,得先根据场景选对数据结构,再去查那个结构对应的命令。redis 官网把命令按类型分了组,help [命令] 能随时查用法。
redis 里 key 基本都是字符串,value 才是花样所在。五种最常用的结构我按"像 java 里的什么"来记:
| 类型 | 类比 java | 核心特征 | 典型场景 |
|---|---|---|---|
| string | 无(最基本) | 可存字符串/整数/浮点,能自增自减,最大 512m | 缓存对象 json、计数器、分布式锁 |
| hash | hashmap | value 是字段-值的字典,能单独改某个字段 | 存对象且要频繁改单个字段 |
| list | linkedlist | 双向链表,有序可重复,两头增删快 | 朋友圈评论、点赞列表 |
| set | hashset | 无序不重复,支持交并差集 | 共同好友、去重、抽奖 |
| sortedset | treeset(底层是跳表+hash) | 每个元素带 score,可排序不重复 | 排行榜 |
用一张决策图把它们串起来,遇到需求时顺着走一遍就知道选哪个:
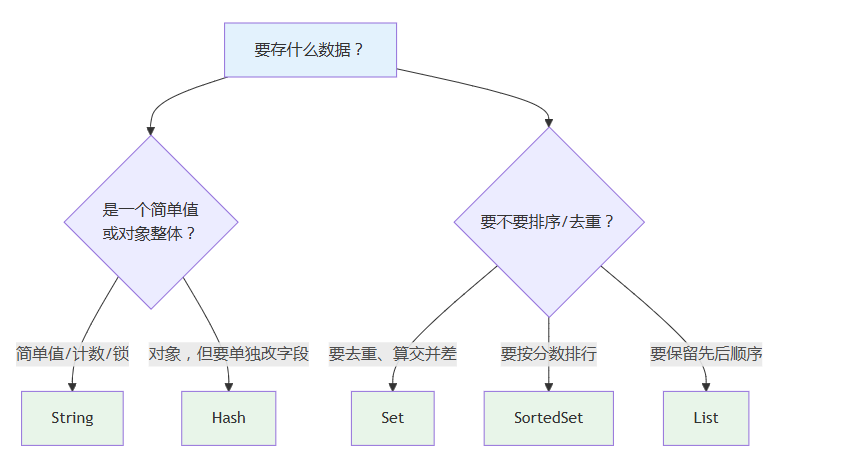
这张图说的是拿到一个存储需求时的判断顺序:先看数据形态(简单值还是对象),再看要不要排序去重。比如"班级成绩排行榜",要按分数排序,那就是 sortedset;“某篇文章的评论”,要保留时间先后又能反转,那是 list;“统计用户访问过哪些页面且去重”,那是 set。
string 里有几个命令值得单独记:setnx 是"key 不存在才设置",setex 是"设置的同时指定过期时间"。这两个我在后面学分布式锁时会反复遇到。
127.0.0.1:6379> set name jack
ok
127.0.0.1:6379> incr age        # 整数直接自增,这是string能做计数器的原因
(integer) 11
127.0.0.1:6379> setnx name lisi # name已存在,返回0,不覆盖
(integer) 0
127.0.0.1:6379> setex token 30 abc  # 存进去同时设30秒过期
ok
通用命令里有个面试高频:expire 设有效期后,用 ttl 查剩余时间。要记牢 ttl 的三种返回值——正常返回剩余秒数,-1 表示这个 key 存在但没设过期时间(永久),-2 表示 key 根本不存在(多半是已过期被删了)。这三种状态混在一起问就是送命题,我特意敲了一遍才分得清。
还有个生产警告:keys * 在 key 很多时是阻塞式的慢查询,会拖垮整个 redis,线上禁止用 keys 做模糊匹配,学命令时本地玩玩可以。
四、key 的命名:一个冒号解决冲突
这个问题挺出乎我意料。redis 里没有 mysql 的 table 概念,所有 key 平铺在一起。那假如用户 id=1 和商品 id=1 都要存,直接用 1 当 key 不就撞了?
解法是用冒号做层级前缀,格式是 项目名:业务名:类型:id。比如项目叫 mall:
mall:user:1      → {"id":1,"name":"jack","age":21}
mall:product:1   → {"id":1,"name":"手机a","price":4999}
这样不仅避免了 key 冲突,在 redis desktop manager 里还会自动折叠成一棵层级树,看着跟目录一样清楚。别小看这个约定,它其实是在没有 table 的存储里,用命名规则人为造出了"库/表"的边界。我在项目里见过有人图省事全用短 key,结果几万个 key 平铺成一锅粥,排查问题时代价很大。
五、用 java 操作 redis:从 jedis 直连到连接池
装好服务端、命令也熟了,真正要落到项目里得用 java 客户端。官方列了一堆,推荐的主要是三类:jedis 和 lettuce 提供命令对应的 api,redisson 则在 redis 上实现了分布式数据结构和跨进程同步(后面做分布式锁会用到)。
jedis 上手最快,建立连接、认证、选库、操作、关连接:
@beforeeach
void setup() {
    jedis = new jedis("192.168.100.10", 6379);
    jedis.auth("123456");
    jedis.select(0);
}
@test
void testhash() {
    jedis.hset("mall:user:1", "name", "jack");
    jedis.hset("mall:user:1", "age", "21");
    map<string, string> map = jedis.hgetall("mall:user:1");
}
@aftereach
void teardown() {
    if (jedis != null) jedis.close();
}
但直接用 new jedis(...) 有两个问题:jedis 本身线程不安全,而且频繁建连、销毁连接有性能损耗。解法是上连接池。
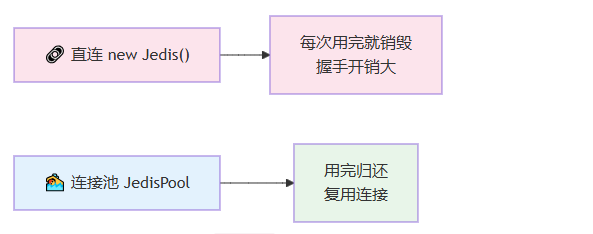
这张图说的是连接池的价值:close() 不再是真的关掉连接,而是把它还回池子里给下一个请求复用。这跟数据库连接池、tomcat 线程池是一个思想——贵的资源建立一次,反复用。
public class jedisconnectionfactory {
    private static final jedispool jedispool;
    static {
        jedispoolconfig cfg = new jedispoolconfig();
        cfg.setmaxtotal(8);
        cfg.setmaxidle(8);
        cfg.setminidle(0);
        cfg.setmaxwaitmillis(1000);
        jedispool = new jedispool(cfg, "192.168.100.10", 6379, 1000, "123456");
    }
    public static jedis getjedis() { return jedispool.getresource(); }
}
静态代码块保证连接池随类加载只初始化一次。这里用了工厂模式来降低耦合,spring 里创建 bean 也是这套思路。
不过真到 spring boot 项目里,我不会直接写 jedis,而是用 springdataredis——它对 jedis 和 lettuce 又做了一层封装,统一成 redistemplate 这个 api。用法三步:引依赖、yml 配连接、注入 redistemplate,然后就能 opsforvalue() / opsforhash() / opsforlist() 按类型操作了。
spring:
  redis:
    host: 192.168.100.10
    port: 6379
    password: 123456
    lettuce:
      pool:
        max-active: 8
        max-idle: 8
        min-idle: 0
        max-wait: 100ms
六、序列化:从满屏乱码到 stringredistemplate
这一节是我这周收获最大、也最"踩坑"的部分。
兴冲冲写完 redistemplate.opsforvalue().set("mall:user:1", user),打开 redis desktop manager 一看,傻眼了——存的 value 是一串 \xac\xed\x00\x05t\x00... 这种乱码。原因是 redistemplate 只接收 object,写入前要用序列化器把对象转成字节,而默认用的是 jdk 序列化。jdk 序列化有两个毛病:可读性差(就是那串乱码)、内存占用大。
第一次改造,自定义 redistemplate,把 value 的序列化器换成 json:
@configuration
public class redisconfig {
    @bean
    public redistemplate<string, object> redistemplate(redisconnectionfactory factory) {
        redistemplate<string, object> template = new redistemplate<>();
        template.setconnectionfactory(factory);
        genericjackson2jsonredisserializer json = new genericjackson2jsonredisserializer();
        template.setkeyserializer(redisserializer.string());
        template.sethashkeyserializer(redisserializer.string());
        template.setvalueserializer(json);
        template.sethashvalueserializer(json);
        return template;
    }
}
乱码解决了,存进去的是漂亮 json。但仔细看会发现它多存了一个 @class 字段,记的是这个对象的完整类名。这是为了能自动反序列化回正确的 java 类型。类型对上了,代价是多占内存。
于是第二种方案更省:既然 json 序列化器就为了省个手动转换却搭上 class 信息,不如干脆统一用 string 序列化,存的时候手动把对象转 json、取的时候手动转回来,这样 redis 里就完全不存 class。springdataredis 直接给了现成的 stringredistemplate,key 和 value 默认都是 string:
@autowired
private stringredistemplate stringredistemplate;
private static final objectmapper mapper = new objectmapper();
@test
void testsaveuser() throws exception {
    user user = new user("张三", 21);
    // 手动序列化
    stringredistemplate.opsforvalue().set("mall:user:200", mapper.writevalueasstring(user));
    // 手动反序列化
    string json = stringredistemplate.opsforvalue().get("mall:user:200");
    user u = mapper.readvalue(json, user.class);
}
三种方案摆一起对比就清楚了:
| 方案 | 存储内容 | 优点 | 缺点 |
|---|---|---|---|
| 默认 jdk 序列化 | 二进制乱码 | 开箱即用 | 不可读、占内存、跨语言差 |
| 自定义 json 序列化器 | json + @class | 自动转换对象类型 | 多存 class,占内存 |
| stringredistemplate | 纯 json | 最省内存、可读、跨语言 | 要手动序列化/反序列化 |
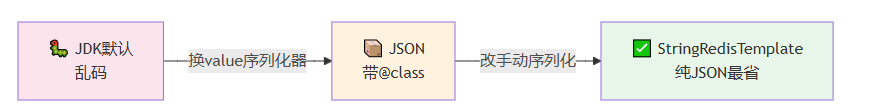
这张图说的是我优化序列化的三次迭代:从乱码,到 json 但仍冗余存 class,到最后用 stringredistemplate 手动转换、把冗余彻底去掉。项目里绝大多数场景我倾向第三种——省内存,而且存的是标准 json,别的语言的服务也能直接读,跨语言友好。
七、这周的整体感受
一周下来最大的认知转变,是别再想着背命令。redis 的命令是按数据结构分组、且能随时 help 查的,真正要练的是"看到需求能选对结构"。排行榜用 sortedset、共同好友用 set 的 sinter、要单独改字段的对象用 hash——把这张决策图刻进脑子,命令只是查一下的事。
第二个感受是 nosql 不是"更高级的 mysql",而是另一种取舍。它放弃了强约束、事务、关联,换来了内存级的速度和横向扩展能力。理解了这一点,才明白为什么项目里 redis 永远坐在"mysql 前面的缓存层"这个位置,而不是替掉 mysql。
第三个是序列化这块,看着是个小细节,实际是生产环境里天天会碰的坑。从满屏乱码到最后想通"用 stringredistemplate 手动转",这个过程比记命令有价值得多。
入门篇到这里算打了个地基。下一步我想接着啃 redis 的实战篇——缓存三兄弟(缓存穿透、击穿、雪崩)怎么破、setnx 怎么演进成分布式锁、以及 sortedset 真正实现一个能扛的排行榜。等把这些跟项目场景结合起来,我应该能再写一篇有分量的实战博客。
到此这篇关于一文吃透 redis 入门:nosql、五种数据结构、jedis 与 springdataredis 序列化踩坑全记录的文章就介绍到这了,更多相关springdataredis 序列化内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!





发表评论