
 我要评论
一、开场:文档传上去了,答案还是编的
场景你肯定见过:用户上传一份公司文档,转头问「年假怎么算」。模型答得头头是道,数字编得比真的还像。
文档内容直接贴进提示词能对付一两次。文档一多、用户一多,提示词塞不下,钱也烧不起。
得换个做法:文档先存到一个能按语义检索的地方,用户提问时只捞相关的那几段,交给模型组织语言。这就是 rag。
第一期的范围怎么划、哪些事明确先不做,写在 [[13-文档读取第一期方案与取舍]];这篇只讲怎么做。
二、人话解释:rag 的活拆成写入和读取两段
写入段叫 etl,跟数据仓库那套一个意思,只是搬的是文本:
| 环节 | 干什么 | 用的组件 |
|---|---|---|
| extract | 把文件读成 document | textreader、markdowndocumentreader,再往后是 pdf、tika |
| transform | 把大 document 切成小 document | tokentextsplitter |
| load | 把小 document 向量化后存起来 | pgvectorstore、simplevectorstore |
读取段更简单:把问题也向量化,去向量库找最像的几段,拼成上下文,再让模型基于上下文回答。
两段里最容易出问题的不是模型,是中间那层切分和标签。模型再聪明,你给它捞错了片段,它也只能照着错的编。
三、生活类比:图书馆不是把书扔地上就能查
文档是书,切片是便签,向量是索引卡,元数据是书架分区。
书搬进来不能往地上一堆。得先编目、撕成便于取用的便签、贴上属于哪个分区的标签,上架之后才谈得上"查"。读者来问,管理员照着索引卡找到那几张便签,递给讲解员组织成答案。
讲解员只负责讲,不负责找。找错了,讲得越流畅越糟糕。
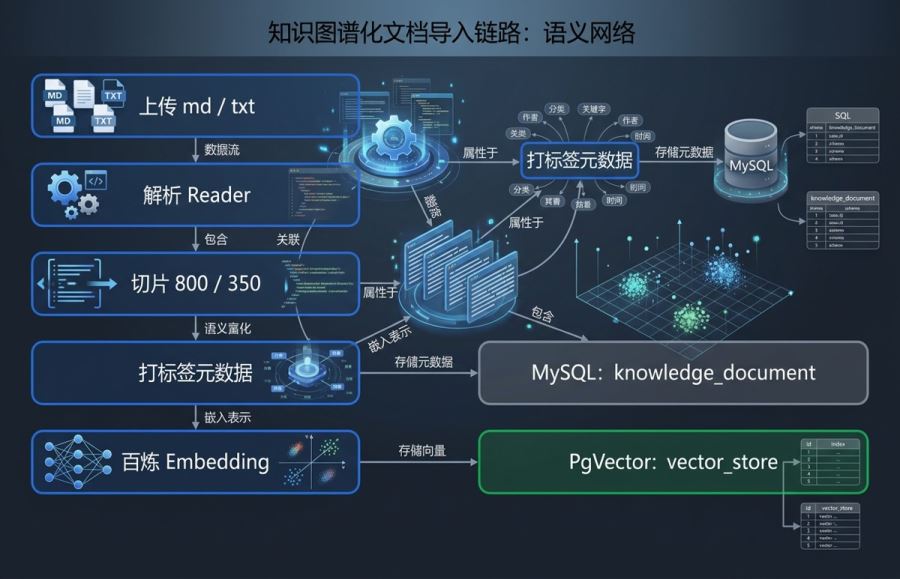
四、落地:导入链路的六步与异步改造
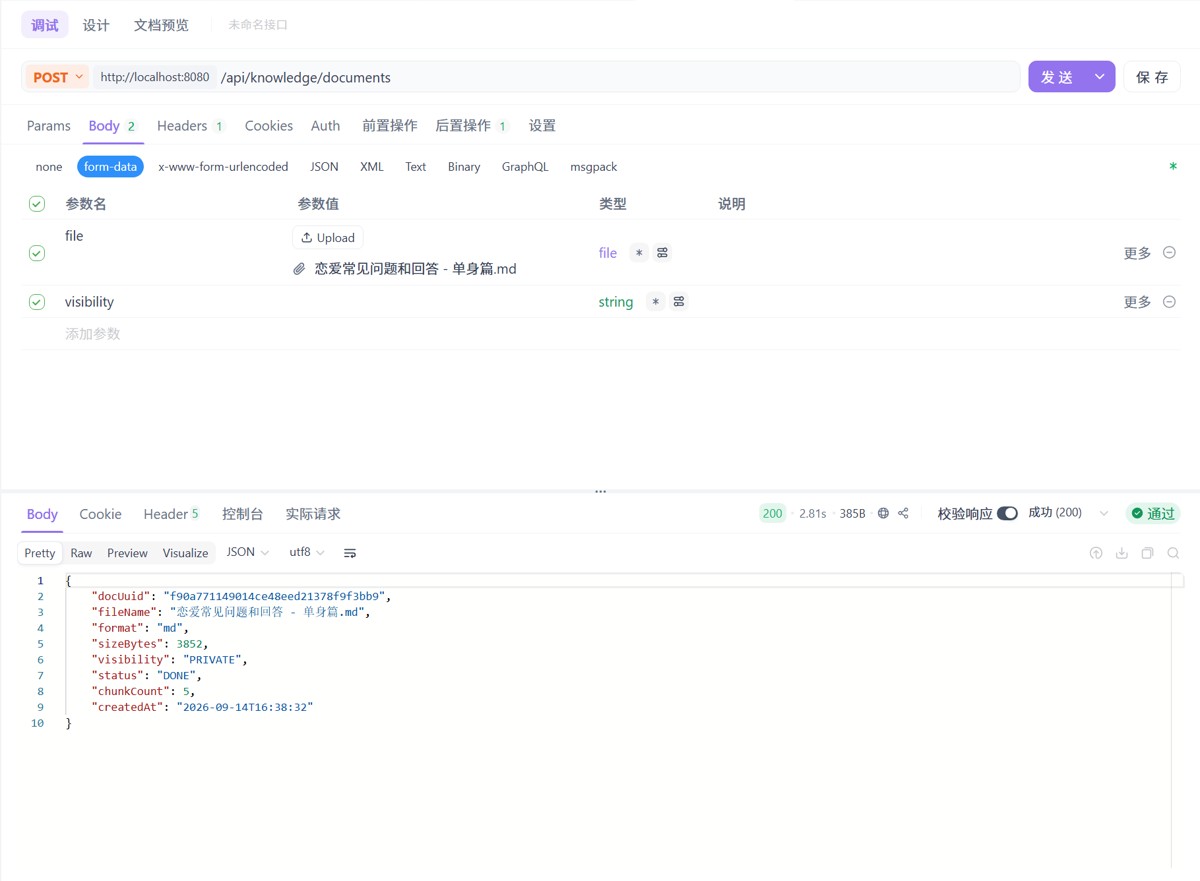
接口一共五个,用户标识暂时用请求头 x-user-id 传,接了登录体系之后换成从 token 解析:
| 方法 | 路径 | 用途 |
|---|---|---|
| post | /api/knowledge/documents | 上传文档,form 字段 file + visibility |
| get | /api/knowledge/documents | 列出自己可见的文档 |
| get | /api/knowledge/documents/{docuuid} | 查单个文档的导入状态与失败原因 |
| delete | /api/knowledge/documents/{docuuid} | 删除文档及其向量 |
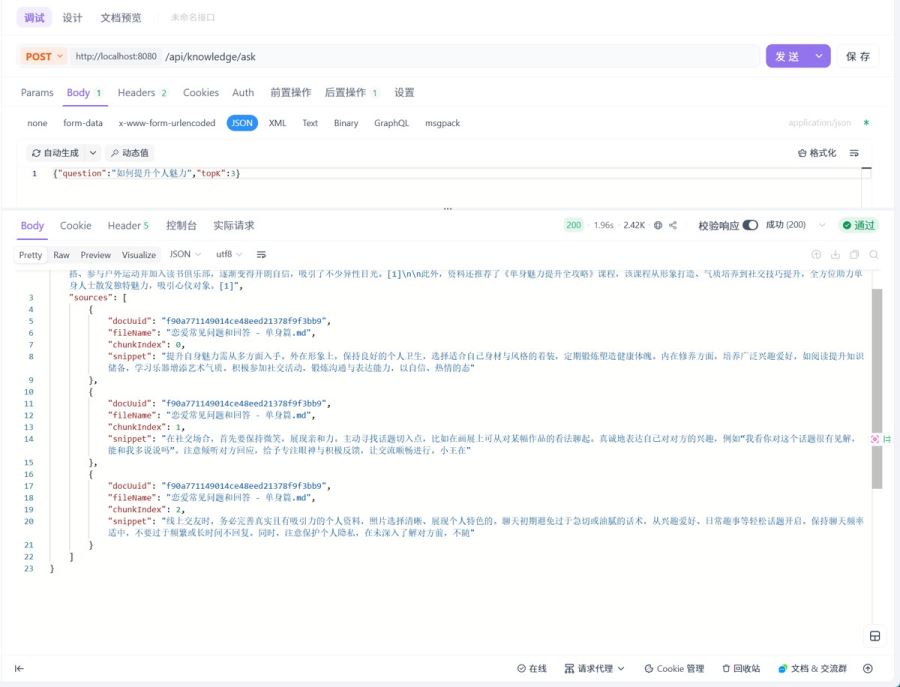
| post | /api/knowledge/ask | 检索问答 |
配置长这样,密钥和连接信息全部走环境变量:
love:
  rag:
    embedding:
      api-key: ${dashscope_api_key}
      base-url: https://dashscope.aliyuncs.com
      embeddings-path: /compatible-mode/v1/embeddings
      model: text-embedding-v3
    pgvector:
      host: ${pgvector_host}
      port: ${pgvector_port:5432}
      database: ${pgvector_database}
      username: ${pgvector_username}
      password: ${pgvector_password}
      table-name: vector_store
      dimensions: 1024
      index-type: hnsw
      distance-type: cosine_distance
    chunk-size: 800
    min-chunk-size-chars: 350
    top-k: 4
4.1 校验加去重
第一期只放 md 和 txt 进来,格式白名单外的一律拒绝。同一份文件重复上传是常见操作,按内容的 sha256 去重,省一次嵌入的钱:
string sha256 = digestutil.sha256hex(bytes);
knowledgedocument existing = documentmapper.selectonebyquery(
        querywrapper.create().where("user_id = ?", userid).and("sha256 = ?", sha256));
if (existing != null && status_done.equals(existing.getstatus())) {
    return toinfo(existing);
}
4.2 解析
两种格式走两个 reader,markdown 单独用 markdowndocumentreader,它能按标题结构拆 document:
if (lower.endswith(".md") || lower.endswith(".markdown")) {
    return new markdowndocumentreader(resource, markdowndocumentreaderconfig.defaultconfig()).get();
}
return new textreader(resource).get();
4.3 切片
切片大小是成本和质量的总开关:
tokentextsplitter splitter = tokentextsplitter.builder()
        .withchunksize(800)              // 每片最多 800 token
        .withminchunksizechars(350)      // 太短的片不单独成片
        .build();
片太大,一次捞回来半页噪声,上下文被无关内容占满;片太小,一句完整的话被劈两半,检索回来缺主语,模型只能猜。
4.4 打标签
这一步决定了后面能不能做权限和清理,元数据必须在这时候就带全:
metadata.put("doc_uuid", row.getdocuuid());
metadata.put("user_id", userid);
metadata.put("file_name", row.getfilename());
metadata.put("visibility", visibility);
metadata.put("chunk_index", index);
4.5 用确定性 id
切片 id 不是随机生成的,而是从文档号和序号推出来的:
private string chunkid(string docuuid, int index) {
    return uuid.nameuuidfrombytes((docuuid + ":" + index).getbytes(standardcharsets.utf_8)).tostring();
}
理由很实在:删除的时候要能算出"这篇文档一共占了哪些 id"。nameuuidfrombytes 是确定性哈希,同样的输入永远得到同一个 uuid,写入和删除两边算出来是一致的。顺带也满足了 pgvector 对 id 格式必须是 uuid 的硬要求。
4.6 落库
list<document> chunks = splitandtag(documents, row, userid, effectivevisibility);
vectorstore.add(chunks);
mysql 那边同时维护一张 knowledge_document 表,记录文档号、文件名、大小、sha256、可见性、状态和切片数。status 从 processing 走到 done,失败记 failed 并把错误信息截断存下来。
向量和元数据分开存是有意的:向量库负责"像不像",关系库负责"谁传的、能不能删、删干净没有"。
4.7 把上面六步搬到后台跑
这六步一开始是同步做的,问题很直白:文档一大,上传接口就卡在那儿等切片和嵌入跑完,几十秒起步,前端只能干等。
改成异步之后,上传接口只做两件事——把文件存进自己的目录,往 mysql 插一条 processing 记录,然后立刻返回。剩下的活交给后台线程,前端拿 docuuid 去轮询状态接口。
// 同步部分:落盘 + 登记,然后提交任务就返回
documentmapper.insertselective(row);
submitimport(docuuid);
return toinfo(row);          // 此时状态是 processing
有两个坑必须提前避开。
@async 的方法得放在另一个 bean 里。它靠 spring 代理生效,同一个类里 this.process() 自己调自己,压根不经过代理,任务会当场退化成同步执行——代码看着没错,行为全错。
文件必须在提交任务之前落盘。multipartfile 背后的临时文件在请求结束就被清理,后台线程再去读已经没了。
后台那一侧还有三道保险:
// 收尾时带上状态条件:这行被人删过或改过,就不能再写成 done
int updated = documentmapper.updatebyquery(done, querywrapper.create()
        .where("doc_uuid = ?", docuuid)
        .and("status = ?", "processing"));
if (updated == 0) {
    safedeletevectors(docuuid, writtenchunks);   // 刚写进去的向量成了孤儿,清掉
}
失败时按本次切片数把向量删干净,不留"只进了一半"的文档参与检索;删除接口碰到 processing 直接拒绝,防止"刚删完、后台又把向量写回来";线程池用有界队列,队列满了把记录标成 failed 并写明原因,不许出现永远停在 processing 的僵尸行。
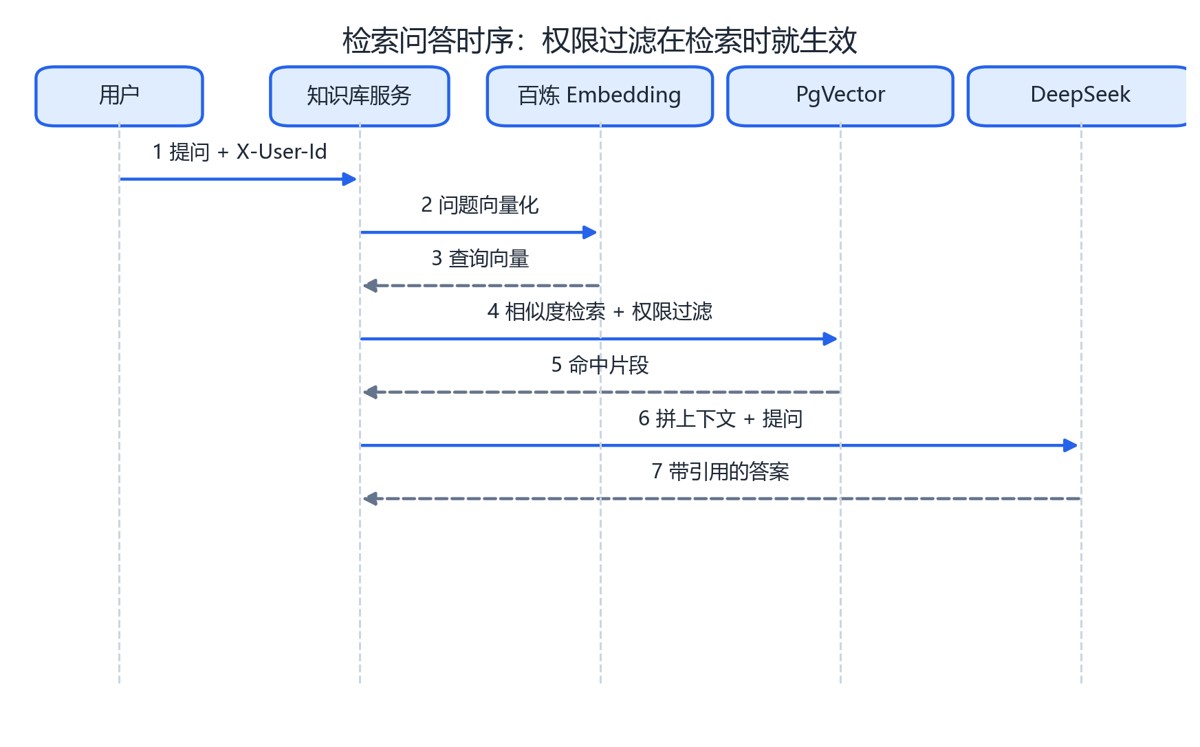
五、检索:权限过滤要在检索时就生效
多用户隔离最容易做错的地方在这。检索时的过滤条件是这样拼的:
filterexpressionbuilder builder = new filterexpressionbuilder();
filter.expression filter = builder
        .or(builder.eq("user_id", userid), builder.eq("visibility", visibility_public))
        .build();
list<document> hits = vectorstore.similaritysearch(searchrequest.builder()
        .query(request.question())
        .topk(topk)                  // 默认 4
        .filterexpression(filter)
        .build());
三个点值得说明。
过滤条件要交给向量库去执行,别捞回来在 java 里筛。原因是相似度检索的截断发生在过滤之后:数据库层面就是 where ... order by ... limit。你要是先捞 4 条再在代码里剔掉别人 3 条,你实际只用了 1 条,还白花了检索开销。
visibility 是检索条件,不是前端的显示开关。前端藏起来的按钮挡不住接口调用。
这里问的是另一个 chatclient,没挂对话记忆 advisor,免得知识库问答把恋爱咨询的会话记忆带偏。
答案拼装时给每段资料编号,让模型标注引用:
string answer = ragchatclient.prompt()
        .system("你是知识库助手。只依据用户提供的资料回答问题,"
                + "资料里没有的信息要明确说不知道,不要编造;回答末尾用 [编号] 标注引用来源。")
        .user("资料:\n" + context + "\n问题:" + request.question())
        .call()
        .content();
返回体里除了答案,还带一份来源列表,前端能点开看到是哪个文件的第几片。用户能核对,你才能接住"模型瞎说"的投诉。
六、实测结果
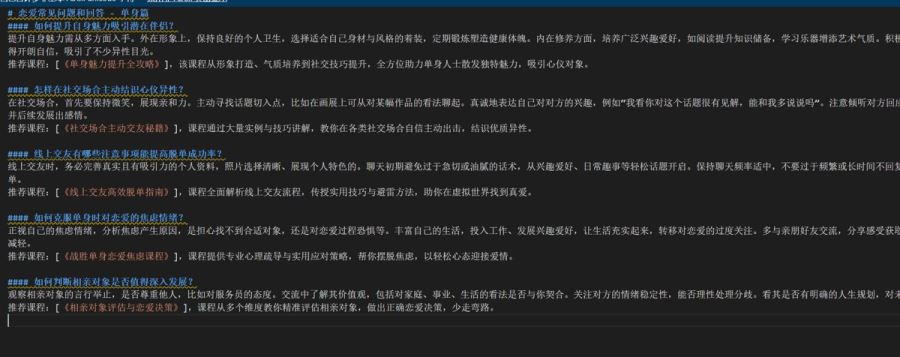
拿一篇 40 节的 md 文档跑了一遍完整链路,数据都在真实环境里:上传接口立刻返回 processing,后台把这篇文档切成 80 片,postgresql 的 vector_store 表按 doc_uuid 统计正好 80 行,和 knowledge_document.chunk_count 对得上;调用删除接口后,该文档的向量行数归零。
检索侧用一个标记串做了验证:写入一条带独特标记的文档,用这个标记当查询词,topk=1 加标记过滤,能准确命中刚写进去的那条,返回的 id 和写入时一致。
异步这条路径单独测了两件事:上传返回时状态必须是 processing——这篇文档要发多次嵌入请求,不可能在返回前跑完;导入进行中调删除接口必须被拒。两条都过了。
七、坑点提醒
别把 pg 的数据源注册成 bean。 项目主库是 mysql,spring boot 按类型找 datasource。你再放一个 pg 的 datasource bean 进去,主数据源会被顶掉,mybatis-flex 连的库直接换人。所以在建 vectorstore 的方法内部 new 一个 hikaridatasource,不要交出去:
@bean
public vectorstore vectorstore(embeddingmodel embeddingmodel, loveragproperties properties) {
    loveragproperties.pgvector pg = properties.getpgvector();
    hikariconfig hikariconfig = new hikariconfig();
    hikariconfig.setjdbcurl("jdbc:postgresql://%s:%d/%s"
            .formatted(pg.gethost(), pg.getport(), pg.getdatabase()));
    hikaridatasource datasource = new hikaridatasource(hikariconfig);
    // 交给 pgvectorstore,方法执行完不要暴露给容器
    return pgvectorstore.builder(new jdbctemplate(datasource), embeddingmodel)
            /*
             * 省略维度、索引类型、距离算法等配置
             */
            .build();
}- pgvector 的 id 必须是 uuid。 塞
doc-1这种进去,插入直接报错。 - deepseek 没有嵌入接口,向量化得换一家。 而且 openai 的自动配置会顺手配一个指向 deepseek 地址的 embedding 模型,得显式排掉:
@springbootapplication(exclude = openaiembeddingautoconfiguration.class)。 - 余额不足报的是 402。 嵌入服务余额用完,抛的是
nontransientaiexception: http 402 - insufficient balance。看到nontransient就知道重试没用,去充值,别在代码里找 bug。 - 删向量别指望按条件删。 早期用
simplevectorstore试过 filter 删除,它不支持,所以才改成确定性 id、按 id 删。换到 pgvector 之后这条路依然最省事,也不需要额外权限配置。 - pg 的库要选对。 连默认的
postgres库没有建 schema 权限,会卡在初始化表结构那一步。给它一个独立库。 - 切片是成本开关。 800 token 一片、每轮捞 4 片,等于每次问答固定消耗三千多 token 的上下文。这个值调大之前先算账。
- 异步了也别把上传当导入成功。 上传接口返回的
processing只代表任务排上了,真正的结果要看状态接口。前端该轮询就轮询,别拿 200 当"导入完成"。 - 队列是有界的。 线程池队列排满时任务会被拒,记录直接标
failed并写明原因。并发上传量大的话,queue-capacity和线程数都得按机器调。
八、老码的总结
把文档变成能搜的知识,真正要做的是三件事:读进来、切干净、贴好标签。模型只负责最后那一段组织语言。
权限过滤记得交给向量库,别自己捞回来筛;切片 id 记得用确定性生成,删的时候才找得回。
先看日志,别慌,问题不大。
到此这篇关于springai+rag检索文档变知识:从上传到精准检索的完整链路(最新推荐)的文章就介绍到这了,更多相关springai rag检索文档内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!





发表评论