
 我要评论
1.介绍
1.1 什么是正则表达式
正则表达式(regular expression),是一种用于处理字符串的强大工具。它主要用于两个方面:
模式匹配:检查一个字符串是否包含某种特定的模式。例如,我们可以使用正则表达式来检查一个字符串是否包含特定的单词或者是否符合特定的格式(如邮件地址、电话号码等)。
字符串操作:基于特定的模式来分割、替换或者提取字符串。例如,我们可以使用正则表达式来替换字符串中的某个单词,或者提取出字符串中符合特定格式的部分。
正则表达式的核心是一套定义模式的语法规则,通过这套规则,我们可以构造出各种复杂的模式。这套语法规则包括了一些特殊的元字符(如.、*、+等)、转义序列(如\d、\w等)和量词(如*、+、?等)。
1.2 什么是oracle正则表达式
oracle正则表达式是oracle数据库对正则表达式功能的实现。oracle数据库提供了一组正则表达式函数,这些函数可以在sql语句中使用,以便在处理字符串数据时使用正则表达式。
这些函数包括:
regexp_like:检查一个字符串是否匹配一个正则表达式模式。regexp_substr:从一个字符串中提取匹配一个正则表达式模式的子串。regexp_replace:替换一个字符串中匹配一个正则表达式模式的部分。regexp_instr:返回一个字符串中匹配一个正则表达式模式的部分的位置。regexp_count:计算一个字符串中匹配一个正则表达式模式的部分的数量。
oracle正则表达式的语法规则和通用的正则表达式大致相同,但也有一些oracle特有的规则和特性。
2. oracle正则表达式的基础知识
2.1 常用的元字符
元字符是正则表达式中具有特殊含义的字符。以下是一些常用的元字符:
.:匹配任何单个字符(除了换行符)。^:匹配输入字符串的开始位置。$:匹配输入字符串的结束位置。*:匹配前面的子表达式零次或多次。+:匹配前面的子表达式一次或多次。?:匹配前面的子表达式零次或一次。[...]:定义一个字符集,匹配其中任何一个字符。[^...]:定义一个反向字符集,匹配不在其中的任何一个字符。{n}:精确匹配n次。{n,}:匹配n次或更多次。{n,m}:匹配至少n次,但不超过m次。
2.2 常用的转义序列
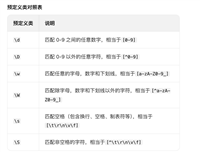
转义序列是一种特殊的字符序列,用于匹配一类特定的字符。以下是一些常用的转义序列:
\d:匹配一个数字字符。等价于[0-9]。\d:匹配一个非数字字符。等价于[^0-9]。\w:匹配一个单词字符(字母、数字或下划线)。等价于[a-za-z0-9_]。\w:匹配一个非单词字符。等价于[^a-za-z0-9_]。\s:匹配一个空白字符(包括空格、制表符、换页符、换行符等)。\s:匹配一个非空白字符。
2.3 常用的量词
量词用于指定一个字符或一组字符可以出现的次数。以下是一些常用的量词:
*:匹配前面的字符或组零次或多次。+:匹配前面的字符或组一次或多次。?:匹配前面的字符或组零次或一次。{n}:匹配前面的字符或组n次。{n,}:匹配前面的字符或组n次或更多次。{n,m}:匹配前面的字符或组至少n次,但不超过m次。
注意,oracle正则表达式默认是贪婪匹配,也就是说,会尽可能多地匹配字符。如果要进行最小匹配(也称为懒惰匹配或非贪婪匹配),可以在量词后面添加?,如*?、+?、??、{n,m}?等。
3. oracle正则表达式的函数
oracle提供了一系列的正则表达式函数,这些函数可以用于在sql语句中进行复杂的字符串处理。以下是这些函数的详细介绍:
3.1 regexp_like
regexp_like函数用于检查一个字符串是否匹配一个正则表达式模式。如果匹配,函数返回true,否则返回false。
语法:
regexp_like(source_string, pattern [, match_parameter])
source_string:源字符串,即需要进行匹配的字符串。pattern:正则表达式模式。match_parameter:匹配参数,用于指定匹配的模式。例如,'i'表示忽略大小写,'c'表示区分大小写,'n'表示允许使用.匹配换行符,'m'表示多行模式,'x'表示忽略空白字符和#之后的字符。
3.2 regexp_substr
regexp_substr函数用于从一个字符串中提取匹配一个正则表达式模式的子串。
语法:
regexp_substr(source_string, pattern [, position [, occurrence [, match_parameter [, sub_expression]]]])
source_string:源字符串。pattern:正则表达式模式。position:开始搜索的位置,如果省略,默认为1。occurrence:匹配的次数,如果省略,默认为1。match_parameter:匹配参数,同regexp_like。sub_expression:子表达式的位置,用于提取括号中的子表达式。
3.3 regexp_replace
regexp_replace函数用于替换一个字符串中匹配一个正则表达式模式的部分。
语法:
regexp_replace(source_string, pattern, replace_string [, position [, occurrence [, match_parameter]]])
source_string:源字符串。pattern:正则表达式模式。replace_string:替换字符串。position:开始搜索的位置,如果省略,默认为1。occurrence:匹配的次数,如果省略,默认为所有匹配的部分。match_parameter:匹配参数,同regexp_like。
3.4 regexp_instr
regexp_instr函数返回一个字符串中匹配一个正则表达式模式的部分的位置。
语法:
regexp_instr(source_string, pattern [, position [, occurrence [, return_option [, match_parameter [, sub_expression]]]]])
source_string:源字符串。pattern:正则表达式模式。position:开始搜索的位置,如果省略,默认为1。occurrence:匹配的次数,如果省略,默认为1。return_option:返回选项,如果为0,返回匹配的开始位置,如果为1,返回匹配的结束位置,如果省略,默认为0。match_parameter:匹配参数,同regexp_like。sub_expression:子表达式的位置,用于提取括号中的子表达式。
3.5 regexp_count
regexp_count函数计算一个字符串中匹配一个正则表达式模式的部分的数量。
语法:
regexp_count(source_string, pattern [, position [, match_parameter]])
source_string:源字符串。pattern:正则表达式模式。position:开始搜索的位置,如果省略,默认为1。match_parameter:匹配参数,同regexp_like。
4. oracle正则表达式的应用实例
以下是一些使用oracle正则表达式函数的应用实例:
4.1 使用regexp_like进行模式匹配
假设我们有一个员工表employees,我们想找出所有名字以字母"a"开头的员工:
select first_name
from employees
where regexp_like(first_name, '^a');
4.2 使用regexp_substr提取匹配的子串
假设我们有一个字符串,我们想提取其中的数字:
select regexp_substr('123 main street', '\d+') as extracted_number
from dual;
这将返回’123’,这是字符串中的第一个数字序列。
4.3 使用regexp_replace替换匹配的子串
假设我们有一个字符串,我们想将其中的所有数字替换为’x’:
select regexp_replace('123 main street', '\d', 'x') as replaced_string
from dual;
这将返回’xxx main street’。
4.4 使用regexp_instr找到匹配的位置
假设我们有一个字符串,我们想找到第一个数字的位置:
select regexp_instr('123 main street', '\d') as position
from dual;
这将返回1,因为第一个数字在字符串的第一个位置。
4.5 使用regexp_count计算匹配的次数
假设我们有一个字符串,我们想计算其中的数字的数量:
select regexp_count('123 main street', '\d') as count
from dual;
这将返回3,因为字符串中有3个数字。
5. oracle正则表达式的性能优化
使用正则表达式时,性能是一个重要的考虑因素。以下是一些优化oracle正则表达式性能的建议:
5.1 正确使用元字符和量词
元字符和量词的使用可以大大影响正则表达式的性能。例如,贪婪量词(如*和+)可能会导致大量的回溯,从而降低性能。如果可能,使用非贪婪量词(如*?和+?),或者使用更具体的模式来减少匹配的可能性。
5.2 使用预编译的正则表达式
预编译的正则表达式可以提高性能,因为它们只需要编译一次,然后可以被多次使用。在oracle中,可以使用dbms_sql包中的regexp_like函数来预编译正则表达式。
5.3 选择合适的正则表达式函数
oracle提供了多种正则表达式函数,每种函数都有其特定的用途。选择最适合你需要的函数可以提高性能。例如,如果你只需要检查一个字符串是否匹配一个模式,而不需要提取或替换匹配的部分,那么regexp_like可能是最好的选择。如果你需要提取匹配的部分,那么regexp_substr可能是最好的选择。如果你需要替换匹配的部分,那么regexp_replace可能是最好的选择。
此外,如果你的查询涉及到大量的数据,考虑在可能的情况下,使用正则表达式的索引,这可以大大提高查询性能。
6. oracle正则表达式的注意事项
在使用oracle正则表达式时,有一些重要的注意事项需要考虑:
6.1 正则表达式的特殊字符处理
正则表达式中的一些字符具有特殊的含义,例如*, +, ?, ., ^, $, |, (), [], {}, \等。如果你想在正则表达式中使用这些字符的字面值,你需要使用\进行转义。例如,如果你想匹配字符串10.00,你需要写成10\.00,否则.将匹配任何字符。
6.2 正则表达式的贪婪匹配和懒惰匹配
正则表达式中的量词默认是贪婪的,这意味着它们会尽可能多地匹配字符。例如,正则表达式a.*b将匹配从第一个a到最后一个b之间的所有字符。
如果你想进行懒惰匹配(即尽可能少地匹配字符),你可以使用?来修改量词。例如,正则表达式a.*?b将匹配从第一个a到第一个b之间的所有字符。
在使用贪婪匹配和懒惰匹配时,需要注意可能的性能影响。贪婪匹配可能会导致大量的回溯,从而降低性能。如果可能,尽量使用更具体的模式来减少匹配的可能性。
7. 实战案例
提取字符串中的年份
如果你想从一个包含日期的字符串中提取年份,你可以使用
regexp_substr函数。例如:select regexp_substr('the event will happen on 2024-10-29.', '(\d{4})') as year from dual;这将返回
2024。
验证密码复杂性
可以使用
regexp_like函数来验证密码是否包含至少一个大写字母,一个小写字母,一个数字和一个特殊字符。例如:select password from users where regexp_like(password, '(?=.*[a-z])(?=.*[a-z])(?=.*\d)(?=.*[\w_])');
提取url的协议、主机和路径
可以使用
regexp_substr函数来提取url的协议、主机和路径。例如:select regexp_substr('https://www.example.com/page', '(https?|ftp)://') as protocol, regexp_substr('https://www.example.com/page', '(https?|ftp)://([^/]+)/') as host, regexp_substr('https://www.example.com/page', '(https?|ftp)://[^/]+(/.+)') as path from dual;这将返回
https://,www.example.com和/page。
验证ip地址
可以使用
regexp_like函数来验证ip地址。例如:select ip from ips where regexp_like(ip, '^((25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?)\.){3}(25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?)$');
提取字符串中的邮件地址
可以使用
regexp_substr函数来提取字符串中的邮件地址。例如:select regexp_substr('my email is john.doe@example.com.', '([a-za-z0-9._%-]+@[a-za-z0-9.-]+\.[a-za-z]{2,4})') as email from dual;这将返回
john.doe@example.com。
替换html标签
可以使用
regexp_replace函数来替换html标签。例如:select regexp_replace('<p>hello world</p>', '<[^>]+>', '') from dual;这将返回
hello world。
提取字符串中的电话号码
可以使用
regexp_substr函数来提取字符串中的电话号码。例如:select regexp_substr('my phone number is (123) 456-7890.', '\((\d{3})\)\s*(\d{3})-(\d{4})') as phone from dual;这将返回
(123) 456-7890。
匹配信用卡号
可以使用
regexp_like函数来匹配信用卡号。例如:select card from cards where regexp_like(card, '^(?:4[0-9]{12}(?:[0-9]{3})?|5[1-5][0-9]{14}|6(?:011|5[0-9][0-9])[0-9]{12}|3[47][0-9]{13}|3(?:0[0-5]|[68][0-9])[0-9]{11}|(?:2131|1800|35\d{3})\d{11})$');
提取字符串中的url
可以使用
regexp_substr函数来提取字符串中的url。例如:select regexp_substr('check out https://www.example.com.', '(https?|ftp)://[^\s/$.?#].[^\s]*') as url from dual;这将返回
https://www.example.com。
匹配社会安全号码
可以使用
regexp_like函数来匹配社会安全号码。例如:select ssn from ssns where regexp_like(ssn, '^\d{3}-\d{2}-\d{4}$');
以上的每个案例都展示了正则表达式在实际应用中的使用,包括提取、替换、验证和匹配等多种场景。
总结
到此这篇关于oracle正则表达式的基础及实战案例的文章就介绍到这了,更多相关oracle正则表达式内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!




发表评论