 我要评论
pod 的那些状态
使用 k8s 部署我们的服务之后,为了观察 pod 是否成功,我们都会使用下面这个命令查询 pod 的状态。
kubectl get pods
name                         ready   status              restarts   age
my-app-5d7d978fb9-2fj5m      0/1     containercreating   0          10s
my-app-5d7d978fb9-dbt89      0/1     containercreating   0          10s
这里的 status 代表了 pod 的状态,可能会遇到的状态有下面几个:
- containercreating:代表容器正在创建,这是一个中间状态,随着容器创建成功会切换,但是也有可能一直卡在这里,具体问题下面会分析。
- imagepullbackoff:容器镜像拉取失败,具体原因需要结合 describe 命令再去查看。
- crashloopbackoff:容器崩溃,一般容器崩溃,deployment 会重新创建一个 pod,维持副本数量,但是大概率新创建的pod 还是会崩溃,它不会无限尝试,崩溃超过设置次数就不会再尝试重建pod,此时pod的状态就维持在了 crashloopbackoff。
- evicted: 因为节点资源不足(cpu/mem/storage都有可能),pod 被驱逐会显示 evicted 状态,k8s 会按照策略选择认为可驱逐的pod从节点上 kill 掉。
- running 这个代表 pod 正常运行。
下面我们来看一下 pod 的几个错误状态的原因,以及怎么排查解决它们。
镜像拉取失败
镜像拉取失败后 pod 的状态字段表示为 imagepullbackoff,这个发生的情况还是很多的,原因除了我们不小心写错镜像名字之外,还有就是常用软件的一些官方镜像都在国外,比如在docker.io 或者 quay.io 的镜像仓库上,有的时候访问速度会很慢。
下面我们自己故意制造一个镜像名字写错的场景,看怎么使用 kubectl 命令进行排查。比如我在 k8s 教程里一直用的 deployment 定义:
apiversion: apps/v1
kind: deployment
metadata:
  name: my-go-app
spec:
  replicas: 2
  selector:
    matchlabels:
      app: go-app
  template:
    metadata:
      labels:
        app: go-app
    spec:
      containers:
        - name: go-app-container
          image: kevinyan001/kube-go-app:v0.3
          resources:
            limits:
              memory: "200mi"
              cpu: "50m"
          ports:
            - containerport: 3000
          volumemounts:
            - name: app-storage
              mountpath: /tmp
      volumes:
        - name: app-storage
          emptydir: {}
我们把镜像的名字故意改错,改成 v0.5,这个镜像是我自己打的,确实还没有 0.5 版本。执行kubectl apply 后,来观察一下 pod 的状态。
➜ kubectl apply -f deployment.yaml
deployment.apps/my-go-app configured
➜ kubectl get pods
name                         ready   status              restarts   age
my-go-app-5d7d978fb9-2fj5m   1/1     running             0          3h58m
my-go-app-5d7d978fb9-dbt89   1/1     running             0          3h58m
my-go-app-6b77dbbcc5-jpgbw   0/1     containercreating   0          7s
➜ kubectl get pods
name                         ready   status         restarts   age
my-go-app-5d7d978fb9-2fj5m   1/1     running        0          3h58m
my-go-app-5d7d978fb9-dbt89   1/1     running        0          3h58m
my-go-app-6b77dbbcc5-jpgbw   0/1     errimagepull   0          14s
.....// 停顿1分钟,再查看pod 的状态
➜ kubectl get pods
name                         ready   status             restarts   age
my-go-app-5d7d978fb9-2fj5m   1/1     running            0          4h1m
my-go-app-5d7d978fb9-dbt89   1/1     running            0          4h1m
my-go-app-6b77dbbcc5-jpgbw   0/1     imagepullbackoff   0          3m11s
上面我们更新了 deployment 之后,观察到 pod 的状态变化过程是:
containercreating ===> errimagepull ===> imagepullbackoff
首先 deployment 更新 pod 时是滚动更新,要先把新 pod 创建出来后能对旧版本 pod 完成替换。接下来由于镜像拉取错误会反馈一个中间状态 errimagepull,此时会再次尝试拉取,如果确定镜像拉取不下来后,最后反馈一个失败的终态 imagepullbackoff。
怎么排查是什么导致的拉取失败呢?通过 kubectl describe pod {pod-name} 查看它的事件记录
➜ kubectl describe pod my-go-app-6b77dbbcc5-jpgbw
name:         my-go-app-6b77dbbcc5-jpgbw
namespace:    default
priority:     0
...
controlled by:  replicaset/my-go-app-6b77dbbcc5
containers:
  go-app-container:
    container id:
    image:          kevinyan001/kube-go-app:v0.5
    image id:
    port:           3000/tcp
    host port:      0/tcp
    state:          waiting
      reason:       errimagepull
    ready:          false
...
node-selectors:              <none>
tolerations:                 node.kubernetes.io/not-ready:noexecute op=exists for 300s
                             node.kubernetes.io/unreachable:noexecute op=exists for 300s
events:
  type     reason     age                  from               message
  ----     ------     ----                 ----               -------
  normal   scheduled  2m12s                default-scheduler  successfully assigned default/my-go-app-6b77dbbcc5-jpgbw to docker-desktop
  normal   pulling    27s (x4 over 2m12s)  kubelet            pulling image "kevinyan001/kube-go-app:v0.5"
  warning  failed     20s (x4 over 2m4s)   kubelet            failed to pull image "kevinyan001/kube-go-app:v0.5": rpc error: code = unknown desc = error response from daemon: manifest for kevinyan001/kube-go-app:v0.5 not found: manifest unknown: manifest unknown
  warning  failed     20s (x4 over 2m4s)   kubelet            error: errimagepull
  normal   backoff    4s (x5 over 2m4s)    kubelet            back-off pulling image "kevinyan001/kube-go-app:v0.5"
  warning  failed     4s (x5 over 2m4s)    kubelet            error: imagepullbackoff
pod 事件记录里,清楚记录了 pod 从开始到最后经历的状态变化,以及是什么导致状态变化的,其中失败事件里清楚的给出了我们原因,就是镜像找不到。
events:
  type     reason     age                  from               message
  ----     ------     ----                 ----               -------
  warning  failed     20s (x4 over 2m4s)   kubelet            failed to pull image "kevinyan001/kube-go-app:v0.5": rpc error: code = unknown desc = error response from daemon: manifest for kevinyan001/kube-go-app:v0.5 not found: manifest unknown: manifest unknown
  warning  failed     20s (x4 over 2m4s)   kubelet            error: errimagepull
  normal   backoff    4s (x5 over 2m4s)    kubelet            back-off pulling image "kevinyan001/kube-go-app:v0.5"
  warning  failed     4s (x5 over 2m4s)    kubelet            error: imagepullbackoff
还有一种是网络原因,或者镜像仓库没有权限拒绝拉取请求,导致无法拉取成功。因为我这里网络环境、加速器之类的好不容易都配好了,就不给大家演示这两种情况了。
不过排查方式也是一样,使用kubectl describe 命令查看 pod 的事件,并且使用 docker pull 尝试主动的拉取一下镜像试试,如果确实网络问题拉取不下来的,可以考虑翻墙,或者使用国内的加速节点。
配置加速器,可以考虑使用阿里云的免费加速器,配置文档在下面,需要注册阿里云账号才能使用加速器
https://help.aliyun.com/product/60716.html
启动后容器崩溃
再来看这种错误,这种一般是容器里运行的程序内部出问题导致的容器连续崩溃出现的问题。最后反馈到 pod 状态上是 crashloopbackoff 状态。
演示容器运行中崩溃的情况有点难,不过好在我之前介绍 go 服务自动采样的时候,做过一个镜像
以下内容引用我之前的文章:go 服务进行自动采样性能分析的方案设计与实现
我做了个docker 镜像方便进行试验,镜像已经上传到了docker hub上,大家感兴趣的可以down下来自己在电脑上快速试验一下。
通过以下命令即可快速体验。
docker run --name go-profile-demo -v /tmp:/tmp -p 10030:80 --rm -d kevinyan001/go-profiling
容器里go服务提供的路由如下
所以我们把上面的 deployment pod 模版里的镜像换成这个 kevinyan001/go-profiling,再通过提供的路由手动制造 oom,来故意制造容器崩溃的情况。
修改pod 使用的容器镜像
#执行 kubectl apply -f deployment.yaml
apiversion: apps/v1
kind: deployment
metadata:
  name: my-go-app
spec:
  replicas: 2
  selector:
    matchlabels:
      app: go-app
  template:
    metadata:
      labels:
        app: go-app
    spec:
      containers:
        - name: go-app-container
          image: kevinyan001/go-profiling:latest
          resources:
            limits:
              memory: "200mi"
              cpu: "50m"
创建个 svc 让pod能接受外部流量
#执行 kubectl apply -f service.yaml
apiversion: v1
kind: service
metadata:
  name: app-service
spec:
  type: nodeport
  selector:
    app: go-app
  ports:
    - name: http
      protocol: tcp
      nodeport: 30080
      port: 80
      targetport: 80
程序中提供的路由如下:
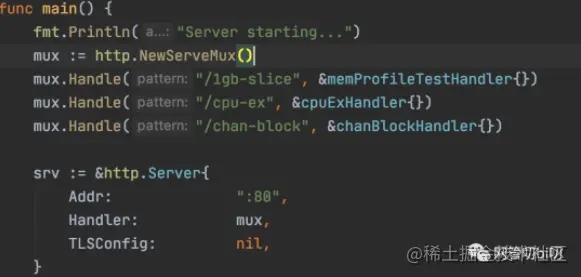
访问 http://127.0.0.1:30080/1gb-slice 让容器内存溢出,因为 deployment 会重启崩溃的 pod,所以这里非常考验手速:) 估计狂点一分钟,deployment 就放弃治疗休息会儿再重启 pod,这时 pod 的状态成功变成了:
➜ kubectl get pods
name                         ready   status             restarts      age
my-go-app-598f697676-f5jfp   0/1     crashloopbackoff   2 (18s ago)   5m37s
my-go-app-598f697676-tps7n   0/1     crashloopbackoff   2 (23s ago)   5m35s
这个时候我们使用 kubectl describe pod 看崩溃 pod 的详细信息,会看到容器内程序返回的错误码
➜ kubectl describe pod my-go-app-598f697676-tps7n
name:         my-go-app-598f697676-tps7n
namespace:    default
    port:           3000/tcp
    host port:      0/tcp
    state:          running
      started:      sun, 20 mar 2022 16:09:29 +0800
    last state:     terminated
      reason:       error
      exit code:    137
      started:      sun, 20 mar 2022 16:08:56 +0800
      finished:     sun, 20 mar 2022 16:09:05 +0800
不过要深入排查 pod 内容器的问题,需要另一个命令 kubectl logs {pod-name} 的协助。
kubectl logs my-go-app-598f697676-tps7n
如果恰巧这个 pod 被重启了,查不出来任何东西,可以通过增加 — previous 参数选项,查看之前容器的日志。
kubectl logs my-go-app-598f697676-tps7n --previous
容器被驱逐
首先声明,这个问题研发解决不了,但是你发挥一下自己yy的能力:当群里报警、运维@你赶紧看的时候,你来个反杀,告诉他资源不够了赶紧扩容,是不是能装到^_^…
扯远了,现在回正题。集群里资源紧张的时候,k8s 会优先驱逐优先级低的 pod,被驱逐的 pod 的状态会是 evicted,这个情况没办法在本地模拟,贴一个在公司k8s集群遇到这种情况的截图。
kubectl get pod 查看pod状态
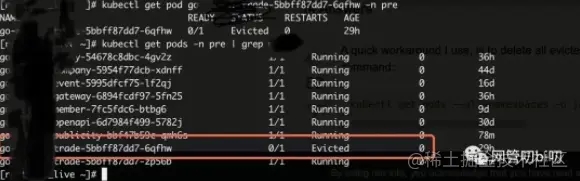
上图可以看到有一个pod 的状态变成了 evicted。
再来用describe 看下详细信息
kubectl describe pod 查看pod 的详细信息和事件记录
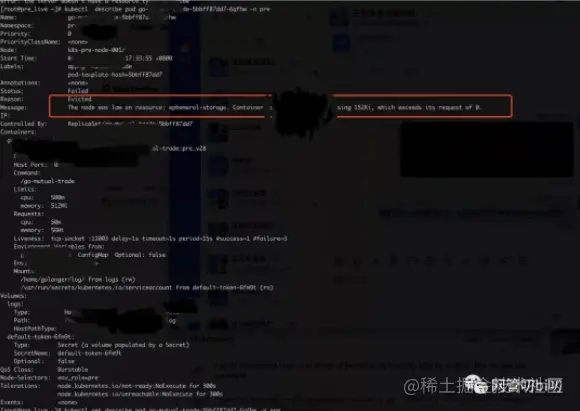
不好意思,历史久远,上面的图太模糊了,图中的message 一栏里有给出如下信息:
status: faild
reason: evicted
message: the node wan low on resource: xxx-storage. container xxx using xxxki,
which exceeds its request of ....
总结
一般来说,大多数常见的部署失败都可以使用这些命令进行排查和调试:
kubectl get pods
kubectl describe pod <podname>
kubectl logs <podname>
kubectl logs <podname> --previous
当然,有的时候想看 pod 的配置信息,还可以使用
kubectl get pod <podname> -o=yaml
验证一下pod的配置是不是跟我们提交上去的一样,以及一些其他的额外信息。
get 和 describe 这两个命令除了能看 pod 的状态和信息记录外,也能看其他资源的状态和信息。
kubectl get pod|svc|deploy|sts|configmap <xxx-name>
kubectl describe pod|svc|deploy|sts|configmap <xxx-name>
这些就留给大家后面自己体验吧。为了方便大家在本地试验,在公众号「网管叨bi叨」回复【k8s】能找到今天用的各种yaml的模版,感兴趣的可以动手实践起来。
以上就是kubernetes k8s常用问题排查方法的详细内容,更多关于kubernetes k8s问题排查方法的资料请关注代码网其它相关文章!
发表评论