
 我要评论
前面几篇我们聊了右值引用、移动语义、可变参数模板。这篇来个 c++11 里最好用的东西——lambda 表达式,再配两个包装器
std::function和std::bind。学会了以后,排序传比较函数再也不用为它单独写一个仿函数类了。
一、lambda 表达式语法
lambda 就是一个匿名函数对象。它跟普通函数最大的区别是——可以写在函数里面。而且 lambda 在使用层面是看不到它的类型的,所以一般用 auto 或者模板参数去接它。
完整写法长这样:
[capture-list] (parameters) -> return-type { function body }
拆开看:
[capture-list]:捕捉列表,永远是 lambda 开头的那一对方括号。编译器就是靠这个[]来判断"哦,这是个 lambda"。它能把上下文里的变量抓进来给 lambda 用,可以值捕捉也可以引用捕捉,具体细节后面讲。这里先记住两条:一是捕捉列表抓的是上下文变量,跟我们平时函数传参向上找不是一回事;二是就算一个变量都不抓,这对方括号也不能省。(parameters):参数列表,跟普通函数没区别。不需要参数的时候,连括号一起省掉就行。-> return-type:返回值类型,用的是追踪返回类型那套写法。没有返回值可以省略;返回值类型很明显的时候也可以让编译器自己推导。注意,省略返回值的时候->要一起省掉。{ function body }:函数体,跟普通函数写法一样。里面除了参数,还能用所有抓进来的变量。函数体就算空着也不能省。
看个最简单的例子:
int main()
{
    // 一个简单的lambda表达式
    auto add1 = [](int x, int y)->int {return x + y; };
    cout << add1(1, 2) << endl;
    // 1、捕捉为空也不能省略
    // 2、参数为空可以省略
    // 3、返回值可以省略,可以通过返回对象自动推导
    // 4、函数体不能省略
    auto func1 = []    //返回值类型确定,省略->return-type,实际上大部分情况返回值类型都确定
    {
        cout << "hello world" << endl;
        return 0;
    };
    func1();
    int a = 0, b = 1;
    auto swap1 = [](int& x, int& y)    //无返回值,省略->return-type
    {
        int tmp = x;
        x = y;
        y = tmp;
    };
    swap1(a, b);
    cout << a << ":" << b << endl;
    return 0;
}
二、lambda 底层原理
lambda 编译器到底是怎么处理的?其实很简单——它自动生成一个匿名类,然后在里面把 operator() 重载了。
拿上面那个 swap1 举例,编译器翻译完大概长这样:
// 编译器生成的匿名类(没有名字)
struct __lambda_xxx
{
    void operator()(int x, int y) const {
        int tmp = x;
        x = y;
        y = tmp;
    }
};
然后构造这个对象,赋值给 swap1:
__lambda_xxx swap1;
调用 swap1(...),本质上就是:
swap1.operator()(a, b);
跟自己写个仿函数类一模一样,只不过省了起名字那一步——这也是为什么 lambda 用起来这么顺手,底层跟手写仿函数没区别。
三、捕捉列表
lambda 里面默认只能用自己的参数和函数体里定义的局部变量。想用外面的变量?那就得抓进来——这就是捕捉列表干的事。这节规则多一点,跟着代码例子走就清楚。
3.1 三种捕捉方式
第一种,显式捕捉——直接在方括号里写清楚抓谁。多个变量用逗号隔开。比如 [x, y, &z] 就是 x、y 值抓,z 引用抓。
第二种,隐式捕捉——不用一个个写,直接在方括号里写个 =,表示"用到什么就值抓什么";写个 &,表示"用到什么就引用抓什么"。lambda 里用到谁,编译器自动把谁抓进来。
第三种,混合捕捉——隐式和显式一起用。[=, &x] 表示其他变量值抓,唯独 x 引用抓;[&, x, y] 表示其他变量引用抓,唯独 x、y 值抓。这里有个规矩:混合的时候第一个必须是 & 或 =,而且如果开头是 &,后面显式写的变量就必须值抓;开头是 =,后面显式写的就必须引用抓。不能乱。
3.2 其他几条规矩
- lambda 写在函数里面的时候,只能抓它之前定义的变量。静态局部变量和全局变量是抓不了的——不过这俩本来也不用抓,lambda 里直接就能用。反过来想,lambda 如果写在全局位置,那它的捕捉列表就必须是空的,因为没东西可抓。
- 默认情况下,值抓进来的变量是 const 的,不能改。想改?在参数列表后面加个
mutable就行。不过加了 mutable 改的也是那个拷贝出来的副本,外面原来的变量纹丝不动——就当它是个形参,形参怎么改都影响不了实参。加了 mutable 之后参数列表不能省,哪怕没参数。 - 同一个变量只能抓一次。不管值抓还是引用抓,抓过一次就不能再抓第二次。
完整过一遍:
int y = 10;  // 全局变量
auto x = []() {             // 捕捉列表必须为空,捕捉列表不能捕捉全局或者静态变量
    cout << y << endl;      // 而且全局变量不用捕捉就可以用,没有可被捕捉的变量
};
int main()
{
    // 只能用当前lambda局部域和捕捉的对象和全局对象和静态对象
    int a = 0, b = 1, c = 2;
    // 显式捕捉:a值抓,b引用抓
    auto func1 = [a, &b] {
        //值捕捉默认不可写(const修饰)
        //a++;
        b++;
        int ret = a + b;
        return ret;
    };
    cout << "func1: a+b = " << func1() << endl;
    //隐式值捕捉:用到什么自动值抓
    auto func2 = [=] {
        int ret = a + b + c;
        return ret;
    };
    cout << "func2: a+b+c = " << func2() << endl;
    //隐式引用捕捉:用到什么自动引用抓
    auto func3 = [&] {
        a++;
        b++;
        c++;
    };
    func3();
    cout << "func3-> " << a << " " << b << " " << c << endl;
    //混合捕捉1:&开头,其他变量自动引用抓,a和b显式值抓
    auto func4 = [&, a, b] {
        c++;  // 用到c,自动抓c的引用
    };
    func4();
    cout << "func4-> " << "a+b+c = " << a + b + c << endl;
    //混合捕捉2:=开头,其他变量自动值抓,a和b显式引用抓
    auto func5 = [=, &a, &b]
        {
            a++;
            b++;
            // 下面用到c,自动值抓,默认不可写
            //c++; //报错
            return a + b + c;
        };
    func5();
    cout << "func5-> " << a << " " << b << " " << c << endl;
    // 全局变量和静态变量不能捕捉,也不需要捕捉
    static int st = 1234;
    auto func6 = [] {
        int ret = y + st; //还记得y吗?是我们最上面定义的全局变量
        return ret;
    };
    cout << "func6: " << "x+st = " << func6() << endl;
    // mutable:去掉值捕捉的const,可以改了
    // 但改的是靠背的副本,外面的a、b、c不变,形参改变不影响实参
    auto func7 = [=]()mutable
        {
            a++;
            b++;
            c++;
        };
    func7();
    cout << "func7-> " << a << " " << b << " " << c << endl;
    return 0;
}
四、lambda 的应用
学 lambda 之前,能用的可调用对象无非两种:函数指针和仿函数。函数指针类型写起来麻烦,仿函数还得专门写个类。lambda 就轻松多了。
它用的地方也很广:线程里传执行逻辑、智能指指定删除器……以后会经常碰到。
看个实际例子——给商品排序:
struct goods
{
    string _name;    // 名字
    double _price;   // 价格
    int _evaluate;   // 评价
    // ...
    goods(const char* str, double price, int evaluate)
        : _name(str)
        , _price(price)
        , _evaluate(evaluate)
    {}
};
struct comparepriceless
{
    bool operator()(const goods& gl, const goods& gr)
    {
        return gl._price < gr._price;
    }
};
struct comparepricegreater
{
    bool operator()(const goods& gl, const goods& gr)
    {
        return gl._price > gr._price;
    }
};
int main()
{
    vector<goods> v = { {"苹果", 2.1, 5}, {"香蕉", 3, 4}, {"橙子", 2.2, 3}, {"菠萝", 1.5, 4} };
    // 以前要用仿函数:对每个属性都设计一个比较仿函数,或者设计模板传参,都挺麻烦
    sort(v.begin(), v.end(), comparepriceless());
    sort(v.begin(), v.end(), comparepricegreater());
    // 用 lambda 就舒服多了,比较逻辑直接写在 sort 里
    sort(v.begin(), v.end(), [](const goods& g1, const goods& g2) {
        return g1._price < g2._price;
    });
    sort(v.begin(), v.end(), [](const goods& g1, const goods& g2) {
        return g1._evaluate > g2._evaluate;
    });
    return 0;
}
如果觉得这例子还不够有说服力,那看完下面 function 和 bind,相信一定会更能体会到 lambda 的设计精妙。其实 lambda 设计出来,就是为了做那些"不想专门写个函数也不想写个仿函数类"的轻量小任务——这是理解 lambda 的关键线索
五、std::function 包装器
这节概念不多,重点是看后面的代码——它到底能装哪些东西、怎么装,一看就明白。
5.1 它是个什么东西
template <class t>
class function; // undefined
template <class ret, class... args>
class function<ret(args...)>;
std::function 是个类模板,也是个包装器。它的实例对象可以装下各种可调用对象——函数指针、仿函数、lambda、bind 表达式都行。装进去的那个东西叫它的目标。如果里面没装东西,就叫空 function,去调它就会抛 std::bad_function_call 异常。
定义在 <functional> 头文件里。官方文档:https://legacy.cplusplus.com/reference/functional/function/
5.2 模板参数怎么读
function<ret(args...)> 这个写法看着有点怪——为什么 ret 和 args 挤在一起?按常理不是该写成 <ret ret, args... args> 吗?其实可以这么理解:语言和编译器对它开了个绿灯,就是要把返回值和参数类型写在一对括号里。
那 ret 和 args 分别是什么?ret 是函数返回值类型,args... 是参数类型包。参数个数不定,所以用包。要是参数类型一样呢?比如 int a, int b,包里面是 int, int,不是只写一个 int——按顺序把类型列出来就行。
5.3 各种可调用对象都能装
函数指针、仿函数、lambda 的类型各不相同,但 std::function 一包装就统一了。这在很多地方都方便,比如当 map 的值类型。
#include<functional>
int f(int a, int b)
{
    return a + b;
}
struct functor
{
public:
    int operator() (int a, int b)
    {
        return a + b;
    }
};
class plus
{
public:
    plus(int n = 10)
        :_n(n)
    {}
    static int plusi(int a, int b)
    {
        return a + b;
    }
    double plusd(double a, double b)
    {
        return (a + b) * _n;
    }
private:
    int _n;
};
int main()
{
    // 包装各种可调用对象
    function<int(int, int)> f1 = f;
    function<int(int, int)> f2 = functor();
    function<int(int, int)> f3 = [](int a, int b) {return a + b; };
    cout << f1(1, 1) << endl;
    cout << f2(1, 1) << endl;
    cout << f3(1, 1) << endl;
    // 包装静态成员函数
    // 成员函数要指定类域,而且推荐加取地址符
    function<int(int, int)> f4 = &plus::plusi;
    cout << f4(1, 1) << endl;
    // 建议:不管静态不静态,成员函数一律加 &,省得踩坑
    // 包装普通成员函数
    // 普通成员函数除了类域,“还多一个隐含的 this 指针参数”
    // 所以绑定时传对象、传对象指针都行
    function<double(plus*, double, double)> f5 = &plus::plusd;
    plus pd;
    cout << f5(&pd, 1.1, 1.1) << endl;
    function<double(plus, double, double)> f6 = &plus::plusd;
    cout << f6(pd, 1.1, 1.1) << endl;
    function<double(plus&&, double, double)> f7 = &plus::plusd;
    cout << f7(move(pd), 1.1, 1.1) << endl;
    cout << f7(plus(), 1.1, 1.1) << endl;
    return 0;
}
看完上面代码,一定有人会反驳我:this 指针是不允许显式传递的,那上面
f5(&pd, 1.1, 1.1)传的是什么?function<double(plus*, double, double)> f5 = &plus::plusd;又传的什么?其实我们传的确实不是 this 指针,传的是函数指针——或者说是函数地址。说 this 指针只是为了面向初学者,让初学者好理解,知道"哦,这里得多传一个参数"。所以我在上面加了引号。浅显点理解:传指针就是用指针调这个函数,传类对象就是用对象调,传引用也同理。
六、实战:逆波兰表达式求值
leetcode 题目:https://leetcode.cn/problems/evaluate-reverse-polish-notation/
用 map<string, function> 把运算符字符串和对应的 lambda 绑起来,好处是好扩展——以后加新运算符,map 里加一行映射就完事。
#include <vector>
#include <stack>
#include <map>
#include <functional>
#include <string>
using namespace std;
class solution {
public:
    int evalrpn(vector<string>& tokens) {
        stack<int> st;
        // 用map映射string和function
        // function作为map的值类型
        map<string, function<int(int, int)>> opfuncmap = {
            {"+", [](int x, int y){return x + y;}},
            {"-", [](int x, int y){return x - y;}},
            {"*", [](int x, int y){return x * y;}},
            {"/", [](int x, int y){return x / y;}}
        };
        for(auto& str : tokens)
        {
            if(opfuncmap.count(str))
            {
                int right = st.top();
                st.pop();
                int left = st.top();
                st.pop();
                int ret = opfuncmap[str](left, right);
                st.push(ret);
            }
            else
            {
                st.push(stoi(str));
            }
        }
        return st.top();
    }
};
七、std::bind
这节的概念文字看着有点绕,别硬啃——直接往下看代码例子,看完就懂了。
// simple (1)
template <class fn, class... args>
/* unspecified */ bind (fn&& fn, args&&... args);
// with return type (2)
template <class ret, class fn, class... args>
/* unspecified */ bind (fn&& fn, args&&... args);
bind 也是个函数模板,也是个包装器。可以把它想成一个函数适配器——给它一个可调用对象,它加工一下,再吐出来一个新的可调用对象。主要就干两件事:调整参数个数、调整参数顺序。
一般写法:
auto newcallable = bind(callable, arg_list);
newcallable 本身就是个可调用对象。arg_list 是逗号分隔的参数表,对应原 callable 的参数。等以后调 newcallable(...) 的时候,它就拿着 arg_list 去调原来的 callable。
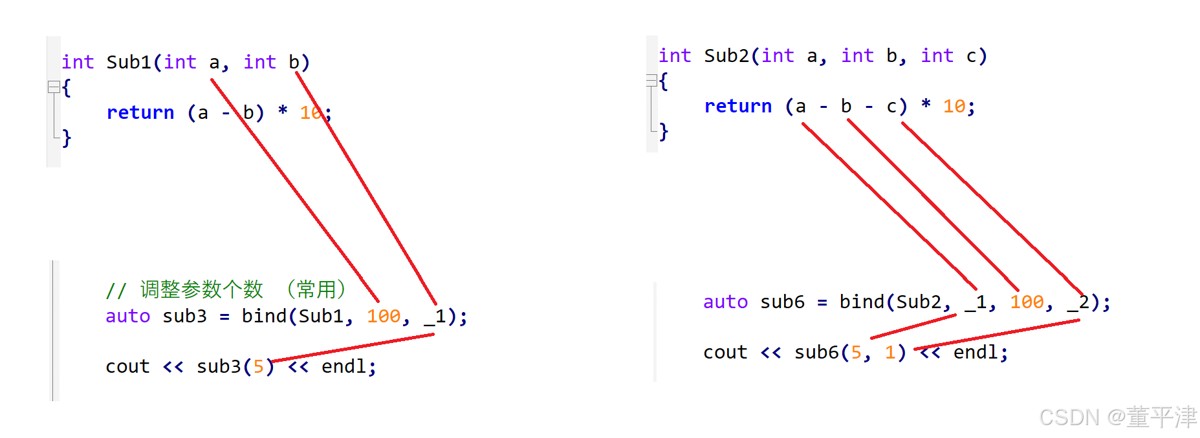
arg_list 里可以写 _n 这种东西,n 是数字,叫占位符——意思是"这里将来由 newcallable 的第 n 个参数填进来"。_1 就是 newcallable 的第一个参数,_2 是第二个,以此类推。这些 _1、_2 都在 placeholders 命名空间里,嫌每次写 std::placeholders::_1 麻烦,就先 using 一下。
using placeholders::_1;
using placeholders::_2;
using placeholders::_3;
int sub1(int a, int b)
{
    return (a - b) * 10;
}
int sub2(int a, int b, int c)
{
    return (a - b - c) * 10;
}
class plus
{
public:
    static int plusi(int a, int b)
    {
        return a + b;
    }
    double plusd(double a, double b)
    {
        return a + b;
    }
};
int main()
{
    auto sub1 = bind(sub1, _1, _2);
    cout << sub1(10, 5) << endl;
    // bind 本质返回的就是一个仿函数对象
    // 调整参数顺序(说实话不太常用)
    auto sub2 = bind(sub1, _2, _1);
    cout << sub2(10, 5) << endl;
    // 调整参数个数(这个常用):绑死固定参数
    auto sub3 = bind(sub1, 100, _1);
    cout << sub3(5) << endl;
    auto sub4 = bind(sub1, _1, 100);
    cout << sub4(5) << endl;
    // 分别绑死第1、2、3个参数
    auto sub5 = bind(sub2, 100, _1, _2);
    cout << sub5(5, 1) << endl;
    auto sub6 = bind(sub2, _1, 100, _2);
    cout << sub6(5, 1) << endl;
    auto sub7 = bind(sub2, _1, _2, 100);
    cout << sub7(5, 1) << endl;
    //------
    // 成员函数绑完,就不用每次都传对象了
    function<double(plus&&, double, double)> f6 = &plus::plusd;
    plus pd;
    cout << f6(move(pd), 1.1, 1.1) << endl;
    cout << f6(plus(), 1.1, 1.1) << endl;
    // bind 最常用的场景:绑死固定参数
    function<double(double, double)> f7 = bind(&plus::plusd, plus(), _1, _2);
    cout << f7(1.1, 1.1) << endl;
    //------
    return 0;
}
为了防止有人和我在学习初期一样对占位符产生理解困难,下面有一个简易图,展示占位符作用:
八、补充:c++11 其他几个微小知识点
最后再补几个 c++11 里零散但有用的小改动。
8.1 默认移动构造和移动赋值
原来 c++ 类里有 6 个默认成员函数:构造函数、析构函数、拷贝构造、拷贝赋值重载、取地址重载、const 取地址重载。前 4 个重要,后两个用处不大。所谓"默认成员函数"就是不写,编译器自动生成一个。
c++11 新增了两个默认成员函数:移动构造函数和移动赋值运算符重载,一共变成 8 个。
编译器什么时候会自动生成?
- 自动生成移动构造:自己没写移动构造,而且析构函数、拷贝构造、拷贝赋值重载、移动赋值重载一个都没写,编译器才会自动生成。默认生成的移动构造,对内置类型成员做按字节逐成员拷贝;对自定义类型成员,看这个成员有没有实现移动构造——有就调移动构造,没有就退而调拷贝构造。
- 自动生成移动赋值:同理,自己没写移动赋值,而且析构、拷贝构造、拷贝赋值、移动构造一个都没写,编译器才自动生成。规则跟移动构造完全类似。
- 写了移动构造或移动赋值:编译器会把拷贝构造和拷贝赋值重载隐式标记为
=delete,也就是说拷贝操作直接就不可用了。
8.2 stl 新接口
stl 容器在 c++11 里加了不少新接口,比如 unordered_map、unordered_set,还有 emplace 系列、initializer_list 版本的构造函数等,这些前面都讲过了。
8.3 成员变量声明时给缺省值
c++11 之前,类里的成员变量不能在声明时给默认值。c++11 开始可以了:
class a {
    int _a = 10;   // c++11 才允许
};
这个缺省值是给初始化列表用的——如果在构造函数的初始化列表里没显式初始化它,编译器就用这个声明时给的值隐式初始化。
8.4 =default 和 =delete
c++11 能更好地控制默认函数。
=default:假设想要某个默认函数,但因为一些原因编译器没自动生成。比如写了拷贝构造,编译器就不生成移动构造了,这时可以用=default显式让编译器生成。=delete:想限制某些默认函数,c++98 的做法是把它声明成 private 而且只声明不实现,想调就报错。c++11 更简单,直接在声明后面加=delete,告诉编译器别生成这个函数的默认版本。被=delete修饰的函数叫删除函数。
8.5 final 和 override
final 和 override 这两个关键字前面也讲过:final 是保证类不被继承或虚函数不被重写,override 是检查派生类重写虚函数有没有写对。
本篇总结
- lambda 表达式:本质就是个匿名函数对象,写法
[捕捉列表](参数)->返回值{函数体};底层是编译器自动生成的匿名类,重载了operator()。 - 捕捉列表:显式(
[a, &b])、隐式([=]或[&])、混合([=, &a]或[&, a])三种;全局变量和静态变量不用抓;值抓进来默认是 const,加 mutable 能解除;同一个变量只能抓一次。 - lambda 应用:排序、线程、智能指针删除器这些场景,比专门写个仿函数类轻多了。
- std::function:统一类型的包装器,函数指针、仿函数、lambda、成员函数都能装;装成员函数时要多传一个对象参数。
- std::bind:函数适配器,能绑死固定参数(调参数个数)、也能换参数顺序;占位符
_1、_2表示将来新可调用对象的第几个参数。 - 补充知识点:c++11 默认成员函数从 6 个变 8 个(加移动构造、移动赋值);
=default显式要默认函数、=delete禁止默认函数;成员变量声明时可给缺省值;final/override控制继承和重写。
到此这篇关于c++11 lambda 表达式与 function、bind全解的文章就介绍到这了,更多相关c++11 lambda 表达式内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!

发表评论