
 我要评论
一篇写给有 c++ 基础的初学者的学习博客,围绕 chatsdk 的会话管理模块,讲清「内存缓存 + 数据库持久化」「线程安全」「智能指针选型」这几个关键点。
这个模块要解决什么问题
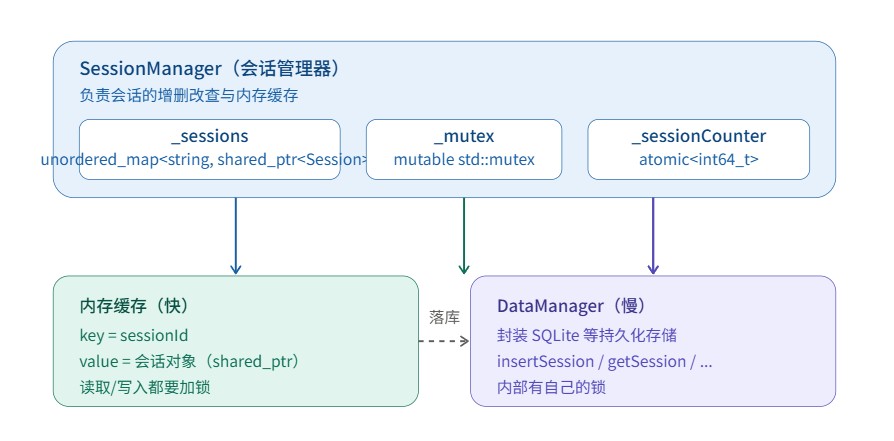
在一个聊天 sdk 里,用户会和 ai 进行多轮对话,每一轮对话是一个「会话(session)」,会话里又有多条「消息(message)」。sessionmanager 就是负责管理这些会话的组件:
- 创建会话、删除会话、清空会话;
- 往会话里追加消息、读取某个会话的历史消息;
- 维护会话列表(按最近更新时间排序);
- 把会话数据从内存落到数据库,必要时从数据库读回内存。
一句话概括:它是「调用方」和「数据库」之间的一层内存缓存 + 业务编排。调用方只跟 sessionmanager 打交道,不用关心数据到底存在内存还是硬盘。
一个具体的使用场景
假设用户打开 app,跟 ai 开始一段新的对话:
- 输入:app 调用
createsession("gpt-4o"),传入要用的模型名。 - 处理:
sessionmanager生成一个唯一的sessionid,在内存的_sessions哈希表里登记这个会话,然后把它写进数据库。 - 继续对话:用户每发一条消息,app 调用
addmessage(sessionid, message),消息被追加到会话里,同时落库。 - 输出:用户想翻看历史,app 调用
gethistroymessages(sessionid),先从内存拿,拿不到再从数据库读。
整个过程里,sessionmanager 始终扮演「调度中枢」的角色,而对数据库的读写被隔离在 datamanager 里。
一、为什么用shared_ptr而不是直接存session
这是注释里花了大篇幅解释的一个点,也是理解整个模块设计意图的关键。成员声明是这样的:
// 管理所有会话信息,key: 会话id,value: 会话信息
std::unordered_map<std::string, std::shared_ptr<session>> _sessions;
注释给出的理由是:session 是「大对象 + 需要被多方共享 + 生命周期跨调用」的实体,直接存值会导致性能、内存峰值、锁持有时间和内存碎片全面恶化,用 shared_ptr 能把操作降为指针级 o(1),并天然支持共享所有权和自动释放。
这里需要注意两点,注释没有完全说透:
第一,「避免大对象拷贝」是次要收益,核心是「稳定的对象身份」。 如果 _sessions 直接存 session 值,那么 getsession 要么返回一个拷贝(改了内存里那份、外部拿到的还是旧值),要么返回裸指针/引用(_sessions 一旦 rehash 或 erase,指针就失效)。用 shared_ptr 后,外部拿到的是同一个对象的共享所有权,哪怕这个会话后来从 _sessions 里被移除了,持有者手里的 shared_ptr 依然有效、对象不会提前析构。这是"生命周期跨调用"的真正含义。
第二,「o(1)」这个说法要打个折扣。 插入、查找、移动时只拷贝一个指针(8 字节),而不是整个 session(含 _messages 向量),这确实是 o(1) 的指针拷贝。但「省内存」的前提是多个指针指向同一份对象;如果每个会话只被 _sessions 自己引用,用 shared_ptr 并不会比存值更省内存,反而多了一次堆分配和引用计数的开销。所以准确的说法是:它在"允许共享"的前提下,避免了重复拷贝,而不是无条件省内存。
补充示例:想象一个聊天界面在渲染某个会话的标题,同时后台线程在往这个会话追加消息。如果存的是值,界面和后台各有一份副本,永远对不齐;存
shared_ptr后两者指向同一份,追加的消息立刻能被界面看到。
二、std::mutex与临界区:为什么"遍历"也要加锁
成员里有一个 mutable std::mutex _mutex;,注释的解释是:mutable 表示在 const 成员函数里也能被修改。
这个解释本身没错,但更准确的说法是:mutable 允许在 const 成员函数中修改这个成员。锁本身就是用来"改状态"的(加锁/解锁会改变锁的内部状态),所以它天然需要 mutable,否则 getsessioncount() const、gethistroymessages(...) const 这些 const 函数就没法加锁了。
注释里那句关于"哈希表是线程共享的同一块物理内存,只要涉及读取(遍历、查找)或修改(插入、删除、扩容)就必须加锁"非常关键,这里展开讲:
- 修改(插入、删除)会导致
unordered_map内部可能发生 rehash(重新分配桶、移动节点)。如果别的线程此刻正在遍历,它的迭代器就会失效,最严重时直接 core dump。这是注释强调的"后果 1"。 - 读取(
find、遍历)看似无害,但如果和写入同时发生,读到的可能是半成品状态——比如节点正在被移动,链表的next指针被改到一半。所以读也要加锁,只要它和写可能并发。
这也解释了为什么 getsessioncount() 这么简单的一个 return _sessions.size(); 也要包一层 lock_guard:
size_t sessionmanager::getsessioncount()const{
    std::lock_guard<std::mutex> lock(_mutex);  // 读也要加锁
    return _sessions.size();
}
补充:
std::lock_guard是 raii 风格的锁,构造时加锁、析构时解锁,函数提前 return 或抛异常都不会漏解锁,比手写lock()/unlock()更安全。但这个模块里大量代码用的是手写_mutex.lock()/_mutex.unlock(),两者都能用,只是lock_guard更不容易出错。
三、std::atomic与计数:为什么普通int的++不够
成员里还有一个计数器:
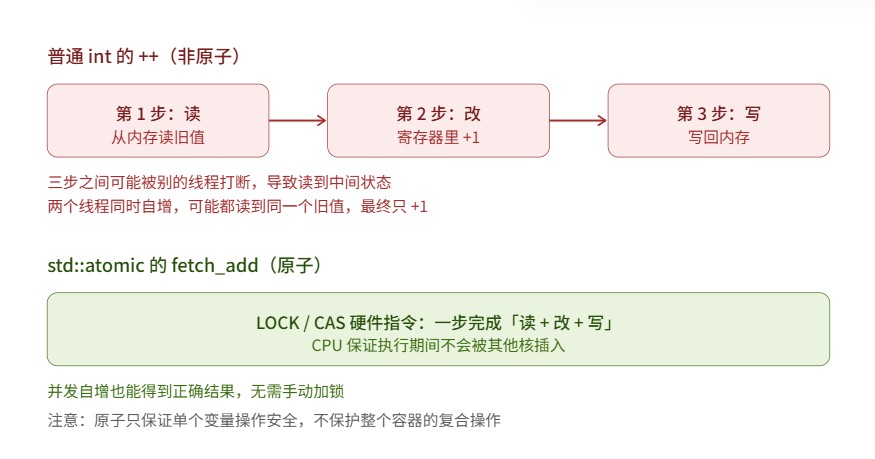
// 普通int ++ 在语义上是读-改-写三步,编译成多条独立指令,cpu 执行时可被中断、
// 可被其他核插入、可受缓存和乱序影响——所以普通int不是原子的,因此要定义成 atomic。
std::atomic<int64_t> _sessioncounter = {0}; // 记录所有会话总数注释把原理讲得很到位。这里再补充一个用锁还是用原子的判断标准:
_mutex保护的是"一段代码"(临界区)——比如"先 find 再 push_back"这种由多个操作组成的复合逻辑,必须整体加锁,原子类型帮不上忙。_sessioncounter保护的是"一个变量的一次操作"——fetch_add(1)是单次读改写,用原子类型就够了,比加锁更轻量(不需要进入内核、不引入锁竞争)。
在 generatesessionid 里:
std::string sessionmanager::generatesessionid(){
    _sessioncounter.fetch_add(1);          // 原子自增
    std::time_t time = std::time(nullptr);
    std::ostringstream os;
    os<<"session_"<<time<<"_"<<std::setw(8)<<std::setfill('0')<<_sessioncounter;
    return os.str();
}
fetch_add(1) 返回的是旧值,先自增再读取。std::setw(8) << std::setfill('0') 把计数格式化成 8 位、左边补 0 的数字,配合时间戳,得到一个形如 session_1731571200_00000001 的唯一 id。
这里需要注意:"唯一"依赖的是 _sessioncounter 单调递增。它只在构造时归 0、只增不减(删除会话不递减),所以只要进程不重启,就能保证 id 不重复;但进程重启后 _sessioncounter 会重新从 0 开始,如果时间戳恰好在同一秒,理论上可能撞出重复 id。这是"内存计数器 + 时间戳"这种生成方式的固有局限,当前代码没有处理重启场景,需不需要处理取决于业务。
补充示例:两个线程同时调用
generatesessionid。如果_sessioncounter是普通int64_t,两个线程可能都读到旧值 n,各自 +1 后都得到 n+1,两个会话 id 就撞了。用atomic后,fetch_add保证第一个拿到 n、第二个拿到 n+1,永不重复。
四、加锁/解锁的时机,以及"锁套锁"的坑
createsession 是整个模块里锁时序最值得琢磨的一段:
std::string sessionmanager::createsession(const std::string& modelname){
    _mutex.lock();
    std::string sessionid = generatesessionid();
    auto session = std::make_shared<session>(modelname);
    session->_sessionid = sessionid;
    session->_createdat = std::time(nullptr);
    session->_updatedat = session->_createdat;
    _sessions[sessionid] = session;
    // 在insertsession之前解锁的主要原因是insertsession里面也有锁!!!
    _mutex.unlock();
    // 将会话保存到数据库
    _datamanager.insertsession(*session);
    return sessionid;
}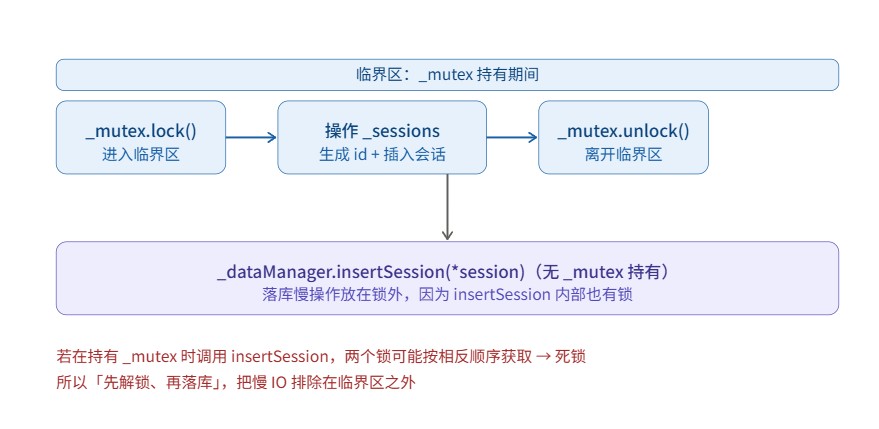
注意那句醒目的注释:在调用 insertsession 之前解锁,是因为 insertsession 里面也有锁。
这是并发编程里非常经典的一条原则:不要在持有一把锁的时候,去调用一个可能会获取另一把锁的函数。如果两个锁在别的地方以相反顺序获取,就会形成死锁——线程 a 持有锁 1 等锁 2,线程 b 持有锁 2 等锁 1,双方永远等下去。
即便没有死锁风险,把慢的数据库 io(落库)放在临界区里,也会让其他线程在 _mutex 上排队等待,拖垮整个系统的吞吐。所以这里的设计是:锁只保护内存哈希表这一小块临界区,落库放到锁外。
但这里也埋着两个隐患,值得你留意:
- "先解锁再落库"意味着内存和数据库之间有一个短暂的不一致窗口。 如果
insertsession落库失败,内存里已经有一个会话、数据库里却没有。当前代码没有处理落库失败的返回值(insertsession是否返回状态也未知),出现不一致时调用方无从感知。 - 手写
lock()/unlock()在异常路径下会漏解锁。 如果_sessions[sessionid] = session;这行因为内存分配失败抛异常,unlock()不会执行,锁就永远卡死了。用lock_guard就没有这个问题。
这两个都是"设计上的取舍/改进点",不是代码里已经写明的行为,我把它标记为推测与建议。
五、内存与数据库的双层查找:getsession
getsession 展示了这个模块最典型的"双层查找"模式:
std::shared_ptr<session> sessionmanager::getsession(const std::string& sessionid){
    _mutex.lock();
    auto it = _sessions.find(sessionid);
    if(it != _sessions.end()){
        _mutex.unlock();
        it->second->_messages = _datamanager.getsessionmessages(sessionid);  // 刷新历史消息
        return it->second;
    }
    _mutex.unlock();
    // 内存没有,从数据库查
    auto session = _datamanager.getsession(sessionid);
    if(session){
        _mutex.lock();
        auto it = _sessions.find(sessionid);
        if(it == _sessions.end()){
            _sessions[sessionid] = session;   // 回填内存,下次就不用再查库了
        }
        _mutex.unlock();
        session->_messages = _datamanager.getsessionmessages(sessionid);
        return session;
    }
    warn("sessionid = {} not found", sessionid);
    return nullptr;
}
几个值得注意的细节:
- "命中内存"分支里也重新查了一次消息。
it->second->_messages = _datamanager.getsessionmessages(sessionid);是为了保证返回的历史消息是最新的(可能别的实例刚往数据库写过)。这说明_messages字段是"可被数据库覆盖"的,并非纯内存独享。 - 第二次加锁前又
find了一次。 因为解锁之后、回填之前,可能有别的线程已经把同一个会话插进了_sessions。如果不二次检查就_sessions[sessionid] = session,会用operator[]覆盖掉别人刚插的值(好在两个都是同一会话的shared_ptr,影响有限,但"二次检查"这个习惯是对的)。 warn来自util/mylog.h。 这是一个日志宏(非标准 c++),具体实现不在本次代码里,我只知道它被用来打一条警告日志,不推测它的行为。
六、addmessage与消息 id 的生成
bool sessionmanager::addmessage(const std::string& sessionid, const message& message){
    _mutex.lock();
    auto it = _sessions.find(sessionid);
    if(it == _sessions.end()){
        _mutex.unlock();
        return false;                 // 会话不存在,直接失败
    }
    message msg(message._role, message._content);
    msg._messageid = generatemessageid(it->second->_messages.size());
    msg._timestamp = std::time(nullptr);
    info("message info: content {}  timestamap {}", msg._content, msg._timestamp);
    it->second->_messages.push_back(msg);
    it->second->_updatedat = std::time(nullptr);
    info("add message success, sessionid = {}, message.content = {}", sessionid, msg._content);
    _mutex.unlock();
    _datamanager.insertmessage(sessionid, msg);
    return true;
}
这里同样遵循"锁内改内存、锁外落库"的模式。两个值得展开的点:
第一,消息 id 的序号是"当前消息总数"。 generatemessageid(it->second->_messages.size()) 传入的是当前 _messages 的大小(还没 push 这条新消息),函数内部再 messagecounter++,所以新消息的序号等于 size + 1。这是"用当前数量当序号"的做法,简单但在删除消息后序号可能重复。函数形参名叫 messagecounter、注释叫"消息计数",容易让人以为是全局递增计数器,实际上它只是一个局部序号,这点建议在阅读时留意。
第二,message msg(message._role, message._content); 是拷贝构造。 外部传入的 message 被拷贝了一份,再补上 _messageid 和 _timestamp 两个字段。这意味着 message 的这两个字段不是由调用方填的,而是由 sessionmanager 统一分配——id 和时间戳的生成权被收口到这里,调用方只需要给角色和内容。
七、getsessionlists:排序与锁的作用范围
std::vector<std::string> sessionmanager::getsessionlists()const{
    auto sessions = _datamanager.getallsessions();   // 先查库(未持锁)
    std::lock_guard<std::mutex> lock(_mutex);
    std::vector<std::pair<std::time_t, std::shared_ptr<session>>> temp;
    temp.reserve(_sessions.size());
    for(const auto& pair : _sessions){               // 遍历内存(持锁)
        temp.emplace_back(pair.second->_updatedat, pair.second);
    }
    for(const auto& session : sessions){             // 合并库里多出来的
        if(_sessions.find(session->_sessionid) == _sessions.end()){
            temp.emplace_back(session->_updatedat, session);
        }
    }
    std::sort(temp.begin(), temp.end(), [](const auto& a, const auto& b){
        return a.first > b.first;                    // 按更新时间降序
    });
    std::vector<std::string> sessionids;
    sessionids.reserve(_sessions.size());
    for(const auto& pair : temp){
        sessionids.push_back(pair.second->_sessionid);
    }
    return sessionids;
}
这里的要点是排序用了一个"临时数组"而不是直接排 _sessions:因为 unordered_map 本身是无序的,要得到"按更新时间降序"的列表,只能把 (时间戳, 会话) 收集到一个临时 vector 里,用 std::sort 配合自定义比较器排序。lambda 里 return a.first > b.first; 就是"时间戳大的(更新的)排在前面"。
注意锁的作用范围:_datamanager.getallsessions() 在加锁之前执行,也就是说查库这一步并不受 _mutex 保护;lock_guard 只覆盖了遍历 _sessions 和后续排序、提取 id 的部分。这与"查库可能很慢、要放到锁外"的指导思想一致。
另外一个小细节:第二个循环里 if(_sessions.find(...) == _sessions.end()) 用来去重——把"数据库里有、但内存里没有"的会话补进来,避免漏掉那些还没被加载到内存的会话。
八、删除与清空:先内存、后数据库
bool sessionmanager::deletesession(const std::string& sessionid){
    _mutex.lock();
    auto it = _sessions.find(sessionid);
    if(it == _sessions.end()){
        _mutex.unlock();
        return false;
    }
    _sessions.erase(it);          // 从内存删除
    _mutex.unlock();
    _datamanager.deletesession(sessionid);   // 从数据库删除
    return true;
}删除的顺序永远是先内存、后数据库——和创建、添加消息时"先内存、后落库"保持一致。clearallsessions 同理,_sessions.clear() 清内存,再 _datamanager.clearallsessions() 清库。
这里没有太多新知识点,但它呼应了贯穿全文的那条主线:内存是"快照 + 工作集",数据库是"持久化的真身",sessionmanager 负责让两者尽量同步。
小结
回顾这个模块,最值得记住的是三条设计主线:
- 双层结构:内存哈希表
_sessions当缓存、datamanager当持久层,读写优先走内存、落库放锁外。 - 线程安全的两类工具:
std::mutex保护"一段复合操作"(临界区),std::atomic保护"单个变量的单次操作",二者各司其职。 - 共享所有权:
shared_ptr让会话对象可以被多方持有、跨调用存活,代价是对象身份和生命周期要自己心里有数。
理解了这三条,再去看 createsession、getsession、addmessage 这些函数的实现,就会发现它们其实都是同一套模式的变体。
自测问题
getsessioncount()明明只有一行return _sessions.size();,为什么还要用lock_guard加锁?如果去掉锁,在什么场景下会出问题?_sessioncounter用std::atomic<int64_t>,而_sessions用std::mutex保护。请说明:为什么不能反过来,用原子类型保护_sessions、用互斥锁保护计数器?createsession里为什么在调用_datamanager.insertsession之前先_mutex.unlock()?如果改成"持锁落库",会带来哪两类问题(提示:一类和死锁有关,一类和性能有关)?getsession里"内存没找到"的分支,在二次加锁后又find了一次才决定是否插入。这一行if(it == _sessions.end())去掉会有什么风险?- 进程重启后,
_sessioncounter会从 0 重新开始,为什么"时间戳 + 计数"生成的 sessionid 在极端情况下仍可能重复?如果要彻底避免,你会怎么改(可从"改用 uuid"或"计数持久化"两个方向思考)?
到此这篇关于c++ chatsdk sessionmanager 模块详解的文章就介绍到这了,更多相关c++ chatsdk sessionmanager 模块内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!

发表评论