
 我要评论
excel 本质上是二进制封装的专有格式,直接丢进两个不同系统之间做数据交换时,常常会水土不服。而 xml 是一种纯文本、结构清晰、与平台无关的数据描述语言,任何编程语言都能解析,也天然适合做系统对接、数据归档和版本管理。把 excel 工作簿导出成 xml,相当于把"表格里的内容"翻译成一种机器与人都能读懂的通用语言。本文介绍如何用 spire.xls for python,用一行核心代码完成 excel 到 xml 的转换,并进一步演示如何只把其中的某一张工作表单独导出为 xml。
为什么需要把 excel 转换为 xml
在以下场景中,保留二进制 .xlsx 不如换成 xml 来得顺手:
- 跨系统数据交换:很多老牌业务系统、web 服务只接受 xml 作为入参,把导出的 excel 转成 xml 后就能直接对接。
- 版本控制与差异比对:xml 是纯文本,放进 git 之类的版本库里可以逐行 diff,而二进制 excel 每次改动都是"整文件替换",难以追溯具体改了哪几个单元格。
- 数据清洗与校验:用脚本读取 xml 比解析 excel 更轻量,不需要 excel 运行时,适合在服务端批量处理。
- 长期归档:纯文本格式受软件版本影响更小,多年后即使 office 大改版,xml 依然能被任意工具打开。
与手动"另存为 xml 电子表格"相比,用代码转换的优势是可批量、可自动化、可嵌进更大的数据处理流水线。
环境准备
本文使用 spire.xls for python 完成 excel 到 xml 的转换。它把导出逻辑封装在 workbook 的 savetofile 方法里,只要指定目标格式为 fileformat.xml 即可在保存时自动完成转换。先通过 pip 安装:
安装完成后,在脚本中导入所需模块即可开始:
from spire.xls import *
from spire.xls.common import *
fileformat 等枚举来自 spire.xls.common,后续转换时直接引用即可。
将 excel 转换为 xml
spire.xls 把"导出为 xml 电子表格"这件事做得极简:加载工作簿后,只需在 savetofile 的第二个参数传入 fileformat.xml,引擎就会把整个工作簿(所有工作表、单元格值与格式)写进一个扁平的 xml 文件。下面加载一份 .xlsx 并直接导出为 .xml:
from spire.xls import *
from spire.xls.common import *

inputfile = "/销售汇总.xlsx"
outputfile = "/excel转xml.xml"

# 创建 workbook 对象
workbook = workbook()
# 从磁盘加载 excel 文档
workbook.loadfromfile(inputfile)
# 以 xml 格式保存,完成 excel 到 xml 的转换
workbook.savetofile(outputfile, fileformat.xml)
workbook.dispose()
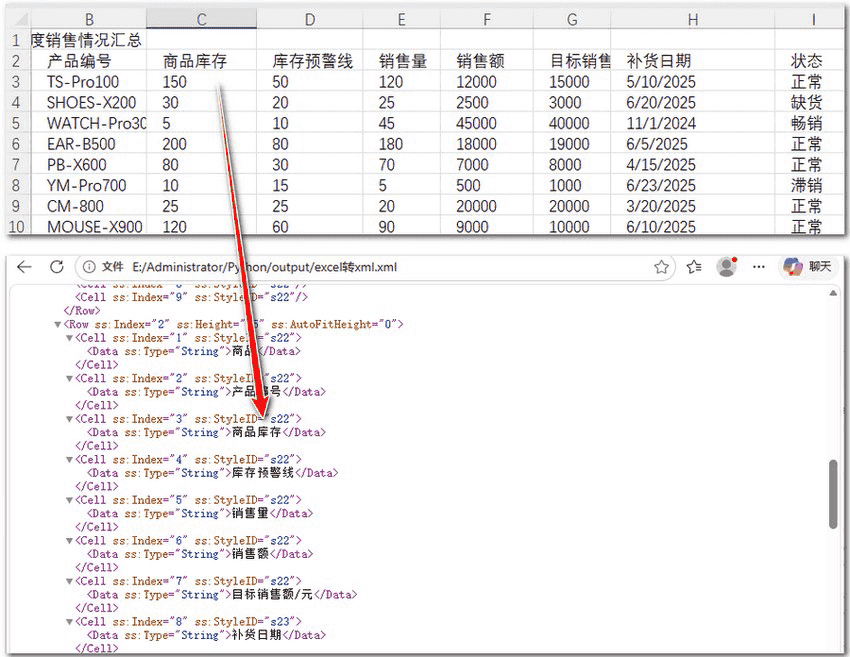
这段代码先 loadfromfile 载入 excel,再调用 savetofile 并传入 fileformat.xml——转换过程中,spire.xls 会生成符合"xml 电子表格 2003"规范的文档,把每个工作表、行、单元格都映射成对应的 xml 节点。它导出的不是只含数据的简单列表,而是尽量保留工作簿结构的完整描述:工作表顺序、行列位置、单元格的值与基本类型都会被写进对应的 <worksheet>、<table>、<cell> 等标签里。得到的 .xml 文件用记事本就能打开,结构清晰可读,这也正是它适合做数据交换与版本管理的原因。
转换单个工作表为 xml
整份工作簿一起转成 xml 适合"全量导出"的场景,但很多时候我们只关心其中的某一张表——比如一份汇总簿里只有"销售明细"那个分表需要对外交换,其余的配置表、模板表并不想一并暴露出去。对这种情况,更干净的做法是先把目标工作表单独抽出来,再把它导出为 xml。
下面的代码先加载源工作簿,接着新建一个空白工作簿并清空默认带出的那张空表,然后用 addcopy 把源簿里指定的那一张表完整地复制进来,最后以 fileformat.xml 保存。这样生成的 xml 里就只含有你挑选的那张表,结构依旧是标准的 xml 电子表格,但内容范围被精确控制住了:
from spire.xls import *
from spire.xls.common import *

inputfile = "/世界各洲人口前十国家.xlsx"
outputfile = "/worksheet转xml.xml"

# 创建源工作簿并加载
srcworkbook = workbook()
srcworkbook.loadfromfile(inputfile)

# 创建用于导出的新工作簿,并清空默认自带的工作表
newworkbook = workbook()
newworkbook.worksheets.clear()

# 把源工作簿中第 1 张工作表整体复制到新工作簿
newworkbook.worksheets.addcopy(srcworkbook.worksheets[0], worksheetcopytype.copyall)
# 以 xml 格式保存,仅包含所挑选的那张工作表
newworkbook.savetofile(outputfile, fileformat.xml)

srcworkbook.dispose()
newworkbook.dispose()
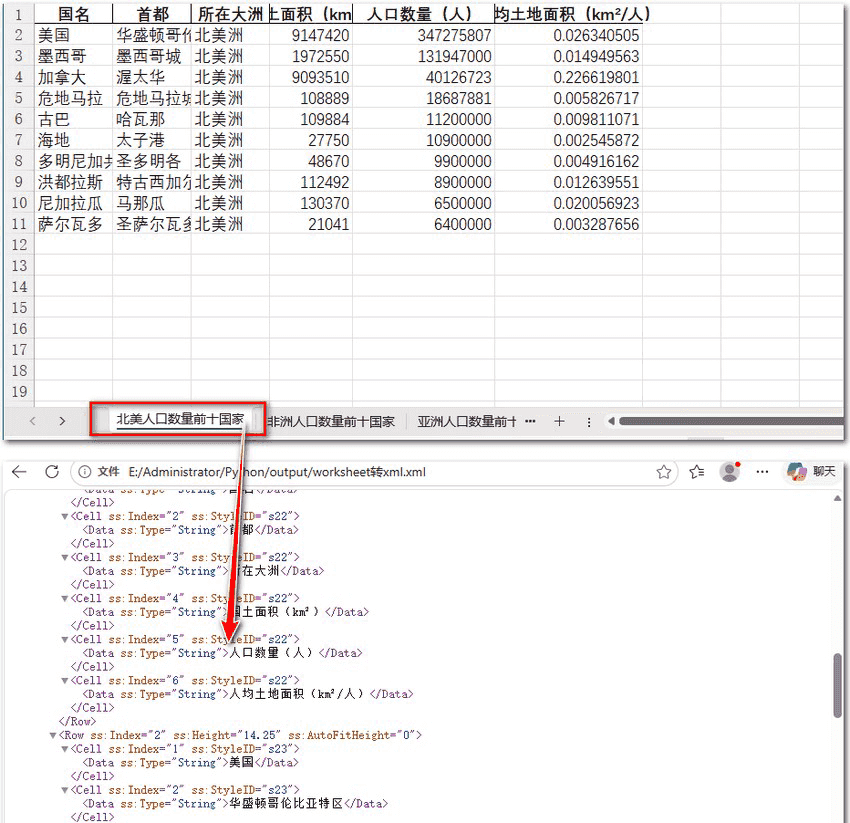
这里的关键是 worksheets.clear() 和 addcopy 的配合。新 workbook 在创建时会自带一张空白工作表,如果不先 clear(),导出的 xml 里就会混入这张没用的空表;addcopy(..., worksheetcopytype.copyall) 则保证把源表的数据、公式、格式一并带过来,而不是只复制一个空壳。需要导出第几张表,只要把 worksheets[0] 里的索引换掉即可——worksheets[1] 就是第 2 张,以此类推。
相比整簿导出再手工删表,这种先获取指定工作表再导出的方式在程序里一次完成,既不会把无关工作表泄露出去,也省去了后续再处理 xml 内容的麻烦,特别适合做数据脱敏、按表分发或对外提供单一数据集的场景。
xml、csv 与 json:导出时怎么选
把 excel 数据"弄出来"给别人或别的系统用,常见有三种落点,理解它们的差异能帮你选对格式:
- csv:最轻量,一行一条记录、逗号分隔,人人都能读、几乎任何工具都能解析。但它不带类型、不带多工作表概念,遇到含逗号的字段还要转义,表达力最弱。
- json:层次化、自带类型,特别适合 web api 与编程语言之间的数据传递,但对"二维表格"的映射不如 xml 直观。
- xml(本文方案):结构严谨、可描述多工作表与单元格层级,企业级系统和历史遗留平台兼容性最好。代价是文件比 csv 臃肿,人工直接阅读不如 csv 轻松。
简单说:只想让人或脚本快速拿到一张表,用 csv;要喂给现代 web 服务,用 json;要对接传统企业系统、或需要保留工作簿层级结构并做版本追踪,用本文的 xml 导出最稳妥。
综合示例:批量将文件夹下的 excel 转为 xml
把基础转换放进循环,就能一次性把某个目录里的所有 excel 批量导出为 xml。下面遍历指定文件夹,对每一个 .xlsx 文件调用 savetofile(..., fileformat.xml),并沿用统一的命名规则输出到结果目录:
import os
from spire.xls import *
from spire.xls.common import *

excel_dir = "excels/"
output_dir = "output/"

# 确保输出目录存在
if not os.path.exists(output_dir):
    os.makedirs(output_dir)

# 逐个转换目录下的 excel 文件
for file_name in os.listdir(excel_dir):
    if not file_name.lower().endswith((".xlsx", ".xls")):
        continue

    input_path = os.path.join(excel_dir, file_name)
    output_path = os.path.join(output_dir, file_name.rsplit(".", 1)[0] + ".xml")

    workbook = workbook()
    workbook.loadfromfile(input_path)
    workbook.savetofile(output_path, fileformat.xml)
    workbook.dispose()
    print(f"已转换:{file_name} -> {os.path.basename(output_path)}")

print("全部转换完成。")
这段脚本的关键点同样是"用完即关":每次循环结束都调用 dispose(),这样即使处理成百上千份文件,内存也始终处于可控范围。如果只想批量导出每份工作簿里的某一张表,只需在循环里改用"新建工作簿 → clear() → addcopy 指定工作表 → 保存 xml"的写法即可,整体结构保持不变。
实用技巧
- 分清两种"xml":本文导出的是"xml 电子表格(xml spreadsheet)"——一个扁平的 .xml 文本文件;而日常看到的 .xlsx 文件本身其实也是一个 zip 包,里面装的是一组 office open xml 文件。两者都是 xml 技术家族,但形态不同,别把
fileformat.xml的产出误当成 .xlsx。 - 纯文本便于 diff:把导出的 xml 提交到版本库,能清楚看到"哪一行、哪个单元格的值变了",这是二进制 excel 做不到的。
- 大文件注意资源:单元格很多的工作簿导出 xml 后文本量可观,建议分批处理并在每份
dispose()后稍作间隔,避免单次内存占用过大。 - 按需导出单张表:只对外交换某一类数据时,优先用"新建工作簿 →
clear()→addcopy指定工作表"的方式只导出目标表,避免把无关工作表或敏感配置一并暴露出去。 - 编码优先 utf-8:xml 默认以 utf-8 承载中文等字符,跨系统传递时一般无需额外处理;若对方系统对编码有特例要求,再针对性调整。
总结
本文介绍了如何使用 python 和 spire.xls 将 excel 转换为 xml,核心内容如下:
- 使用
workbook.savetofile(outputfile, fileformat.xml)一行代码把 excel 工作簿整体导出为 xml 电子表格文件 - 使用"新建工作簿 →
worksheets.clear()→addcopy指定工作表 →savetofile(..., fileformat.xml)"的方式,只把其中某一张工作表单独导出为 xml - 将基础转换放进循环即可实现文件夹内 excel 的批量导出,并保持
dispose()"用完即关"以控制内存 - 理解"xml 电子表格"与".xlsx(office open xml 包)"的区别,避免格式误用
掌握这些方法后,你就能在"人用的 excel"和"机器交换用的 xml"之间自由切换——无论是把整份工作簿归档,还是只抽取其中一张表对外分发,都能用几行代码自动完成。实际项目中,建议先用单份文件验证导出的 xml 结构,再结合批量脚本一次性处理全量数据;涉及对外交换时,优先用单表导出的方式缩小数据范围、降低无关信息泄露的风险。
以上就是python快速实现excel转xml的示例代码的详细内容,更多关于python excel转xml的资料请关注代码网其它相关文章!




发表评论