
 我要评论
副标题:一次把 if key in d、try/except、dict.get、dict.setdefault、defaultdict、__missing__、counter 讲透,全部行为与性能数据均为真机实测。
0. 写在前面:本文的数字都是跑出来的
技术文章里最容易出错的就是"性能对比"那一栏——凭印象写出来的"某某写法更快"往往是错的。所以本文的每一条行为描述和每一个性能数字,都来自在本机真实运行的解释器。
实测环境(由脚本自动记录):
| 项目 | 值 |
|---|---|
| python 版本 | cpython 3.11.9 (main, apr 15 2024, 17:28:11) |
| 编译器 | clang 17.0.6 |
| 平台 | macos-26.5.2-arm64-arm-64bit |
| benchmark 规模 | 每次 200,000 次操作,重复 3 次取最优 |
实测脚本保留在中间产物目录中(文末附路径),你可以自己复跑验证。
1. 起点:一个会崩的 greeting 函数
一切从下面这段代码开始:
name_for_userid = {
    382: "alice",
    590: "bob",
    951: "dilbert",
}


def greeting(userid):
    return "hi %s!" % name_for_userid[userid]
它在你传入一个存在的 id 时工作得很好:
>>> greeting(382)
'hi alice!'
但只要 id 不存在,[] 索引就会直接抛异常。实测:
>>> greeting(3333)
traceback (most recent call last):
  ...
keyerror: 3333
实测到的异常细节:类型为 keyerror,repr(e) 是 keyerror(3333),str(e) 是 '3333'(注意 str() 出来的是裸值,不带引号的 3333,这是 keyerror.__str__ 的一个小特性——它返回 repr 的参数字符串)。
greeting 这个函数是本文的引子:“字典里没有这个键时,我希望拿到一个合理的默认值,而不是让程序崩掉。” 下面有七条路线,从最朴素到最专业,我们把它们挨个走完。
2. 路线一:if key in d判断(lbyl)
最直白的写法,先查再取:
if userid in name_for_userid:
    name = name_for_userid[userid]
else:
    name = "there"

print("hi %s!" % name)
改写 greeting:
def greeting_if_in(userid):
    if userid in name_for_userid:
        name = name_for_userid[userid]
    else:
        name = "there"
    return "hi %s!" % name
实测结果:
| 输入 | 返回 |
|---|---|
greeting_if_in(382) | 'hi alice!' |
greeting_if_in(3333) | 'hi there!' |
特点
- 优点:一目了然,零依赖,且不会修改字典(实测调用后
"zzz" in d仍为false)。 - 缺点:命中时要做两次哈希查找(一次
in,一次取下标),代码也更长。 - 适用:判断本身有额外意义时(例如"不存在就报错/记日志/走另一条分支"),而不只是"要个默认值"。
3. 路线二:try/except keyerror(eafp)
python 社区推崇的"请求原谅比请求许可更容易"(eafp)风格:
def greeting_try(userid):
    try:
        return "hi %s!" % name_for_userid[userid]
    except keyerror:
        return "hi there!"
实测:
| 输入 | 返回 |
|---|---|
greeting_try(382) | 'hi alice!' |
greeting_try(3333) | 'hi there!' |
特点
- 优点:键存在时是最快的写法(异常机制在不抛出异常时几乎没有额外开销,见第 9 节:命中时 14.0 ns/次,全场第一)。
- 缺点:键缺失时最慢(抛异常需要构造 traceback,实测 90.9 ns/次,约是
if in的 5.4 倍)。 - 适用:缺失是罕见情况、命中是常态的热点代码。
这条路线是本文七条路线里唯一"性能强依赖数据分布"的,务必要结合业务判断。
4. 路线三:dict.get(key, default)
这是大多数场景下的默认答案:
def greeting_get(userid):
    return "hi %s!" % name_for_userid.get(userid, "there")
实测:
| 输入 | 返回 |
|---|---|
greeting_get(382) | 'hi alice!' |
greeting_get(3333) | 'hi there!' |
dict.get 的三个关键性质:
- 只读:无论命中与否都不修改字典;
- 一次查找:命中时的耗时与"命中场景"基本一致(实测 19.4 ns/次),比
if in更省; - 默认值可省略:
d.get(k)等价于d.get(k, none)。
4.1 坑一:default参数是一个"总是求值"的普通表达式
这是 get 最容易被忽略的地方。default 不是"惰性求值",它只是函数调用的普通实参,无论键是否存在都会被求值。
实测:把一个带副作用的函数当默认值,调用 5 次 d.get(404, expensive_default()):
calls = 0
def expensive_default():
    global calls
    calls += 1
    return "guest"

d = {}
for _ in range(5):
    d.get(404, expensive_default())

print(calls)      # 实测 = 5
print(d)          # 实测 = {}   (字典没有被写入)
实测结论:函数被调用了 5 次(全部 5 次调用都构造了默认值),而字典 d 始终是 {}(get 不会写入)。
setdefault 有同样的问题,实测在一共 5 次调用中,默认值函数也被调用了 5 次,即使键 "exist" 一直存在、值根本没被用上。
4.2 坑一的量化后果:默认值越"重",浪费越大
同样 20 万次循环,只把默认值从整数换成列表字面量:
| 写法 | 20 万次总耗时(实测) |
|---|---|
{}.get(k, 0) | 0.0102 s |
{}.get(k, []) | 0.0378 s |
约 3.7 倍。列表字面量 [] 每次都要真的创建一个新对象,即使用不上。
结论:不要往 get / setdefault 的默认值位置放"构造代价大"的表达式(大容器、函数调用、属性访问、datetime.now() 等)。要惰性构造,请用第 6 节的 defaultdict(工厂只在需要时才被调用)或第 7 节的 __missing__。
4.3 坑二:none的歧义
d.get(k) 返回 none 时,你无法区分"键不存在"和"键存在但值为 none"。实测:
d = {"a": none, "b": 1}

d.get("a")     # 实测 -> none
d.get("zzz")   # 实测 -> none
d.get("a") == d.get("zzz")   # 实测 -> true(无法区分!)

"a" in d       # 实测 -> true
"zzz" in d     # 实测 -> false
如果"值为 none"是合法业务状态,必须额外用 in 判断,或者换一个哨兵对象:
_missing = object()
value = d.get(k, _missing)
if value is _missing:
    ...  # 键确实不存在
5. 路线四:dict.setdefault(key, default)
setdefault 的语义比 get 多一步:键不存在时把默认值写进字典,然后返回它;键已存在则直接返回已有值,不覆盖。
实测:
d = {"a": 1}

r1 = d.setdefault("a", 99)   # 实测 -> 1   (不覆盖已有值)
r2 = d.setdefault("b", 99)   # 实测 -> 99  (插入并返回)
print(d)                     # 实测 -> {'a': 1, 'b': 99}
print(len(d))                # 实测 -> 2
有一个容易忽略的行为:键存在但值是 none 时也不会被覆盖。实测:
d = {"a": none}
d.setdefault("a", 5)   # 实测返回 none,字典仍为 {'a': none}
因为 setdefault 判断的是"键是否在字典里",而不是"值是否为假"。
5.1 典型用法:分组(把同键的元素收集到列表)
words = ["apple", "banana", "avocado", "blueberry", "cherry"]

groups = {}
for w in words:
    groups.setdefault(w[0], []).append(w)

print(groups)
# 实测 -> {'a': ['apple', 'avocado'], 'b': ['banana', 'blueberry'], 'c': ['cherry']}
这一行 setdefault(w[0], []).append(w) 之所以能工作,是因为 setdefault 返回的是字典里那个列表对象的引用,而不是副本。所以 .append() 改的是字典里的真身。
5.2 头号坑:get+append会静默丢数据
很多人想当然地写成 get:
d7 = {}
d7.get("x", []).append(1)
d7.get("x", []).append(2)
print(d7)
实测输出是 {} —— 数据全丢了,而且不报任何错。
原因:get 每次返回的都是一个新建的临时列表,append 改完以后,这个临时列表没有任何人再引用它,直接被垃圾回收。字典自始至终没被写过。这个 bug 极其隐蔽,务必记住:要"取不到就创建并写回",用 setdefault 或 defaultdict,绝不能用 get。
5.3 次要坑:默认值每次构造
虽然 setdefault 只在键缺失时才用默认值,但实参表达式仍然每次都会被求值。实测:对一个已存在的键连续调用 1000 次 setdefault(1, trackedlist()),trackedlist.__init__ 被调用了 1000 次(构造了 1000 个随后被丢弃的列表),最终列表长度为 1000(append 都生效了,这部分是对的)。
也就是说 setdefault 的默认值构造开销属于"白扔",同样遵守第 4.2 节的结论。
6. 路线五:collections.defaultdict
defaultdict 用"工厂函数"取代"固定默认值",把"缺失时怎么办"下沉到容器里。
from collections import defaultdict

d = defaultdict(list)
语义:当通过 d[key] 访问一个缺失键时,调用 default_factory() 生成默认值、写入字典、然后返回。
6.1defaultdict(list):分组
groups2 = defaultdict(list)
for w in words:
    groups2[w[0]].append(w)

# 实测 -> {'a': ['apple', 'avocado'], 'b': ['banana', 'blueberry'], 'c': ['cherry']}
比 setdefault 版本少一次方法调用,读起来也更接近"自然语言"。
实测不同键拿到的列表是互相独立的:d["p"] is not d["q"] 为 true,内容各自为 {'p': [1], 'q': [2]}。
6.2defaultdict(int):计数
counter = defaultdict(int)
for ch in "abracadabra":
    counter[ch] += 1

# 实测 -> {'a': 5, 'b': 2, 'c': 1, 'd': 1, 'r': 2}
# 实测 sum(counter.values()) -> 11
int() 返回 0,所以 counter[ch] += 1 在键缺失时能从 0 开始累加,不用先判断。
6.3 三种常见工厂的差异
| 工厂 | 缺失时的默认值 | 典型用途 | 注意点 |
|---|---|---|---|
defaultdict(list) | [] | 分组、邻接表、一对多索引 | 每次缺失键都会新建空列表 |
defaultdict(int) | 0 | 计数、累加、词频 | 布尔语境下 0 为假,需注意 |
defaultdict(lambda: 默认值) | 任意 | 需要非 int/list 的默认值 | 无法 pickle,见 6.7 |
lambda 工厂的实测:同一个键取两次拿到同一个对象(d["x"] is d["x"],实测 true);不同的键拿到不同对象(d["x"] is not d["y"],实测 true)。这正是我们想要的语义——每个键一份独立默认值。
6.4 核心坑:defaultdict的"读取"会写入字典
这是 defaultdict 与 get 最重要的区别,也是最容易踩的坑。仅做一次读取,字典就变大了:
dd = defaultdict(list)
print(len(dd))          # 实测 -> 0

dd["missing_key"]       # 只是"看一眼"
print(len(dd))          # 实测 -> 1
print(dict(dd))         # 实测 -> {'missing_key': []}
后果举例:
- 用
if dd[key] is none之类的判断做"探测",会污染字典; - 遍历
dd[key]统计时,字典长度会莫名增长; - 转成 json 时会多出一堆空值键。
哪些操作会触发工厂? 实测对照(defaultdict(int)):
| 操作 | 是否调用工厂 / 写入字典 | 实测结果 |
|---|---|---|
d[k] | 是 | 缺失键读取后 len 从 0 变 1 |
d.get(k) | 否 | 返回 none,len 保持 0 |
k in d | 否 | 返回 false,len 保持 0 |
d.setdefault(k, v) | 否(走的是 dict 的实现) | 使用传入的 v,不调工厂 |
也就是说:只有下标访问 d[k] 才会触发工厂。需要"探测但不污染"时,用 in 或 get。
6.5defaultdict(none)等价于普通dict
如果没有传工厂(或传 none),缺失键依旧抛 keyerror:
nd = defaultdict(none)
nd["x"]
# 实测 -> keyerror: 'x'
6.6defaultdict的边界:default_factory必须可调用且"缺席不报错"
工厂是普通可调用对象,因此以下都可以:内置类型(list/int/set/str)、命名函数、类、lambda。
一个常见错误是写成 defaultdict(0) 或 defaultdict([]),会得到 typeerror: first argument must be callable or none。正确写法是 defaultdict(int)、defaultdict(list)。
6.7 重要坑:lambda工厂无法被 pickle
实测(把 defaultdict(lambda: 0) 做 pickle.dumps):
attributeerror: can't pickle local object '<lambda>.<locals>.<lambda>'
对照实测:
| 工厂 | pickle.dumps 结果 |
|---|---|
int | 成功,round-trip 后 default_factory 仍是 int |
list | 成功,round-trip 后 default_factory 仍是 list |
| 模块级命名函数 | 成功,round-trip 后仍是该函数 |
| 自定义类 | 成功,round-trip 后仍是该类 |
lambda | 失败,attributeerror |
原因很好理解:pickle 保存函数/类时是"按名字引用",而 lambda 是匿名对象,没有可稳定引用的名字。
所以:只要 defaultdict 需要跨进程传输、写缓存文件、丢给多进程(multiprocessing、concurrent.futures 的默认 pickle 协议),就不要用 lambda 工厂——换成命名函数或自定义类:
def make_default():
    return {"n": 0}

d = defaultdict(make_default)   # 实测可 pickle
6.8 拷贝与转换:工厂的去留
实测结论:
| 操作 | default_factory 是否保留 |
|---|---|
copy.copy(d) | 保留(实测 true) |
copy.deepcopy(d) | 保留(实测 true),且内部元素是独立深拷贝 |
pickle 往返 | 保留(int/list 等可 pickle 的工厂,实测 true) |
dict(d) | 丢失(实测返回的是普通 dict,没有 default_factory 属性) |
顺带实测:copy.copy 出来的副本依然会自动创建键(shallow["new_key"] 之后该键存在)。
6.9 何时该把defaultdict转回普通dict
几乎所有"要交给外部"的场合:json.dumps、日志打印、返回给调用方。实测 json.dumps(defaultdict(list, {"a": [1]})) 输出 {"a": [1]},这一步本身能工作;但更推荐显式 dict(d),一是语义清晰,二是避免"调用方拿到一个还会自动长键的容器"。
7. 路线六:__missing__自定义子类
dict.__getitem__ 在找不到键时,如果子类定义了 __missing__,就会调用它,而不是直接抛 keyerror。这给了你完全的控制权:写入或不写入、返回什么,全由你决定。
7.1 关键性质:__missing__只在d[key]时触发
实测三种实现都验证了同一点:
class defaultingdict(dict):
    def __missing__(self, key):
        return f"<没有 {key} 这个键>"


md = defaultingdict({"a": 1})
before = dict(md)

md["zzz"]                 # 实测 -> '<没有 zzz 这个键>'
print(dict(md) == before) # 实测 -> true   (字典没有被污染)
print("zzz" in md)        # 实测 -> false

md.get("zzz", "get_fallback")        # 实测 -> 'get_fallback'(没走 __missing__)
md.setdefault("zzz2", "sd_fallback") # 实测 -> 'sd_fallback'(没走 __missing__)
md.setdefault("zzz3")                # 实测 -> none(没走 __missing__)
print(sorted(k for k in md if k != "a"))  # 实测 -> ['zzz2', 'zzz3']
结论:get 和 setdefault 不会触发 __missing__(setdefault 只把它自己传的默认值写进去)。__missing__ 是 [] 专用通道。
7.2 三种实用实现
a. 只读默认(不写回字典)
class defaultingdict(dict):
    def __missing__(self, key):
        return f"<没有 {key} 这个键>"
适合"探测式访问":想拿个占位值,但不想污染原字典(实测 dict 保持不变)。
b. 自动建容器(等价 defaultdict(list),但行为可见可控)
class autolistdict(dict):
    def __missing__(self, key):
        value = []
        self[key] = value
        return value


ad = autolistdict()
ad["x"].append(1)
# 实测 -> {'x': [1]}
比 defaultdict(lambda: []) 更好的一点:可 pickle(它是模块级类),且以后加日志、加统计都很方便。
c. 大小写不敏感字典(经典用例)
class caseinsensitivedict(dict):
    def __missing__(self, key):
        if isinstance(key, str):
            return self[key.upper()]
        raise keyerror(key)

    def __setitem__(self, key, value):
        if isinstance(key, str):
            key = key.upper()
        super().__setitem__(key, value)


ci = caseinsensitivedict()
ci["name"] = "alice"
# 实测 ci["name"] -> 'alice'
# 实测 ci["name"] -> 'alice'
# 实测 ci.keys() -> ['name']
7.3__missing__与defaultdict怎么选
| 维度 | defaultdict | __missing__ 子类 |
|---|---|---|
| 默认值来源 | 单一工厂,所有键相同 | 可以按键逐个计算 |
| 是否写入字典 | 固定写入 | 由你决定 |
| 代码量 | 一行 | 一个类 |
| 可读性 | 高(约定俗成) | 需要读类定义 |
| 附加能力 | 无 | 可加日志、统计、类型校验、缓存 |
一句话:"所有缺失键用同一种默认值"用 defaultdict;"缺失时的行为需要定制"用 __missing__。
8. 路线七:collections.counter
counter 是 dict 的子类(实测 isinstance(counter(), dict) 为 true),专为计数而生。它最有趣的地方是它的"缺失键"行为和 defaultdict(int) 不一样。
8.1 与defaultdict(int)的关键差异:读缺失键不写入
实测:
from collections import counter

c = counter("abracadabra")
print(len(c))          # 实测 -> 5
v = c["not_present"]   # 实测 -> 0
print(len(c))          # 实测 -> 5   (没有变!)

c.get("also_absent")   # 实测 -> none (注意:不是 0)
"yet_another_absent" in c   # 实测 -> false
print(len(c))          # 实测 -> 5
对照 defaultdict(int)(第 6.4 节):d["missing"] 会让 len 从 0 变 1。counter 的 __missing__ 直接返回 0 而不写入,所以它不会被探查式读取污染。 这是 counter 相对 defaultdict(int) 的一个实实在在的优势。
同时注意:counter 的 c[key] 返回 0,但 c.get(key) 返回 none——因为它继承的是 dict.get,没有覆盖。
8.2 常用方法(全部实测)
c = counter("abracadabra")

c.most_common(3)   # 实测 -> [('a', 5), ('b', 2), ('r', 2)]
c.most_common()    # 全部,按计数降序
c.total()          # 实测 -> 11  (python 3.10+,等价于 sum(c.values()))
sorted(c.elements())  # 实测 -> ['a','a','a','a','a','b','b','c','d','r','r']
计数器的加减法(实测):
counter("abc") + counter("abd")   # 实测 -> {'a': 2, 'b': 2, 'c': 1, 'd': 1}
counter("abd") - counter("abc")   # 实测 -> {'d': 1}   (只保留正数,负数被丢弃)
counter("abracadabra") - counter("abracadabra")   # 实测 -> {}
构造与更新(实测):
counter(["x", "x", "y"])          # 实测 -> {'x': 2, 'y': 1}
counter("abracadabra").update(["a"])   # 原地累加
8.3 何时用counter而不是defaultdict(int)
| 需求 | 推荐 |
|---|---|
单纯计数,最多再看 max() | 两者皆可,counter 更省心 |
| 要看"前 n 名" | counter.most_common(n) |
| 要做计数器的加减、集合运算 | counter |
要按计数 sorted() / 迭代 | counter |
想在缺失键读取时污染字典(例如为了后续 d.keys() 完整) | defaultdict(int) |
想要 .get() 返回 0 而不是 none | 两者都不行,counter.get 是 dict.get;需要自己封装 |
9. 性能实测全景
9.1 方法 论(先说清楚,免得误读)
- 规模:每种写法循环 200,000 次;重复 3 轮,取最优一轮(
best of 3),单位换算为 ns/次。 - 命中场景:键全部存在;缺失场景:键全部不存在,且每次的键都不相同(避免缓存与重复键带来的偏差)。
- 所有数字为实测,环境见第 0 节。
9.2 命中(键存在)
| 写法 | ns/次(实测) | 200,000 次总耗时 |
|---|---|---|
try/except keyerror | 14.0 | 0.0028 s |
dict.get | 19.4 | 0.0039 s |
dict.setdefault | 21.4 | 0.0043 s |
defaultdict 索引 | 22.1 | 0.0044 s |
if in + 索引 | 23.0 | 0.0046 s |
条件表达式 d[k] if k in d else v | 25.3 | 0.0051 s |
9.3 缺失(键不存在)
| 写法 | ns/次(实测) | 200,000 次总耗时 |
|---|---|---|
if in 判断(未命中不索引) | 16.9 | 0.0034 s |
dict.get | 21.4 | 0.0043 s |
| 条件表达式 | 25.0 | 0.0050 s |
dict.setdefault(会插入) | 38.9 | 0.0078 s |
defaultdict 索引(会插入 + 调工厂) | 81.6 | 0.0163 s |
try/except keyerror(抛异常) | 90.9 | 0.0182 s |
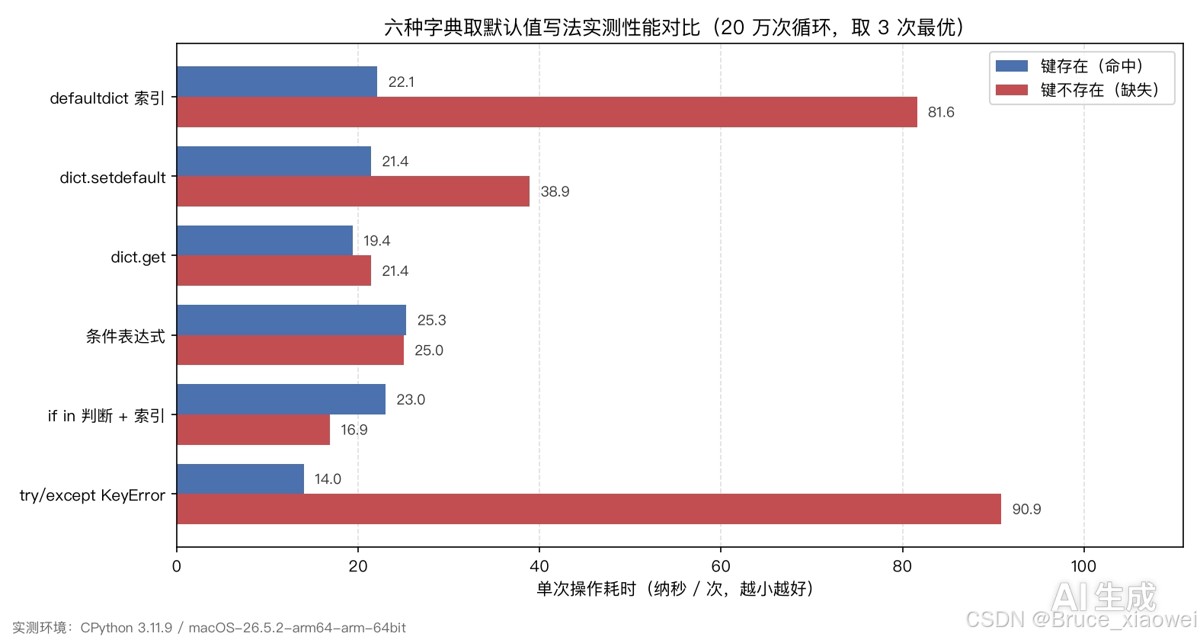
图:本文实测数据绘制的性能对比(20 万次循环,取 3 次最优)。
怎么读这两张表:
try/except是"两头极致":命中时 14.0 ns/次全场最快,缺失时 90.9 ns/次全场最慢(约 5.4 倍差距)。它只适合"缺失极罕见"的热点路径。dict.get是最稳的:命中 19.4、缺失 21.4,几乎不受数据分布影响,这也是它成为默认推荐的原因。if in是"缺失时最快":16.9 ns/次;但命中时要哈希两次(23.0),不如get。- 会写入的写法天然更慢:
setdefault缺失 38.9、defaultdict缺失 81.6,因为多了"调工厂 + 插入"的固定成本。这是功能代价,不是缺陷。 - 别把纳秒级差异当成选型依据:除非这段代码真的在每秒百万次的循环里(例如解析器、日志管道内层),否则
get与if in那 2~4 ns 的差距完全不该影响可读性决策。
9.4 分组场景(20 万条记录,1000 个桶)
| 写法 | 总耗时(实测) | 结果 |
|---|---|---|
defaultdict(list) | 0.0093 s | 正确 |
try/except | 0.0095 s | 正确 |
if k not in d: d[k] = [] | 0.0118 s | 正确 |
dict.setdefault | 0.0130 s | 正确 |
d.get(k, []).append(v)(错误示范) | 0.0143 s | 结果为空 {} |
两个值得注意的点:
- 分组场景里
try/except表现很好(0.0095 s),因为 1000 个桶只在首次缺失时抛异常(约 1000 次),其余都是命中路径——这就是 9.3 节"异常成本取决于数据分布"的又一例证。 - 错误示范
get(k, []).append(v)不仅更慢(0.0143 s),而且数据全丢(实测结果len == 0)。速度和正确性双输,务必拉黑。
9.5 默认值构造的代价
| 写法 | 200,000 次总耗时(实测) | 倍数 |
|---|---|---|
{}.get(k, 0) | 0.0102 s | 1.0x |
{}.get(k, []) | 0.0378 s | 3.7x |
结论重申:默认值表达式每次都会求值,重对象请交给 defaultdict 的工厂(惰性)或 __missing__(可控)。
10. 选型对比表(核心结论)
| 场景 | 推荐方案 | 理由 | 实测依据 |
|---|---|---|---|
| 简单取个默认值,读为主 | dict.get(k, default) | 最稳,命中/缺失开销几乎一样 | 19.4 / 21.4 ns |
| 缺失极罕见的高频路径 | try/except keyerror | 命中时最快 | 命中 14.0 ns |
| 缺失常见、只看一眼 | if k in d 或 get | 缺失时 if in 最快 | 缺失 16.9 ns |
| 要"取不到就创建并写回" | setdefault 或 defaultdict | get 会丢数据 | get 结果 {} |
| 一对多分组(列表/集合) | defaultdict(list) / defaultdict(set) | 最简洁,分组场景最快 | 0.0093 s / 20 万条 |
| 计数、词频 | counter 或 defaultdict(int) | counter 读缺失键不污染字典 | counter 读后 len 不变 |
| 需要"前 n 名"、计数器运算 | counter | most_common / + / - | 见 8.2 |
| 缺失值需要按键定制 | __missing__ 子类 | 工厂单一,无法按键变化 | 见 7.2 |
| 缺失时不能污染字典 | __missing__(不写回) | defaultdict 必然写入 | 见 6.4 / 7.1 |
| 结果要跨进程/落盘/跨语言 | 普通 dict + get 或 __missing__ 子类 | defaultdict(lambda) 无法 pickle | attributeerror |
| 默认值构造代价大 | defaultdict(工厂) | 工厂惰性、只在缺失时调用 | 3.7x 差距 |
11. 坑位速查表
| # | 坑 | 后果 | 正确做法 |
|---|---|---|---|
| 1 | d.get(k, heavy()) 以为会惰性求值 | 每次调用都构造默认值,白费 | 用 defaultdict(工厂) |
| 2 | d.get(k, []).append(v) | 静默丢数据(实测结果 {}) | setdefault 或 defaultdict(list) |
| 3 | d.get(k) 无法区分"缺失"与"值为 none" | 逻辑判断错误 | 哨兵对象 + in |
| 4 | defaultdict 用 d[k] 做"探测" | 字典被污染,长度莫名增长 | 用 k in d 或 d.get(k) |
| 5 | defaultdict(0) / defaultdict([]) | typeerror: first argument must be callable or none | defaultdict(int) / defaultdict(list) |
| 6 | defaultdict(lambda: ...) 拿去 pickle | attributeerror: can't pickle local object | 换成命名函数或类 |
| 7 | dict(defaultdict_instance) 后继续按缺失键访问 | 失去自动创建能力 | 明确这是最终转换,之后按普通 dict 用 |
| 8 | 以为 setdefault 会覆盖已有的 none 值 | 实际不覆盖(判断的是键是否存在) | 需要覆盖就直接赋值 |
| 9 | 用 counter.get(k) 拿计数 | 返回 none 而非 0 | 用 c[k](返回 0 且不写入) |
| 10 | 把纳秒级性能差当作选型首要依据 | 牺牲可读性换 2~4 ns | 先正确、再可读、最后才谈性能 |
12. 附:实测环境与脚本
- 解释器:cpython 3.11.9(clang 17.0.6),平台
macos-26.5.2-arm64-arm-64bit。 - 实测脚本(保留于中间产物目录):
dict_defaults_bench.py—— 行为验证 + 性能 benchmark(主脚本)dict_defaults_bench2.py—— 补齐 pickle / 工厂身份 /counter.total()dict_defaults_bench3_pickle.py——default_factory的 pickle 行为专项make_blog_figure.py—— 性能对比配图
- 原始实测数据:
dict_defaults_results.json
本文所有"实测"字样后的数字与输出,均可在上述脚本中复现。
以上就是python字典默认值从keyerror到defaultdict的完全指南的详细内容,更多关于python字典默认值keyerror到defaultdict的资料请关注代码网其它相关文章!




发表评论