
 我要评论
mysql 复制(replication)是官方提供的主从复制(源到副本的复制)方案,用于将一个 mysql 的实例同步到另一个实例中。 这是使用最广泛的容灾方案。
一、复制(replication)
1. 什么是复制
mysql replication是官方提供的主从同步方案,也是用的最广的同步方案。replication(复制)使来自一个 mysql数据库服务器(称为源(source))的数据能够复制到一个或多个 mysql 服务器(称为副本(replica))。默认情况下,复制是异步的;副本不需要永久连接即可从源接收更新。根据配置,你可以复制所有数据库、指定数据库,甚至某个数据库中的指定表。
说明: 旧版本的 mysql 复制将源(source)称为主(master),将副本(replica)称为从(slave)
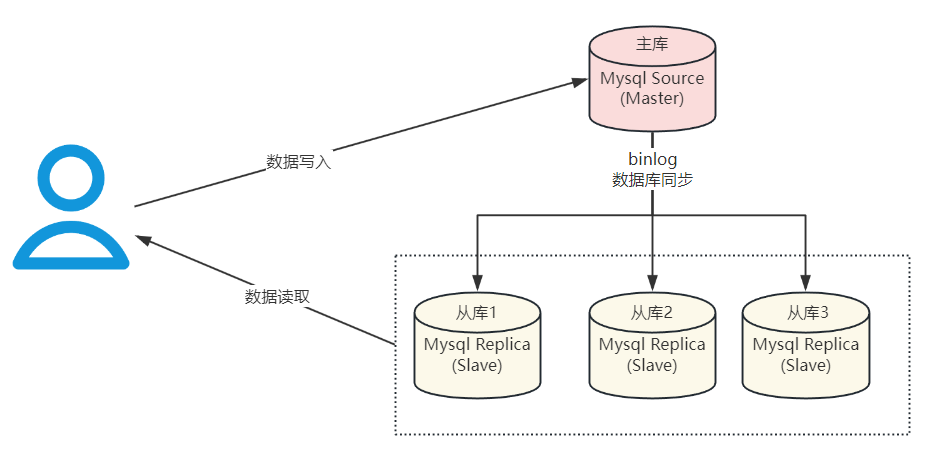
复制的优势:
高可用:通过配置一定的复制机制,mysql 实现了跨主机的数据复制,从而获得一定的高可用能力,如果需要获得更高的可用性,只需要配置多个副本,或者进行级联复制就可以达到目的。
性能扩展:由于复制机制提供了多个数据备份,可以通过配置一个或多个副本,将读请求分发至副本节点,从而获得整体上读写性能的提升。
异地灾备:只需要将副本节点部署到异地机房,就可以轻松获得一定的异地灾备能力。实际当中,需要考虑网络延迟等可能影响整体表现的因素。
交易分离:通过配置复制机制,并将低频、大运算量的交易发送至副本节点执行,就可以避免这些交易与高频交易竞争运算资源,从而避免整体的性能问题。
缺点:
没有故障自动转移,容易造成单点故障
主库从库之间有主从复制延迟问题,容易造成最终数据的不一致
从库过多对主库的负载以及网络带宽都会带来很大的负担
应用场景:
电子商务平台: 在电商平台中,主从复制可以用于实现读写分离,提高并发处理能力,同时确保数据的一致性。
社交网络: 在社交网络应用中,可以利用主从复制来提供快速的读取服务,同时将数据变更复制到从数据库以备份数据。
实时监控和报警系统: 在监控系统中,主从复制可以用于实现数据的分布式存储和快速数据查询。
新闻和媒体网站: 在高访问量的新闻网站中,可以使用主从复制来提供高可用性和快速的内容访问。
金融服务: 在金融行业,数据的安全性和可用性至关重要,主从复制可以用于数据备份和高可用性的实现。
2. 复制的方式
mysql 8.0支持多种复制方式:
传统的方法是基于从源的二进制日志(binlog)复制事件,并要求日志文件及其中的位置在源和副本之间进行同步。作为源(数据库更改发生的地方)的 mysql 实例将更新和更改作为“事件”写入二进制日志。根据所记录的数据库更改,二进制日志中的信息以不同的日志格式存储。副本配置为从源中读取二进制日志,并在副本的本地数据库上执行二进制日志中的事件。
基于全局事务标识符(gtid)的方式。基于 gtid 的复制是完全基于事务的,所以很容易确定源和副本是否一致; 只要在源上提交的所有事务也在副本上提交,就可以保证两者之间的一致性。
#获取binlog文件列表
show binary logs;

#查看指定binlog文件的内容
show binlog events in 'binlog.000003';
3. 复制的数据同步类型
mysql 中的复制支持不同类型的同步。同步的原始类型是单向异步复制,其中一个服务器充当源,而一个或多个其他服务器充当副本。在 mysql 8.0中,除了内置的异步复制之外,还支持半同步复制。使用半同步复制,在返回执行事务的会话之前,对源执行提交,直到至少有一个副本确认它已经接收并记录了事务的事件。mysql 8.0还支持延迟复制,以使副本故意落后于源至少指定的时间。
异步复制
默认情况下,mysql 采用异步复制的方式,执行事务操作的线程不会等复制 binlog 的线程。具体的时序你可以看下面这个图:
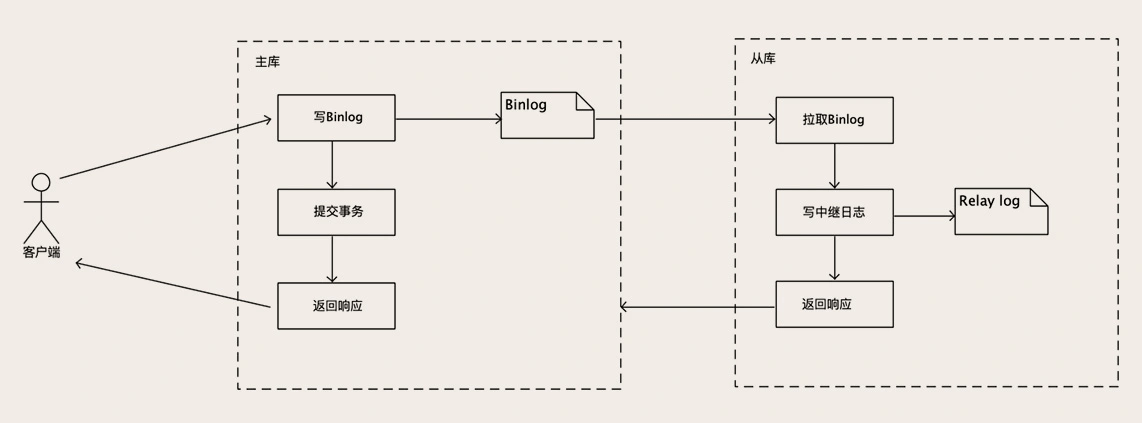
mysql 主库在收到客户端提交事务的请求之后,会先写入 binlog,然后再提交事务,更新存储引擎中的数据,事务提交完成后,给客户端返回操作成功的响应。同时,从库会有一个专门的复制线程,从主库接收 binlog,然后把 binlog 写到一个中继日志里面,再给主库返回复制成功的响应。从库还有另外一个回放 binlog 的线程,去读中继日志,然后回放 binlog 更新存储引擎中的数据。
提交事务和复制这两个流程在不同的线程中执行,互相不会等待,这是异步复制。异步复制的劣势是,可能存在主从延迟,如果主节点宕机,可能会丢数据。
半同步复制
mysql 从 5.7 版本开始,增加一种半同步复制(semisynchronous replication)的方式。这种机制与异步复制相比主要有如下区别:
- 主节点在收到客户端的请求后,必须在完成本节点日志写入的同时,还需要等待至少一个从节点完成数据同步的响应之后(或超时),才会响应请求。
- 从节点只有在写入 relay-log 并完成刷盘之后,才会向主节点响应。
- 当从节点响应超时时,主节点会将同步机制退化为异步复制。在至少一个从节点恢复,并完成数据追赶后,主节点会将异步机制恢复为半同步复制。
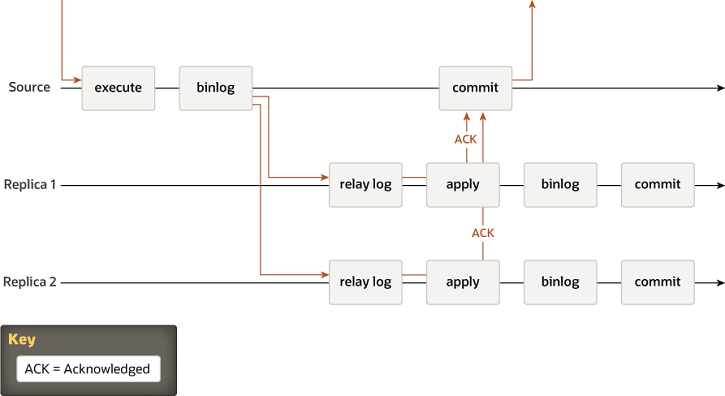
可以看出,相比于异步复制,半同步复制在一定程度上提高了数据的可用性,在未退化至异步复制时,如果主节点宕机,此时数据已复制至至少一台从节点。同时,由于向客户端响应时需要从节点完成响应,相比于异步复制,此时多出了主从节点上网络交互的耗时以及从节点写文件并刷盘的耗时,因此整体上集群对于客户端的响应性能表现必然有所降低。
半同步复制有两个重要的参数:
rpl_semi_sync_master_wait_slave_count(8.0.26之后改为rpl_semi_sync_source_wait_for_replica_count):至少等待数据复制到几个从节点再返回。这个数量配置的越大,丢数据的风险越小,但是集群的性能和可用性就越差。
rpl_semi_sync_master_wait_point(8.0.26之后改为rpl_semi_sync_source_wait_point):这个参数控制主库执行事务的线程,是在提交事务之前(after_sync)等待复制,还是在提交事务之后(after_commit)等待复制。默认是 after_sync,也就是先等待复制,再提交事务,这样就不会丢数据。
设计理念:复制状态机——几乎所有的分布式存储都是这么复制数据的
在 mysql 中,无论是复制还是备份恢复,依赖的都是全量备份和 binlog,全量备份相当于备份那一时刻的一个数据快照,binlog 则记录了每次数据更新的变化,也就是操作日志。这种基于“快照 + 操作日志”的方法,不是 mysql 特有的。比如说,redis cluster 中,它的全量备份称为 snapshot,操作日志叫 backlog,它的主从复制方式几乎和 mysql 是一模一样的。elasticsearch用的是 translog,它备份和恢复数据的原理和实现方式也是完全一样的。
任何一个存储系统,无论它存储的是什么数据,用什么样的数据结构,都可以抽象成一个状态机。存储系统中的数据称为状态(也就是 mysql 中的数据),状态的全量备份称为快照(snapshot),就像给数据拍个照片一样。我们按照顺序记录更新存储系统的每条操作命令,就是操作日志(commit log,也就是 mysql 中的 binlog)。
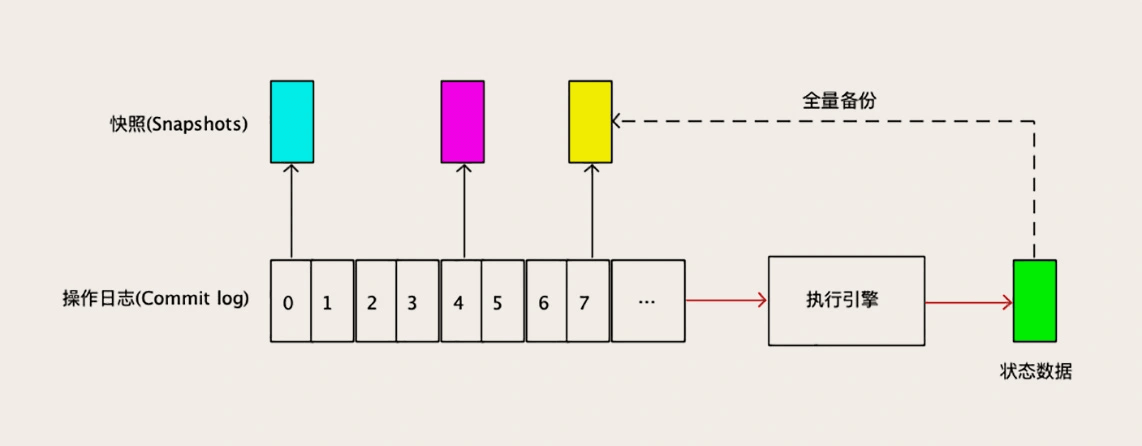
复制数据的时候,只要基于一个快照,按照顺序执行快照之后的所有操作日志,就可以得到一个完全一样的状态。在从节点持续地从主节点上复制操作日志并执行,就可以让从节点上的状态数据和主节点保持同步。
主从同步做数据复制时,一般可以采用几种复制策略。
性能最好的方法是异步复制,主节点上先记录操作日志,再更新状态数据,然后异步把操作日志复制到所有从节点上,并在从节点执行操作日志,得到和主节点相同的状态数据。异步复制的劣势是,可能存在主从延迟,如果主节点宕机,可能会丢数据。
另外一种常用的策略是半同步复制,主节点等待操作日志最少成功复制到 n 个从节点上之后,再更新状态,这种方式在性能、高可用和数据可靠性几个方面都比较平衡,很多分布式存储系统默认采用的都是这种方式。
基于binlog位点同步的主从复制原理
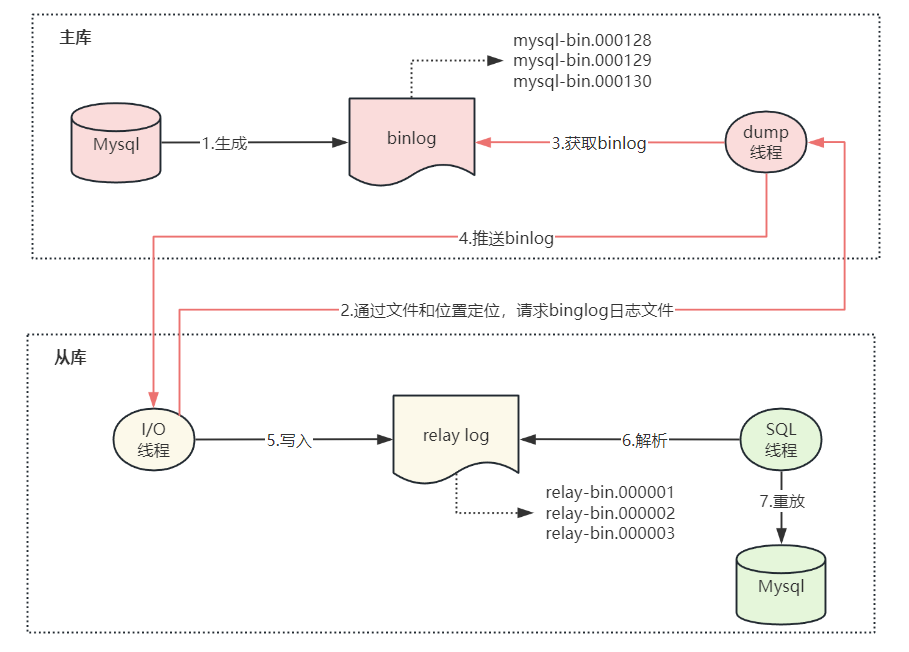
- 主库会生成多个 binlog 日志文件。
- 从库的 i/o 线程请求指定文件和指定位置的 binlog 日志文件(位点)。
- 主库 dump 线程获取指定位点的 binlog 日志。
- 主库按照从库发送给来的位点信息读取 binlog,然后推送 binlog 给从库。
- 从库将得到的 binlog 写到本地的 relay log (中继日志) 文件中。
- 从库的 sql 线程读取和解析 relay log 文件。
- 从库的 sql 线程重放 relay log 中的命令。
4. 异步复制示例
1)快速创建mysql实例
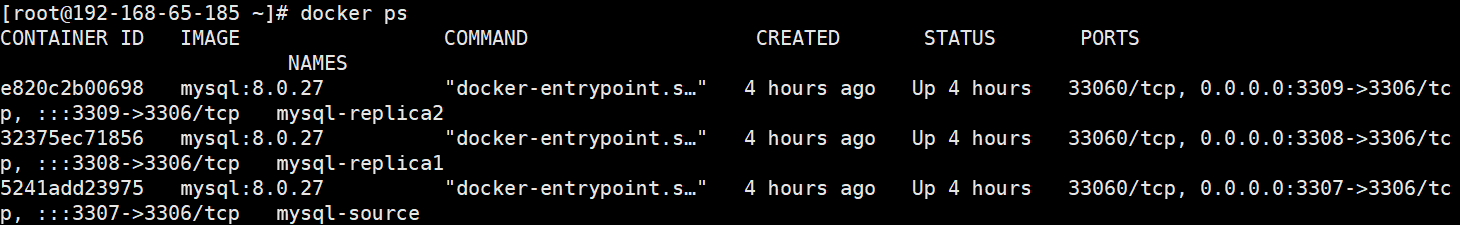
利用docker快速搭建mysql8一主两从复制架构
角色 | server_id | ip:port |
mysql-source (主) | 10 | 192.168.65.185:3307 |
mysql-replica1(从1) | 11 | 192.168.65.185:3308 |
mysql-replica2(从2) | 12 | 192.168.65.185:3309 |
2 ) 配置mysql主从复制
主节点
2.1)创建挂载目录
mkdir -p /mysql/replication/source/data /mysql/replication/source/conf /mysql/replication/source/log
2.2) 准备配置文件
vim /mysql/replication/source/conf/custom.cnf
[mysql]
# 设置mysql客户端默认编码
default-character-set=utf8

[mysqld]
pid-file        = /var/run/mysqld/mysqld.pid
socket          = /var/run/mysqld/mysqld.sock
datadir         = /var/lib/mysql

secure-file-priv= null

# disabling symbolic-links is recommended to prevent assorted security risks
symbolic-links=0

# 服务器唯一id,默认是1
server-id=10

# 启用二进制日志
log-bin=mysql-bin


# 最大连接数
max_connections=1000

# 设置默认时区
default-time_zone='+8:00'

# 0:区分大小写
# 1:不区分大小写
lower_case_table_names=1

!includedir /etc/mysql/conf.d/
pid-file: 这是mysql服务器的进程id文件的位置。通过这个文件,您可以在系统上找到正在运行的mysql服务器的进程。
socket: 这是mysql服务器用于本地通信的unix套接字文件的位置。
datadir: 这是mysql服务器存储其数据文件的位置。
secure-file-priv: 这是一个用于限制load_file()和select ... into outfile命令的文件路径。如果此选项被设置,那么这两个命令只能用于读取在这个路径下的文件。设置为null表示禁用这个功能。
symbolic-links: 如果设置为0,mysql服务器将不允许在数据目录中使用符号链接。这有助于防止安全风险。
server-id: 每个mysql服务器实例在复制时需要有一个唯一的id。这有助于区分不同的服务器,特别是在复制环境中。
log-bin: 启用二进制日志记录所有对数据库的更改,这对于复制和恢复操作是必要的。
max_connections: 这是mysql服务器可以接受的最大并发连接数。
default-time_zone: 这设置了mysql服务器的默认时区。
lower_case_table_names: 这决定了mysql如何存储和比较表名。设置为1意味着表名不区分大小写(但在文件系统中它们仍然会区分大小写)。
!includedir /etc/mysql/conf.d/: 这告诉mysql服务器从/etc/mysql/conf.d/目录中包含其他配置文件。这意味着该目录下的任何.cnf或.ini文件都会被合并到这个主配置文件中。
replicate_do_db : 待同步的数据库日志
replicate_ignore_db:不同步的数据库日志
2.3)运行mysql容器
# 创建主从复制的网络
docker network create --driver bridge mysql-source-replica
#运行mysql容器
docker run  -d  \
--name mysql-source \
--privileged=true \
--restart=always \
--network  mysql-source-replica \
-p 3307:3306 \
-v /mysql/replication/source/data:/var/lib/mysql \
-v /mysql/replication/source/conf:/etc/mysql/conf.d  \
-v /mysql/replication/source/log:/logs \
-e mysql_root_password=123456 \
-e tz=asia/shanghai mysql:8.0.27 \
--lower_case_table_names=1
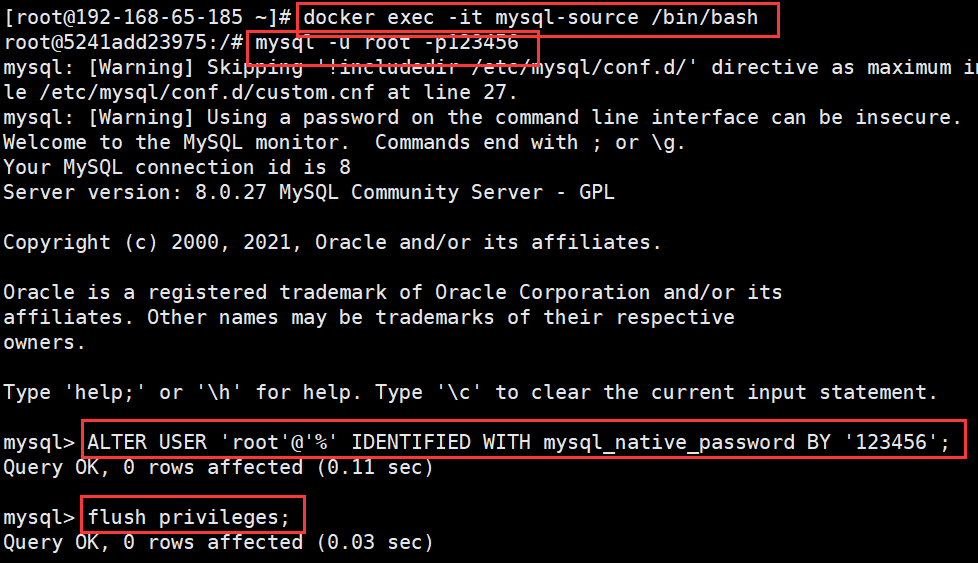
2.4)配置远程访问
docker exec -it mysql-source /bin/bash
mysql -u root -p

alter user 'root'@'%' identified with mysql_native_password by '123456';
flush privileges;
从节点1
# 创建挂载目录
mkdir -p /mysql/replication/replica1/data /mysql/replication/replica1/conf /mysql/replication/replica1/log

#准备配置文件
vim /mysql/replication/replica1/conf/custom.cnf
[mysql]
# 设置mysql客户端默认编码
default-character-set=utf8

[mysqld]
pid-file        = /var/run/mysqld/mysqld.pid
socket          = /var/run/mysqld/mysqld.sock
datadir         = /var/lib/mysql

secure-file-priv= null

# disabling symbolic-links is recommended to prevent assorted security risks
symbolic-links=0

# 服务器唯一id,默认是1
server-id=11

# 启用二进制日志
log-bin=mysql-bin

# 最大连接数
max_connections=1000

# 设置默认时区
default-time_zone='+8:00'

# 0:区分大小写
# 1:不区分大小写
lower_case_table_names=1

!includedir /etc/mysql/conf.d/


#运行mysql容器
docker run  -d  \
--name mysql-replica1 \
--privileged=true \
--restart=always \
--network  mysql-source-replica \
-p 3308:3306 \
-v /mysql/replication/replica1/data:/var/lib/mysql \
-v /mysql/replication/replica1/conf:/etc/mysql/conf.d  \
-v /mysql/replication/replica1/log:/logs \
-e mysql_root_password=123456 \
-e tz=asia/shanghai mysql:8.0.27 \
--lower_case_table_names=1

#配置远程访问
docker exec -it mysql-replica1 /bin/bash
mysql -u root -p

alter user 'root'@'%' identified with mysql_native_password by '123456';
flush privileges;
从节点2
mkdir -p /mysql/replication/replica2/data /mysql/replication/replica2/conf /mysql/replication/replica2/log

#准备配置文件
vim /mysql/replication/replica2/conf/custom.cnf
[mysql]
# 设置mysql客户端默认编码
default-character-set=utf8

[mysqld]
pid-file        = /var/run/mysqld/mysqld.pid
socket          = /var/run/mysqld/mysqld.sock
datadir         = /var/lib/mysql

secure-file-priv= null

# disabling symbolic-links is recommended to prevent assorted security risks
symbolic-links=0

# 服务器唯一id,默认是1
server-id=12

# 启用二进制日志
log-bin=mysql-bin

# 最大连接数
max_connections=1000

# 设置默认时区
default-time_zone='+8:00'

# 0:区分大小写
# 1:不区分大小写
lower_case_table_names=1

!includedir /etc/mysql/conf.d/

#运行mysql容器
docker run  -d  \
--name mysql-replica2 \
--privileged=true \
--restart=always \
--network  mysql-source-replica \
-p 3309:3306 \
-v /mysql/replication/replica2/data:/var/lib/mysql \
-v /mysql/replication/replica2/conf:/etc/mysql/conf.d  \
-v /mysql/replication/replica2/log:/logs \
-e mysql_root_password=123456 \
-e tz=asia/shanghai mysql:8.0.27 \
--lower_case_table_names=1

#配置远程访问
docker exec -it mysql-replica2 /bin/bash
mysql -u root -p

alter user 'root'@'%' identified with mysql_native_password by '123456';
flush privileges;
3)主库配置复制用户
每个副本使用一个 mysql 用户名和密码连接到源,因此在源上必须有一个用户帐户,副本可以使用该帐户进行连接。
# 连接主库mysql-source
create user 'fox'@'%' identified with mysql_native_password by '123456';
grant replication slave on *.* to 'fox'@'%';
flush privileges;
4)查看 master 机器的状态
使用 show master status 语句确定当前二进制日志文件的名称和位置
# 主库上执行
show master status;
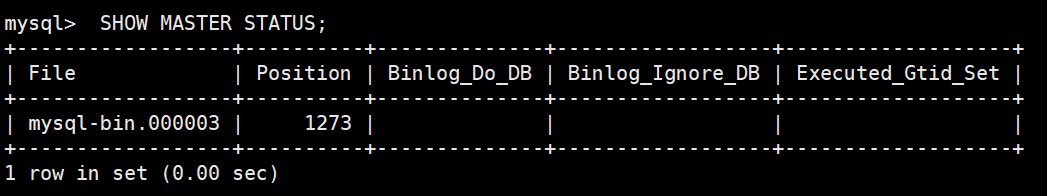
文件”列显示日志文件的名称,“位置”列显示文件内的位置。
5) 从节点设置主库信息
在从库上执行 change replication source to 语句(来自 mysql 8.0.23)或 change master to语句(在 mysql 8.0.23之前)
mysql> change master to
    ->     master_host='source_host_name',
    ->     master_user='replication_user_name',
    ->     master_password='replication_password',
    ->     master_log_file='recorded_log_file_name',
    ->     master_log_pos=recorded_log_position;

or from mysql 8.0.23:
mysql> change replication source to
    ->     source_host='source_host_name',
    ->     source_user='replication_user_name',
    ->     source_password='replication_password',
    ->     source_log_file='recorded_log_file_name',
    ->     source_log_pos=recorded_log_position;
从库1和从库2上执行
# from mysql 8.0.23 执行下面的命令。
change replication source to source_host='192.168.65.185', source_user='fox', source_password='123456', source_port=3307, source_log_file='mysql-bin.000003', source_log_pos=1273, source_connect_retry=30;
source_host:主数据库的ip地址;
source_port:主数据库的运行端口;
source_user:在主数据库创建的用于同步数据的用户账号;
source_password:在主数据库创建的用于同步数据的用户密码;
source_log_file:指定从数据库要复制数据的日志文件,通过查看主数据的状态,获取file参数;
source_log_pos:指定从数据库从哪个位置开始复制数据,通过查看主数据的状态,获取position参数;
source_connect_retry:连接失败重试的时间间隔,单位为秒。

6)开启从库
#开启从库
start slave;  或者  start replica;
#查看从库状态
show slave status \g;  或者 show replica status \g;
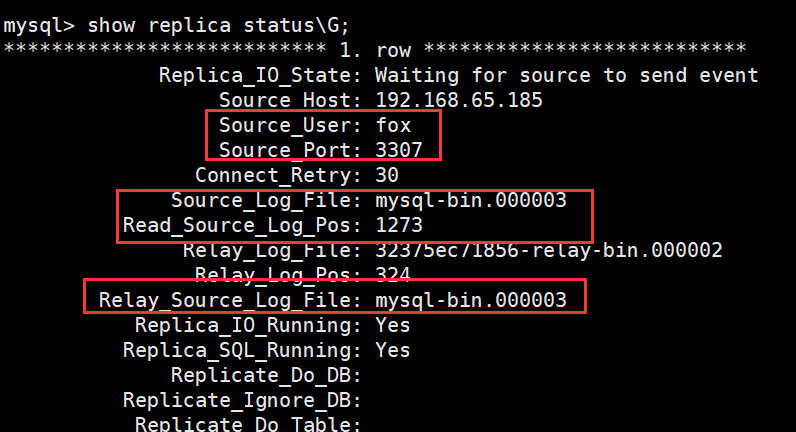
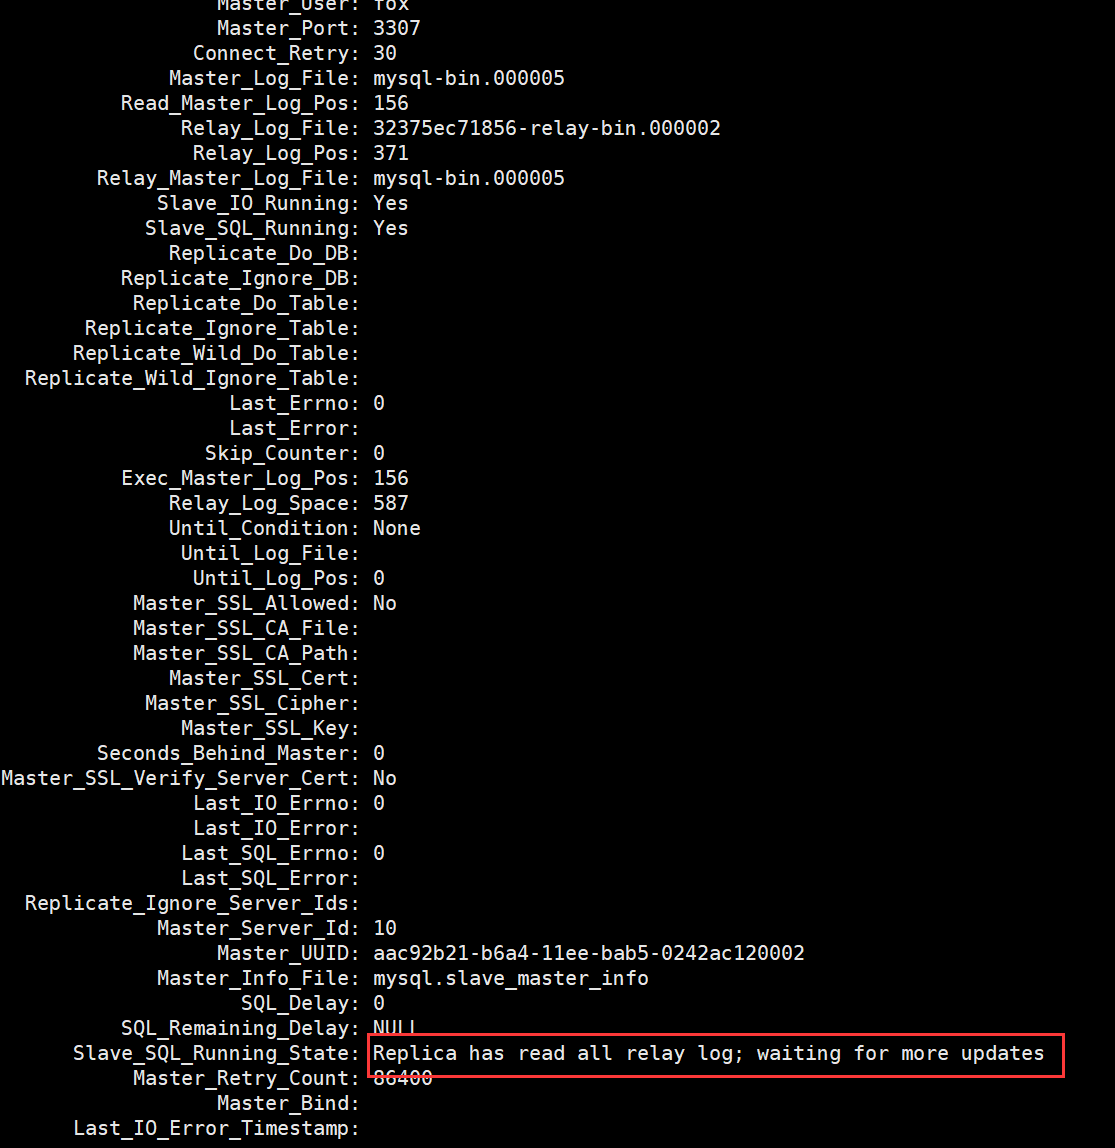
看到replica_sql_running_state: replica has read all relay log; waiting for more updates基本说明配置成功了,已经开始了主从复制。
7)测试主从复制功能
测试脚本
set names utf8mb4;
set foreign_key_checks = 0;

create database if not exists test;
use test;
-- ----------------------------
-- table structure for user
-- ----------------------------
drop table if exists `user`;
create table `user`  (
  `id` int(0) not null auto_increment,
  `name` varchar(50) character set utf8mb4 collate utf8mb4_0900_ai_ci null default null,
  `address` varchar(50) character set utf8mb4 collate utf8mb4_0900_ai_ci null default null,
  `last_updated` bigint(0) null default null,
  `is_deleted` int(0) null default null,
  primary key (`id`) using btree
) engine = innodb auto_increment = 2 character set = utf8mb4 collate = utf8mb4_0900_ai_ci row_format = dynamic;

-- ----------------------------
-- records of user
-- ----------------------------
insert into `user` values (2, '张三', '广州白云山', 1691563465, 0);

set foreign_key_checks = 1;
5. 半同步复制示例
1)安装半同步插件
主节点
#from mysql 8.0.26:
install plugin rpl_semi_sync_source soname 'semisync_source.so';

#验证是否成功安装
select plugin_name, plugin_status
       from information_schema.plugins
       where plugin_name like '%semi%';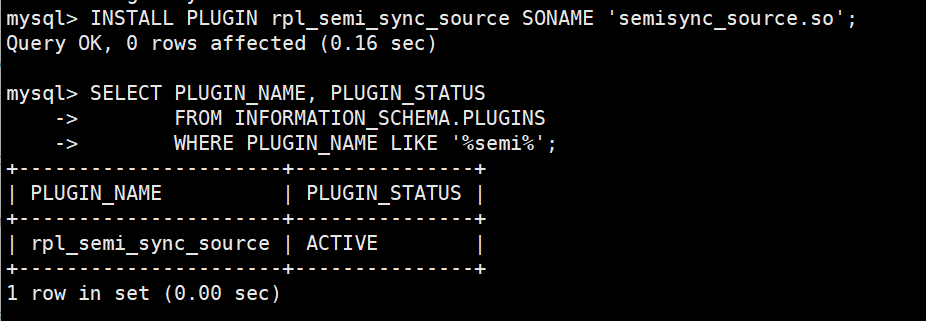
从节点
#from mysql 8.0.26:
install plugin rpl_semi_sync_replica soname 'semisync_replica.so';

#验证是否成功安装
select plugin_name, plugin_status
       from information_schema.plugins
       where plugin_name like '%semi%';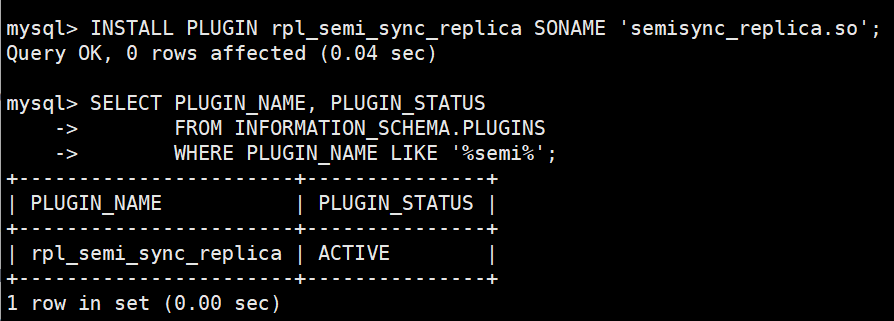
2)开启半同步功能
主节点
set global rpl_semi_sync_source_enabled=1;
#查看是否开启
show variables like "%semi_sync%";
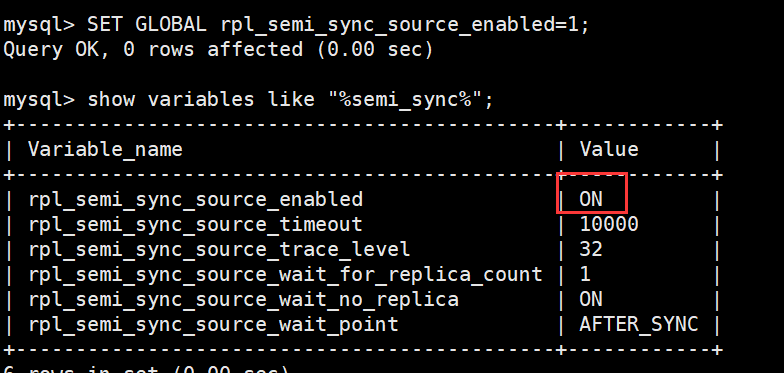
从节点
set global rpl_semi_sync_replica_enabled=1;
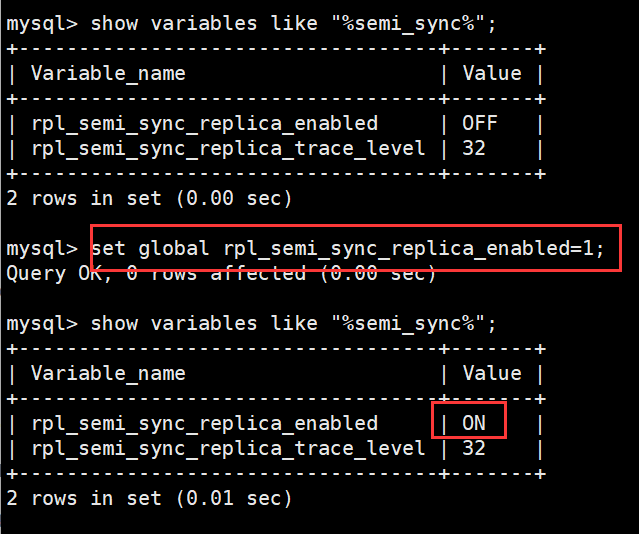
3) 重启从节点上的i/o线程
如果在运行时启用副本上的半同步复制,您还必须启动复制i/o(接收端)线程(如果已经运行,则先停止它),以使副本连接到源端并注册为半同步副本。
stop replica io_thread;
start replica io_thread;
4) 半同步复制测试
测试:当从节点响应超时时,主节点会将同步机制退化为异步复制。 从节点恢复后,同步机制是否会恢复为半同步复制
# 修改主节点半同步属性
set global rpl_semi_sync_source_wait_for_replica_count=2;
set global rpl_semi_sync_source_timeout=100000;

#停掉从节点2
docker stop mysql-replica2
此时在主节点插入数据,从节点1插入成功,但是主节点一直停留在执行阶段,直到超时或从节点2启动并复制数据成功;
#恢复从节点2
docker start mysql-replica2
#从节点2中执行
set global rpl_semi_sync_replica_enabled=1;
stop replica io_thread;
start replica io_thread;
6. 基于binlog位点主从复制痛点分析
痛点 1:首次开启主从复制的步骤复杂
- 第一次开启主从同步时,要求从库和主库是一致的。
- 找到主库的 binlog 位点。
- 设置从库的 binlog 位点。
- 开启从库的复制线程。
痛点 2:恢复主从复制的步骤复杂
- 找到从库复制线程停止时的位点。
- 解决复制异常的事务。无法解决时就需要手动跳过指定类型的错误,比如通过设置 slave_skip_errors=1032,1062。当然这个前提条件是跳过这类错误是无损的。(1062 错误是插入数据时唯一键冲突;1032 错误是删除数据时找不到行)
不论是首次开启同步时需要找位点和设置位点,还是恢复主从复制时,设置位点和忽略错误, 这些步骤都显得过于复杂,而且容易出错。 所以 mysql 5.6 版本引入了 gtid,彻底解决了这个困难。
7. 基于全局事务标识符(gtid)复制
gtid是一个基于原始mysql服务器生成的一个已经被成功执行的全局事务id,它由服务器id以及事务id组合而成。这个全局事务id不仅仅在原始服务器器上唯一,在所有存在主从关系的mysql服务器上也是唯一的。正是因为这样一个特性使得mysql的主从复制变得更加简单,以及数据库一致性更可靠。
- 一个gtid在一个服务器上只执行一次,避免重复执行导致数据混乱或者主从不一致。
- gtid用来代替传统复制方法,不再使用master_log_file+master_log_pos开启复制。而是使用master_auto_postion=1的方式开始复制。
- 在传统的replica端,binlog是不用开启的,但是在gtid中replica端的binlog是必须开启的,目的是记录执行过的gtid(强制)。
gtid 的优势
- 更简单的实现 failover,不用以前那样在需要找位点(log_file 和 log_pos)。
- 更简单的搭建主从复制。
- 比传统的复制更加安全。
- gtid 是连续的没有空洞的,保证数据的一致性,零丢失。
gtid结构
gtid表示为一对坐标,由冒号(:)分隔,如下所示:
gtid = source_id:transaction_id
- source_id标识source服务器,即源服务器唯一的server_uuid,由于gtid会传递到replica,所以也可以理解为源id。
- transaction_id是一个序列号,由事务在源上提交的顺序决定。序列号的上限是有符号64位整数(2^63-1)
例如,最初要在uuid为3e11fa47-71ca-11e1-9e33-c80aa9429562的服务器上提交的第23个事务具有此gtid
3e11fa47-71ca-11e1-9e33-c80aa9429562:23
gtid集合是由一个或多个gtid或gtid范围组成的集合。来自同一服务器的一系列gtid可以折叠成单个表达式,如下所示:
3e11fa47-71ca-11e1-9e33-c80aa9429562:1-5
源自同一服务器的多个单一gtid或gtid范围也可以包含在单个表达式中,gtid或范围以冒号分隔,如下例所示:
3e11fa47-71ca-11e1-9e33-c80aa9429562:1-3:11:47-49
gtid集合可以包括单个gtid和gtid范围的任意组合,也可以包括来自不同服务器的gtid。
2174b383-5441-11e8-b90a-c80aa9429562:1-3, 24da167-0c0c-11e8-8442-00059a3c7b00:1-19
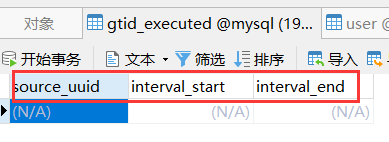
gtid存储在mysql数据库中名为gtid_executed的表中。该表中的一行包含它所代表的每个gtid或gtid集合的起始服务器的uuid,以及该集合的开始和结束事务id。
gtid工作原理
主库计算主库 gtid 集合和从库 gtid 的集合的差集,主库推送差集 binlog 给从库。
当从库设置完同步参数后,主库 a 的 gtid 集合记为集合 x,从库 b 的 gtid 集合记为 y。从库同步的逻辑如下:
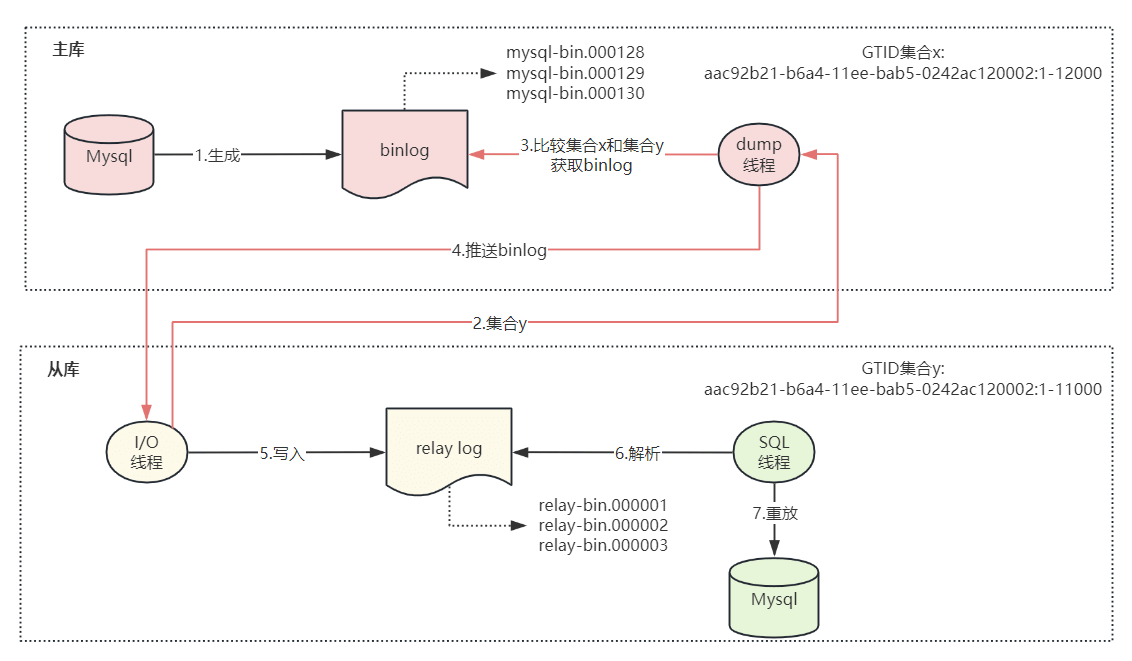
- 从库 b 指定主库 a,基于主备协议建立连接。
- 从库 b 把集合 y 发给主库 a。
- 主库 a 计算出集合 x 和集合 y 的差集,也就是集合 x 中存在,集合 y 中不存在的 gtid 集合。比如集合 x 是 1~100,集合 y 是 1~90,那么这个差集就是 91~100。这里会判断集合 x 是不是包含有集合 y 的所有 gtid,如果不是则说明主库 a 删除了从库 b 需要的 binlog,主库 a 直接返回错误。
- 主库 a 从自己的 binlog 文件里面,找到第一个不在集合 y 中的事务 gtid,也就是找到了 91。
- 主库 a 从 gtid = 91 的事务开始,往后读 binlog 文件,按顺序取 binlog,然后发给 b。
- 从库 b 的 i/o 线程读取 binlog 文件生成 relay log,sql 线程解析 relay log,然后执行 sql 语句。
gtid 同步方案和位点同步的方案区别是:
- 位点同步方案是通过人工在从库上指定哪个位点,主库就发哪个位点,不做日志的完整性判断。
- 而 gtid 方案是通过主库来自动计算位点的,不需要人工去设置位点,对运维人员友好。
gtid的配置
1) 修改主库配置
修改主库的配置文件
#gtid:
#启用全局事务标识符(gtid)模式
gtid_mode=on
# 强制gtid的一致性。这意味着在执行事务时,mysql将确保所有涉及的服务器都使用相同的gtid集。
enforce_gtid_consistency=on
2)修改从库配置
修改从库配置文件
#gtid:
gtid_mode=on
enforce_gtid_consistency=on
3)从节点设置主库信息
# 从库配置同步参数
mysql> change master to
     >     master_host = host,
     >     master_port = port,
     >     master_user = user,
     >     master_password = password,
     >     master_auto_position = 1;

or from mysql 8.0.23:
mysql> change replication source to
     >     source_host = host,
     >     source_port = port,
     >     source_user = user,
     >     source_password = password,
     >     source_auto_position = 1;
source_auto_position = 1: 这告诉从服务器使用自动位置跟踪功能,以便它可以自动从主服务器获取最新的二进制日志事件,而无需手动指定位置。
8. 基于gtid主从复制示例
在前面基于binlog日志主从复制的mysql服务上配置gtid复制。
1) 同步所有的mysql服务器
在主从服务器上都执行下面的命令:
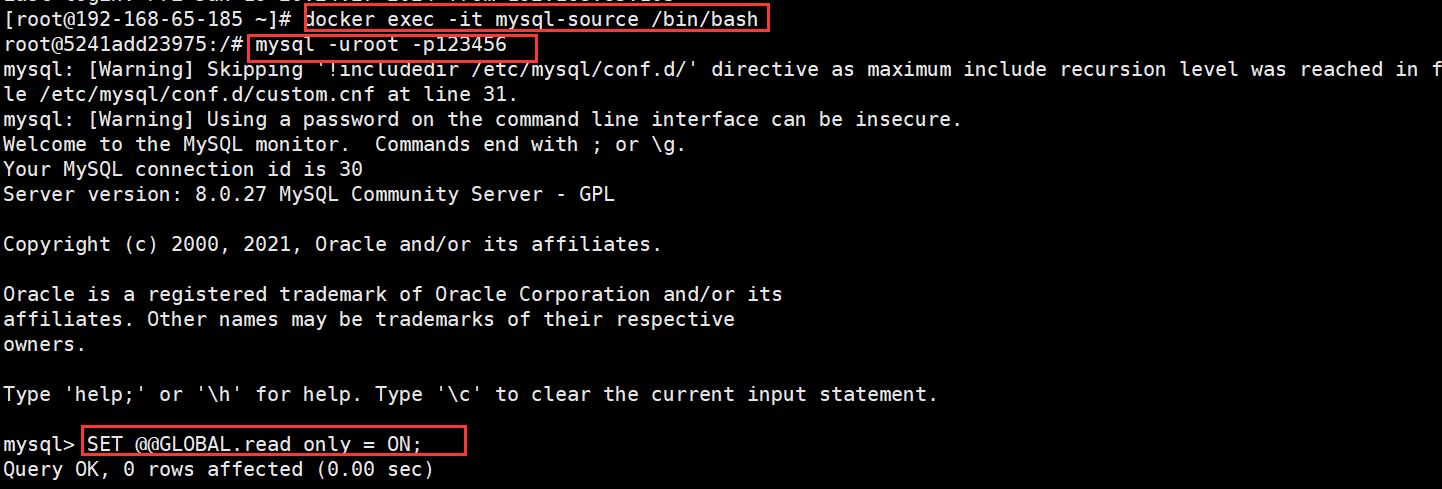
# 设置mysql服务器的全局只读模式
mysql> set @@global.read_only = on;
注意:只有在使用已经在进行复制而不使用gtid的服务器时才需要此步骤。对于新服务器,请继续执行步骤3。
2) 停止所有的服务器
docker stop mysql-source mysql-replica1 mysql-replica2
3) 主从节点都启用gtid
修改custom.cnf
# 启用gtid
gtid_mode=on
enforce-gtid-consistency=on
启动主从节点
docker start mysql-source mysql-replica1 mysql-replica2
4)从节点配置基于gtid的自动定位
进入从节点,执行下面命令:
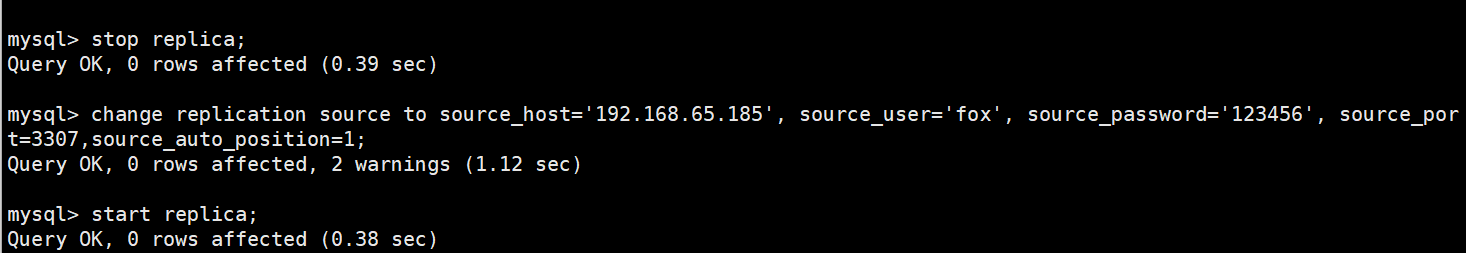
mysql> stop replica;
mysql> change replication source to source_host='192.168.65.185', source_user='fox', source_password='123456', source_port=3307,source_auto_position=1;
5) 开启从库复制,并禁用只读模式
# 开启从库复制
mysql> start replica;
# 只有在步骤1中将服务器配置为只读时,才需要执行以下步骤。要允许服务器再次开始接受更新
mysql> set @@global.read_only = off;
查看从库状态是否正常
mysql> show replica status \g
9. 主从切换演练
场景1
模拟主库down机、从库1数据同步完成、从库2数据未同步完成
1)从库2停止复制
mysql> stop replica;
2)主库创建测试数据
insert into `test`.`user` values (12, 'fox', null, null, null);
3) 查询数据
从库1
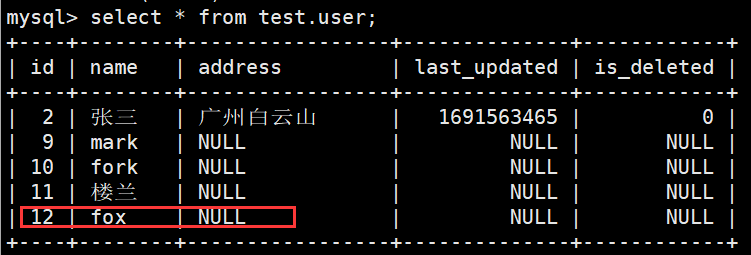
从库2
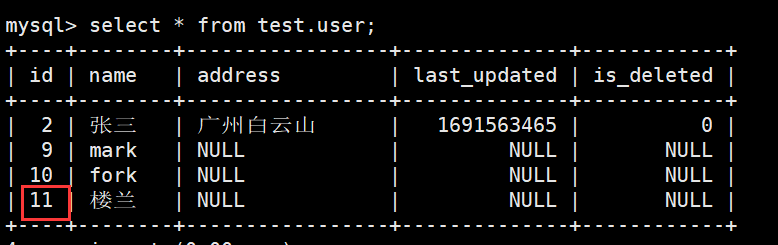
很显然,从库1同步了最新数据,比从库2数据新
场景2:
将主库宕机,从库1升级为主库、从库2切换主库为从库1(新的主库),观察从库2是否同步未完成的事务
1)停止主库
docker stop mysql-source
2)设置新主库
设置replica1 为replica2的主库,因为replica1的数据是完整的。
按照普通复制方法,需要计算主库的log_pos和从库设置成主库的log_pos,可能出现错误
因为同一事务的gtid在所有节点上的值一致,那么根据replica2当前停止点的gtid就能定位到要主库的gtid,所以直接在replica2上执行change即可
# replica1上创建复制用户
create user 'fox'@'%' identified with mysql_native_password by '123456';
grant replication slave on *.* to 'fox'@'%';
flush privileges;

# replica2上执行 从replica1查询
mysql> stop replica;
mysql> change replication source to source_host='192.168.65.185',source_port=3308,source_user='fox',source_password='123456',source_auto_position=1;
mysql> start replica;
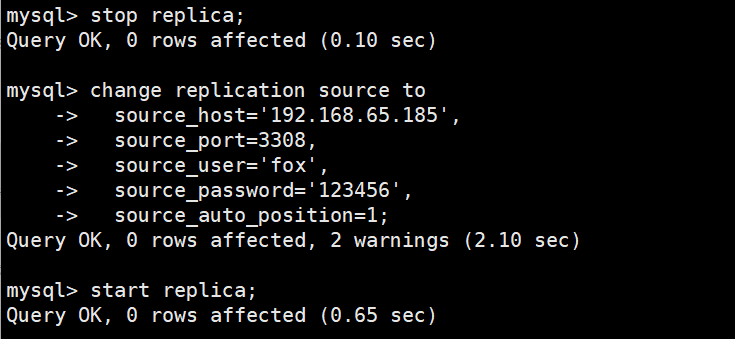
查看同步结果
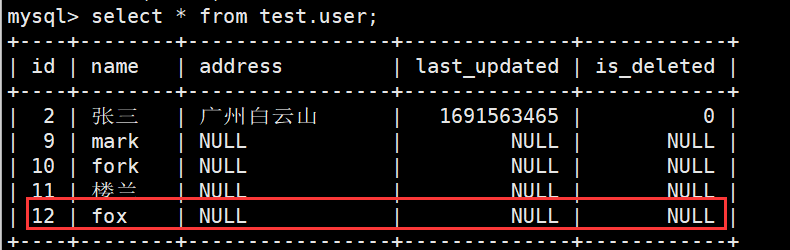
场景3
模拟从库删除测试表,主库对表进行插入操作。观察从库复制是否报错
1)replica1删除test.user表,主库插入新记录
# 从库1 删除user表
drop table test.user;

# 主库插入新记录
insert into `test`.`user` values (14, 'aaa', null, null, null);
2) 查看从库同步情况
# 从库1执行
mysql> show replica status\g
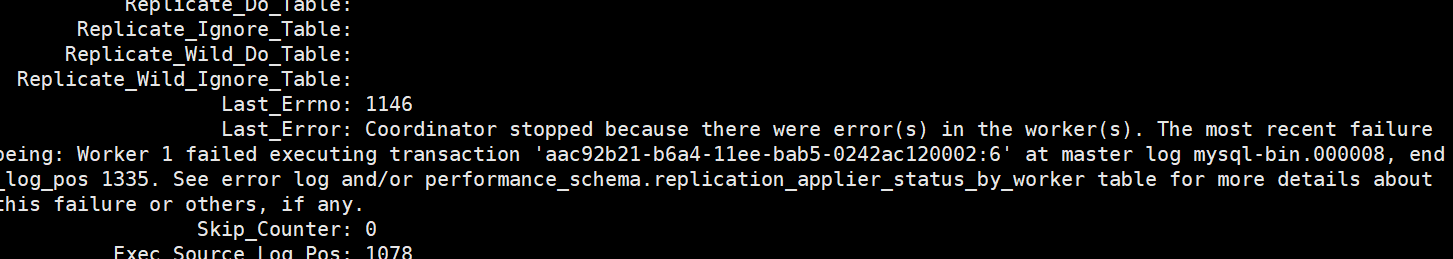
报错信息:事务aac92b21-b6a4-11ee-bab5-0242ac120002:6执行失败
coordinator stopped because there were error(s) in the worker(s). the most recent failure being: worker 1 failed executing transaction 'aac92b21-b6a4-11ee-bab5-0242ac120002:6' at master log mysql-bin.000008, end_log_pos 1335. see error log and/or performance_schema.replication_applier_status_by_worker table for more details about this failure or others, if any.
3)在主库继续进行其他事务,观察gitd是否复制成功
# 主库插入新记录
insert into `test`.`user` values (15, 'bbb', null, null, null);
从库状态

可以看出从库复制中断 (注意:删除了表,无法插入)
4)复制中断修复:采用从库跳过错误事务修复
因为从库user表已经删了(user表中部分数据不是利用gtid复制过去的),先从主库将表数据拷贝到从库
获取从库最新状态
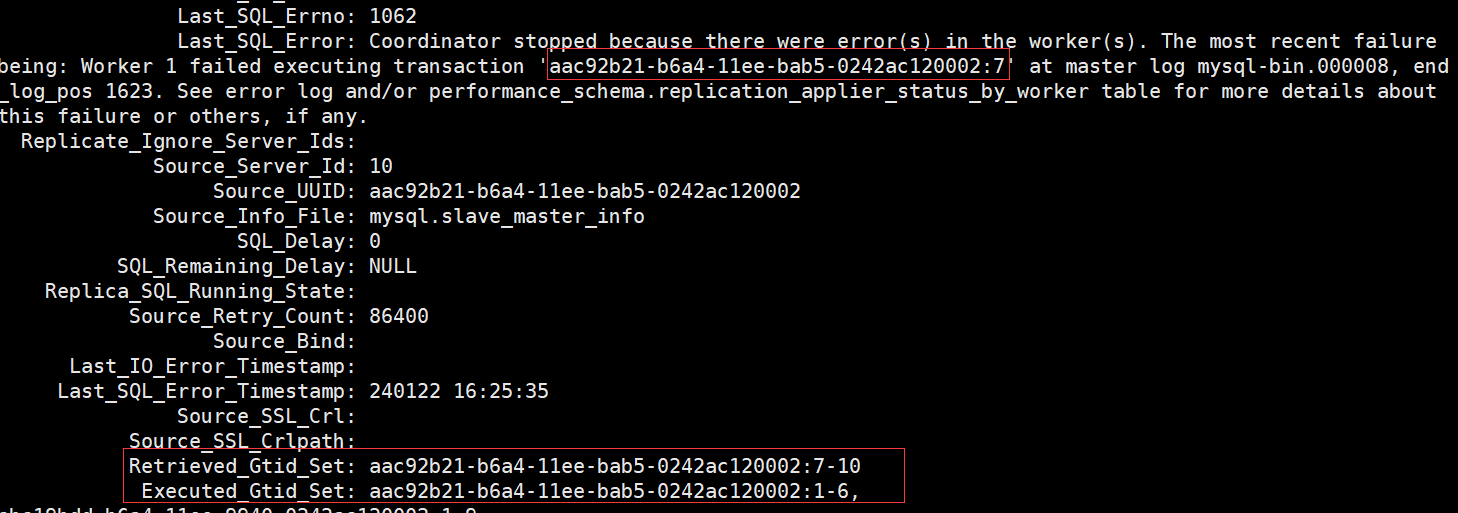
从库执行
# 1.停止从库1复制进程
mysql> stop replica;
# 2.设置事务号,事务号从 retrieved_gtid_set 获取,在session里设置gtid_next,即跳过这个gtid
# 注意,选择跳过出现错误的事务
mysql> set @@session.gtid_next= 'aac92b21-b6a4-11ee-bab5-0242ac120002:7';
# 3.设置空事物
mysql> begin; commit;
# 4.恢复自增事物号
mysql> set session gtid_next = automatic;
# 5.启动从库1复制进程
mysql> start replica;
# 再次查询会发现主库数据已经同步过来了
mysql> select * from test.user;
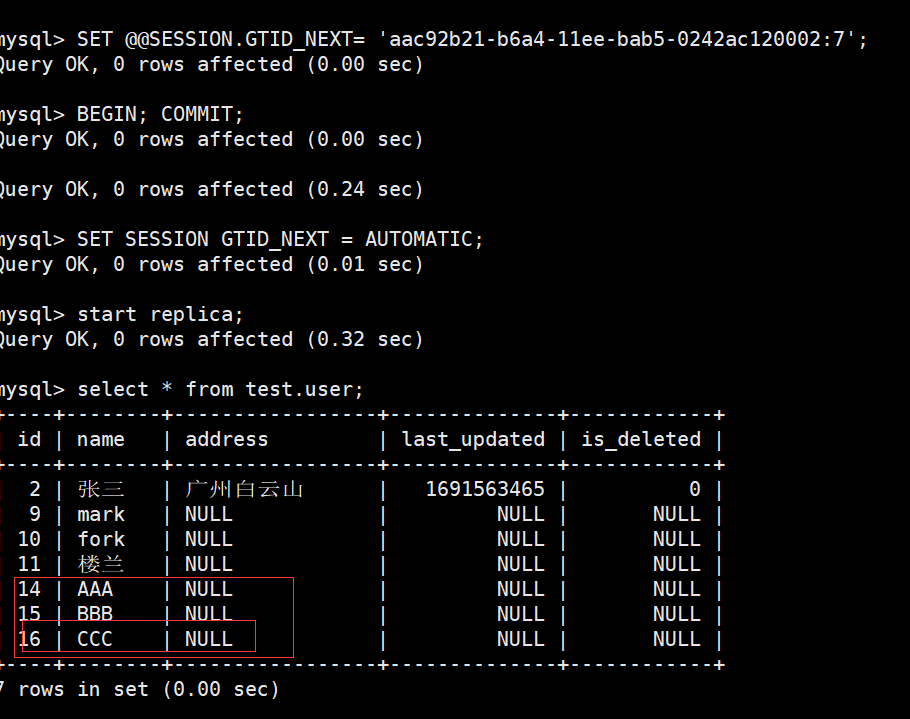
如果需要一次跳过多条,找出需要跳过的gtid,批量执行:
stop replica;
set @@session.gtid_next= 'd58e6bad-ef3e-11ee-8285-0242ac120003:4';begin;commit;
set @@session.gtid_next= 'd58e6bad-ef3e-11ee-8285-0242ac120003:5';begin;commit;
set @@session.gtid_next= 'd58e6bad-ef3e-11ee-8285-0242ac120003:6';begin;commit;
set session gtid_next = automatic;
start replica;
完整的演示步骤:
1.从库删除user表
mysql> drop table user;
mysql> select * from user;
+----+--------+-----------------+--------------+------------+
| id | name   | address         | last_updated | is_deleted |
+----+--------+-----------------+--------------+------------+
|  2 | 张三   | 广州白云山      |   1691563465 |          0 |
|  3 | fox    | null            |         null |       null |
|  4 | 李四   | null            |         null |       null |
|  5 | 111    | null            |         null |       null |
| 12 | fox    | null            |         null |       null |
| 14 | aaa    | null            |         null |       null |
| 15 | bbb    | null            |         null |       null |
| 16 | ccc    | null            |         null |       null |
| 20 | ddd    | null            |         null |       null |
| 22 | eee    | null            |         null |       null |
+----+--------+-----------------+--------------+------------+
10 rows in set (0.00 sec)

mysql> delete from user where id=20;
query ok, 1 row affected (0.19 sec)

mysql> select * from user;
+----+--------+-----------------+--------------+------------+
| id | name   | address         | last_updated | is_deleted |
+----+--------+-----------------+--------------+------------+
|  2 | 张三   | 广州白云山      |   1691563465 |          0 |
|  3 | fox    | null            |         null |       null |
|  4 | 李四   | null            |         null |       null |
|  5 | 111    | null            |         null |       null |
| 12 | fox    | null            |         null |       null |
| 14 | aaa    | null            |         null |       null |
| 15 | bbb    | null            |         null |       null |
| 16 | ccc    | null            |         null |       null |
| 22 | eee    | null            |         null |       null |
| 23 | 333    | null            |         null |       null |
+----+--------+-----------------+--------------+------------+
10 rows in set (0.00 sec)

mysql> delete from user where id=22;
query ok, 1 row affected (0.29 sec)

mysql> select * from user;
+----+--------+-----------------+--------------+------------+
| id | name   | address         | last_updated | is_deleted |
+----+--------+-----------------+--------------+------------+
|  2 | 张三   | 广州白云山      |   1691563465 |          0 |
|  3 | fox    | null            |         null |       null |
|  4 | 李四   | null            |         null |       null |
|  5 | 111    | null            |         null |       null |
| 12 | fox    | null            |         null |       null |
| 14 | aaa    | null            |         null |       null |
| 15 | bbb    | null            |         null |       null |
| 16 | ccc    | null            |         null |       null |
| 23 | 333    | null            |         null |       null |
+----+--------+-----------------+--------------+------------+
9 rows in set (0.00 sec)
3. 借助navicat将主库user表复制到从库,包括数据。 这样一来从库就有了当前的全量数据,只需要跳过错误的gtid,从最新的gtid开始执行就可以了。
# 查询从库,确定数据是否和主库一致
mysql> select * from user;
+----+--------+-----------------+--------------+------------+
| id | name   | address         | last_updated | is_deleted |
+----+--------+-----------------+--------------+------------+
|  2 | 张三   | 广州白云山      |   1691563465 |          0 |
|  3 | fox    | null            |         null |       null |
|  4 | 李四   | null            |         null |       null |
|  5 | 111    | null            |         null |       null |
| 12 | fox    | null            |         null |       null |
| 14 | aaa    | null            |         null |       null |
| 15 | bbb    | null            |         null |       null |
| 16 | ccc    | null            |         null |       null |
| 23 | 333    | null            |         null |       null |
+----+--------+-----------------+--------------+------------+
9 rows in set (0.00 sec)
4. 获取从库需要配置跳过错误的事务
# 获取到错误的gtid为d58e6bad-ef3e-11ee-8285-0242ac120003:12,
# 因为连续删除过两条数据,所以d58e6bad-ef3e-11ee-8285-0242ac120003:13也是错误的事务
mysql> show replica status\g;
*************************** 1. row ***************************
             replica_io_state: waiting for source to send event
                  source_host: 192.168.65.223
                  source_user: fox
                  source_port: 3308
                connect_retry: 30
              source_log_file: mysql-bin.000004
          read_source_log_pos: 4229
               relay_log_file: 3c946c781110-relay-bin.000012
                relay_log_pos: 790
        relay_source_log_file: mysql-bin.000004
           replica_io_running: yes
          replica_sql_running: no
              replicate_do_db:
          replicate_ignore_db:
           replicate_do_table:
       replicate_ignore_table:
      replicate_wild_do_table:
  replicate_wild_ignore_table:
                   last_errno: 1146
                   last_error: coordinator stopped because there were error(s) in the worker(s). the most recent failure being: worker 1 failed executing transaction 'd58e6bad-ef3e-11ee-8285-0242ac120003:12' at master log mysql-bin.000004, end_log_pos 3906. see error log and/or performance_schema.replication_applier_status_by_worker table for more details about this failure or others, if any.
                 skip_counter: 0
          exec_source_log_pos: 3645
              relay_log_space: 1932
              until_condition: none
               until_log_file:
                until_log_pos: 0
           source_ssl_allowed: no
           source_ssl_ca_file:
           source_ssl_ca_path:
              source_ssl_cert:
            source_ssl_cipher:
               source_ssl_key:
        seconds_behind_source: null
source_ssl_verify_server_cert: no
                last_io_errno: 0
                last_io_error:
               last_sql_errno: 1146
               last_sql_error: coordinator stopped because there were error(s) in the worker(s). the most recent failure being: worker 1 failed executing transaction 'd58e6bad-ef3e-11ee-8285-0242ac120003:12' at master log mysql-bin.000004, end_log_pos 3906. see error log and/or performance_schema.replication_applier_status_by_worker table for more details about this failure or others, if any.
  replicate_ignore_server_ids:
             source_server_id: 11
                  source_uuid: d58e6bad-ef3e-11ee-8285-0242ac120003
             source_info_file: mysql.slave_master_info
                    sql_delay: 0
          sql_remaining_delay: null
    replica_sql_running_state:
           source_retry_count: 86400
                  source_bind:
      last_io_error_timestamp:
     last_sql_error_timestamp: 240401 14:17:40
               source_ssl_crl:
           source_ssl_crlpath:
           retrieved_gtid_set: d58e6bad-ef3e-11ee-8285-0242ac120003:1-13, dfb1f706-ef3e-11ee-82cc-0242ac120004:2
            executed_gtid_set: ce6baf4a-ef3e-11ee-99fb-0242ac120002:1-13, d58e6bad-ef3e-11ee-8285-0242ac120003:1-11, dfb1f706-ef3e-11ee-82cc-0242ac120004:1-2
                auto_position: 1
         replicate_rewrite_db:
                 channel_name:
           source_tls_version:
       source_public_key_path:
        get_source_public_key: 0
            network_namespace:
1 row in set (0.00 sec)
5. 在主库再次执行删除操作
mysql> delete from user where id=12;
query ok, 1 row affected (0.11 sec)

mysql> select * from user;
+----+--------+-----------------+--------------+------------+
| id | name   | address         | last_updated | is_deleted |
+----+--------+-----------------+--------------+------------+
|  2 | 张三   | 广州白云山      |   1691563465 |          0 |
|  3 | fox    | null            |         null |       null |
|  4 | 李四   | null            |         null |       null |
|  5 | 111    | null            |         null |       null |
| 14 | aaa    | null            |         null |       null |
| 15 | bbb    | null            |         null |       null |
| 16 | ccc    | null            |         null |       null |
| 23 | 333    | null            |         null |       null |
+----+--------+-----------------+--------------+------------+
6.在从库
mysql> select * from user;
+----+--------+-----------------+--------------+------------+
| id | name   | address         | last_updated | is_deleted |
+----+--------+-----------------+--------------+------------+
|  2 | 张三   | 广州白云山      |   1691563465 |          0 |
|  3 | fox    | null            |         null |       null |
|  4 | 李四   | null            |         null |       null |
|  5 | 111    | null            |         null |       null |
| 12 | fox    | null            |         null |       null |
| 14 | aaa    | null            |         null |       null |
| 15 | bbb    | null            |         null |       null |
| 16 | ccc    | null            |         null |       null |
| 23 | 333    | null            |         null |       null |
+----+--------+-----------------+--------------+------------+
9 rows in set (0.00 sec)

mysql> stop replica;
query ok, 0 rows affected (0.07 sec)
# 如果需要一次跳过多条,找出需要跳过的gtid,批量执行
mysql> set @@session.gtid_next= 'd58e6bad-ef3e-11ee-8285-0242ac120003:12';begin;commit;
query ok, 0 rows affected (0.00 sec)

query ok, 0 rows affected (0.00 sec)

query ok, 0 rows affected (0.12 sec)

mysql> set @@session.gtid_next= 'd58e6bad-ef3e-11ee-8285-0242ac120003:13';begin;commit;
query ok, 0 rows affected (0.00 sec)

query ok, 0 rows affected (0.00 sec)

query ok, 0 rows affected (0.00 sec)

mysql> set session gtid_next = automatic;
query ok, 0 rows affected (0.00 sec)

mysql> start replica;
query ok, 0 rows affected (1.10 sec)

mysql> select * from user;
+----+--------+-----------------+--------------+------------+
| id | name   | address         | last_updated | is_deleted |
+----+--------+-----------------+--------------+------------+
|  2 | 张三   | 广州白云山      |   1691563465 |          0 |
|  3 | fox    | null            |         null |       null |
|  4 | 李四   | null            |         null |       null |
|  5 | 111    | null            |         null |       null |
| 14 | aaa    | null            |         null |       null |
| 15 | bbb    | null            |         null |       null |
| 16 | ccc    | null            |         null |       null |
| 23 | 333    | null            |         null |       null |
+----+--------+-----------------+--------------+------------+
8 rows in set (0.01 sec)
二、组复制
1. 什么是组复制
由于传统异步复制的缺陷,可能会导致主从数据不一致的问题,在主节点异常宕机时从节点可能造成数据丢失。基于这个缺陷,mysql5.7.17推出了一个高可用与高扩展的解决方案mysql group replication(简称mgr),将原有的gtid复制功能进行了增强,支持单主模式和多主模式。组复制在数据库层面上做到了只要集群中大多数主机可用,则服务可用,也就是说3台服务器的集群,允许其中1台宕机。
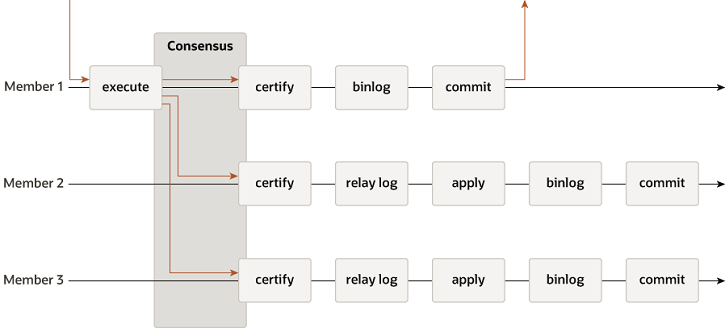
group replication提供了分布式状态机复制,服务器之间具有很强的协调性。当服务器属于同一组时,它们会自动进行协调。该组可以在具有自动选主的单主模式下运行,在这种模式下,一次只有一台服务器接受更新。或者,对于更高级的用户,可以在多主模式下部署该组,其中所有服务器都可以接受更新,即使它们是并发执行的。
与传统复制相比,group replication有以下大幅改进:
- 传统复制的主从复制方式有一个主和不等数量的从。主节点执行的事务会异步发送给从节点,在从节点重新执行。而group replication采用整组写入的方式,避免了单点争用。
- group replication在传输数据时使用了paxos协议。paxos协议保证了数据传输的一致性和原子性。基于paxos协议,group replication构建了一个分布式的状态复制机制,这是实现多主复制的核心技术。
- group replication提供了多写方案,为多活方案带来了实现的可能。
mgr 能保证数据库服务的连续可用,却无法处理如下问题:当一个组成员变为不可用时,连接到它的客户端必须被重定向或故障转移到其他组成员。此时需要使用连接器、负载均衡器、路由器或某种形式的中间件,例如 mysql router 8.0 。mgr 本身不提供这些工具。此时便引入了 innodb cluster ,后面详述。
2. 单主模式
组中的每个mysql服务器实例都可以在独立的物理主机上运行,这是部署组复制的推荐方式。
在单主模式下(group_replication_single_primary_mode=on),组中只有一个主服务器,该主服务器被设置为读写模式。组中的所有其他成员都被设置为只读模式(super_read_only=on)。
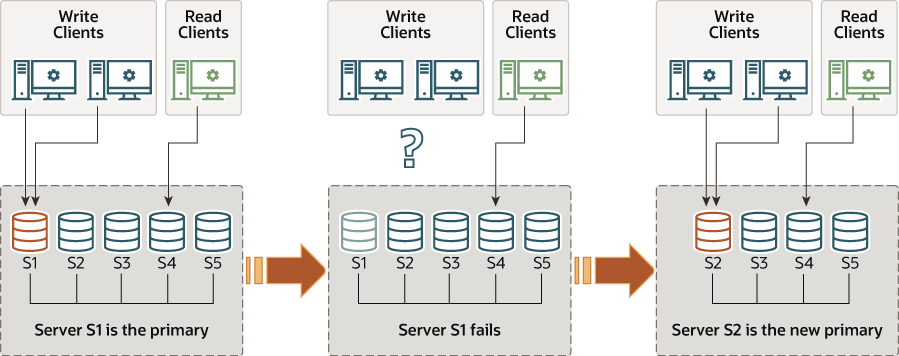
查找primary的两种方式
# 方式1:查询performance_schema.replication_group_members的member_role列
mysql> select member_host, member_role from performance_schema.replication_group_members;
+-------------------------+-------------+
| member_host             | member_role |
+-------------------------+-------------+
| remote1.example.com     | primary     |
| remote2.example.com     | secondary   |
| remote3.example.com     | secondary   |
+-------------------------+-------------+

# 方式2:查看group_replication_primary_member变量状态
mysql> show status like 'group_replication_primary_member';
单主模式部署示例
1) 部署三个mysql server实例
可以利用docker快速部署3个mysql实例
角色 | server_id | db port | 内部通信 |
mgr-node1(primary) | 1 | 3321>3306 | mgr-node1:33061 |
mgr-node2(secondary) | 2 | 3322>3306 | mgr-node2:33061 |
mgr-node3(secondary) | 3 | 3323>3306 | mgr-node3:33061 |
# 创建组复制的网络  保证三个mysql容器之间可以通过容器名访问
docker network create --driver bridge mgr-network
mkdir -p /mysql/mgr/node1/data /mysql/mgr/node1/conf /mysql/mgr/node1/log
mkdir -p /mysql/mgr/node2/data /mysql/mgr/node2/conf /mysql/mgr/node2/log
mkdir -p /mysql/mgr/node3/data /mysql/mgr/node3/conf /mysql/mgr/node3/log

#运行mysql容器
docker run  -d  \
--name mgr-node1 \
--privileged=true \
--restart=always \
--network  mgr-network \
-p 3321:3306 \
-v /mysql/mgr/node1/data:/var/lib/mysql \
-v /mysql/mgr/node1/conf:/etc/mysql/conf.d  \
-v /mysql/mgr/node1/log:/logs \
-e mysql_root_password=123456 \
-e tz=asia/shanghai mysql:8.0.27 \
--lower_case_table_names=1

docker run  -d  \
--name mgr-node2 \
--privileged=true \
--restart=always \
--network  mgr-network \
-p 3322:3306 \
-v /mysql/mgr/node2/data:/var/lib/mysql \
-v /mysql/mgr/node2/conf:/etc/mysql/conf.d  \
-v /mysql/mgr/node2/log:/logs \
-e mysql_root_password=123456 \
-e tz=asia/shanghai mysql:8.0.27 \
--lower_case_table_names=1

docker run  -d  \
--name mgr-node3 \
--privileged=true \
--restart=always \
--network  mgr-network \
-p 3323:3306 \
-v /mysql/mgr/node3/data:/var/lib/mysql \
-v /mysql/mgr/node3/conf:/etc/mysql/conf.d  \
-v /mysql/mgr/node3/log:/logs \
-e mysql_root_password=123456 \
-e tz=asia/shanghai mysql:8.0.27 \
--lower_case_table_names=1
2)配置组复制实例
以mgr-node1配置为例,创建/mysql/mgr/node1/conf/custom.cnf,添加以下配置:
[mysql]
# 设置mysql客户端默认编码
default-character-set=utf8

[mysqld]
pid-file        = /var/run/mysqld/mysqld.pid
socket          = /var/run/mysqld/mysqld.sock
datadir         = /var/lib/mysql

secure-file-priv= null

# disabling symbolic-links is recommended to prevent assorted security risks
symbolic-links=0

#对于group replication,数据必须存储在innodb事务存储引擎中
disabled_storage_engines="myisam,blackhole,federated,archive,memory"

#指定sever_id,三个mysql实例需要分别改为对应的sever_id
server_id=1
# 必须开启gtid支持
gtid_mode=on
enforce_gtid_consistency=on

# 启用二进制日志
log-bin=mysql-bin

#组复制设置
#实例启动时会将组复制插件加载到插件列表中
plugin_load_add='group_replication.so'
# 组名三个节点必须保证一致,必须是uuid,可以使用 select uuid()生成一个
group_replication_group_name="117dc7ea-b9bd-11ee-9bdb-0242ac120002"
# 插件在服务器启动时不自动启动,可以等配置好服务器之后手动启动
group_replication_start_on_boot=off
# 配置与组内其他成员通信是使用的主机名和端口,内部通讯端口,推荐使用 33061
group_replication_local_address= "mgr-node1:33061"
# 设置组成员的主机名和端口
group_replication_group_seeds= "mgr-node1:33061,mgr-node2:33061,mgr-node3:33061"
# 通常会在实例运行时配置group_replication_bootstrap_group,以确保只有一个成员实际引导组
group_replication_bootstrap_group=off


# 最大连接数
max_connections=1000

# 设置默认时区
default-time_zone='+8:00'

# 0:区分大小写
# 1:不区分大小写
lower_case_table_names=1

!includedir /etc/mysql/conf.d/
mgr-node2和mgr-node3同上
注意配置文件路径和修改server_id和group_replication_local_address
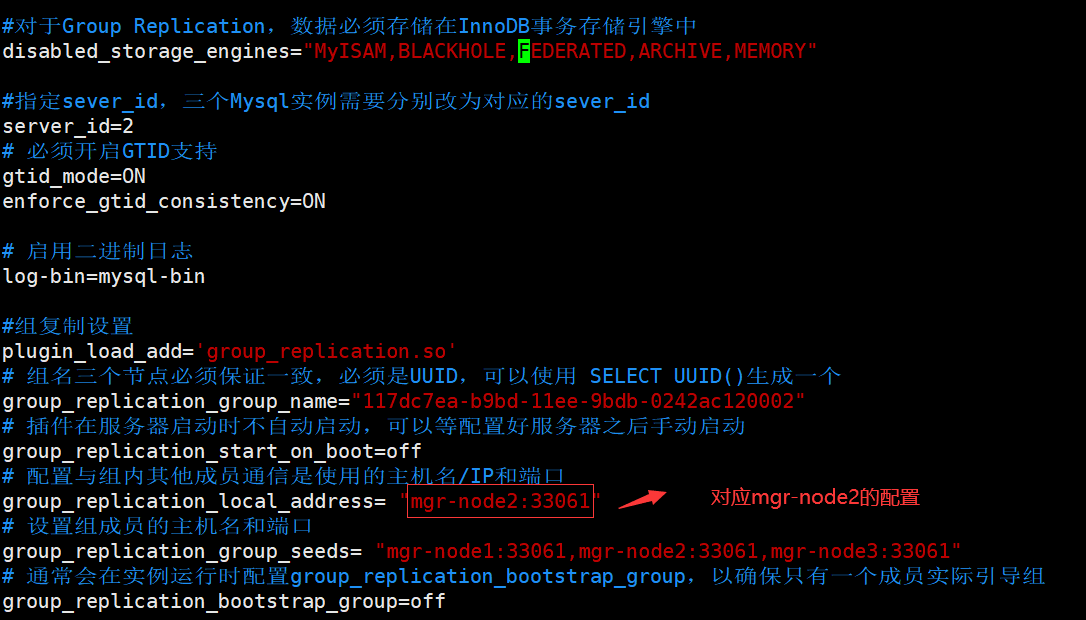
3)配置用于分布式恢复的用户凭证
mgr-node1上配置
3.1)重新启动mysql实例
docker restart mgr-node1 mgr-node2 mgr-node3
3.2)禁用二进制日志记录,以便在每个实例上分别创建复制用户
# mgr-node1为例
[root@192-168-65-185 ~]# docker exec -it mgr-node1 /bin/bash
root@0955d5f390c6:/# mysql -uroot -p123456
mysql> set sql_log_bin=0;
3.3) 创建mysql用户,授予所需的权限
mysql>  create user fox@'%' identified  by '123456';
        grant replication slave on *.* to fox@'%';
        grant connection_admin on *.* to fox@'%';
        grant backup_admin on *.* to fox@'%';
        grant group_replication_stream on *.* to fox@'%';
        flush privileges;
3.4)如果前面禁用了二进制日志,再次启用二进制日志
mysql> set sql_log_bin=1;
3.5)创建复制用户后,必须向服务器提供用于分布式恢复的用户凭据。
- 使用change replication source to | change master to设置的用户凭据以明文形式存储在服务器上的复制元数据存储库中。当组复制启动时,它们将被应用,包括当系统变量group_replication_start_on_boot设置为on时自动启动。
- 在start group_replication上指定的用户凭据仅保存在内存中,并通过stop group_replication语句或服务器关闭来删除。必须发出start group_replication语句来再次提供凭据,因此无法使用这些凭据自动启动group replication。这种指定用户凭据的方法有助于保护组复制服务器免受未经授权的访问。此功能从mysql 8.0.21开始支持。
#from mysql 8.0.23:
mysql> change replication source to source_user='fox', source_password='123456' for channel 'group_replication_recovery';
注意:如果不想配置ssl,可以配置参数group_replication_recovery_public_key_path=on来在请求复制用户密钥时给公钥
#实例加入集群需要获取公钥
set global group_replication_recovery_get_public_key=on;
4) 指定mgr-node1引导组(primary节点),启用组复制
为了安全地引导组,连接到mgr-node1并执行以下语句:
#mgr-node1启动组复制,并且作为primary
mysql> set global group_replication_bootstrap_group=on;
        start group_replication;
        set global group_replication_bootstrap_group=off;
# 查询组成员信息,mgr-node1是否是primary
mysql> select member_host, member_role from performance_schema.replication_group_members; 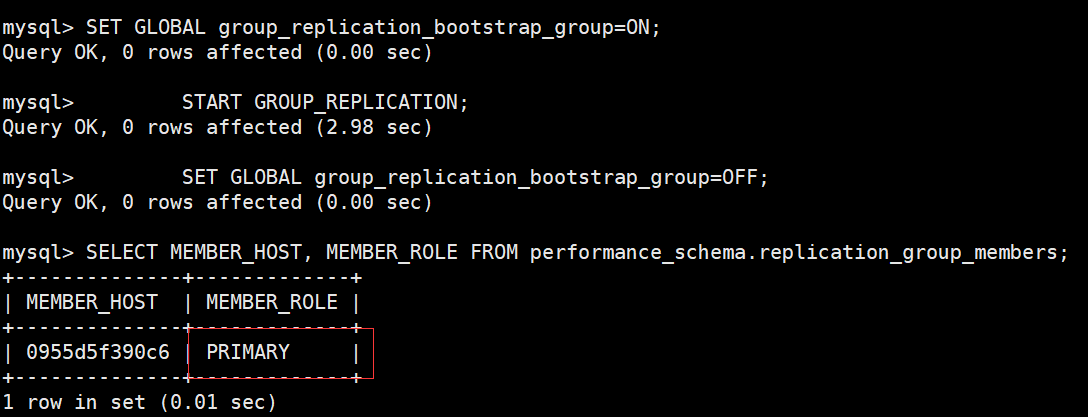
为了验证后续其他节点入组情况,下面将创建一个表并向其中添加一些数据进行验证。
create database if not exists test;
use test;
create table t1 (c1 int primary key, c2 text not null);
insert into t1 values (1, 'fox');
5)向组中添加实例mgr-node2和mgr-node3
#添加复制用户
set sql_log_bin=0;
create user fox@'%' identified by '123456';
grant replication slave on *.* to fox@'%';
grant connection_admin on *.* to fox@'%';
grant backup_admin on *.* to fox@'%';
grant group_replication_stream on *.* to fox@'%';
flush privileges;
set sql_log_bin=1;
change replication source to source_user='fox', source_password='123456' for channel 'group_replication_recovery';
set global group_replication_recovery_get_public_key=on;

# mgr-node2和mgr-node3启用主复制
mysql> start group_replication;
# 查询组成员信息
mysql> select member_host, member_role from performance_schema.replication_group_members;
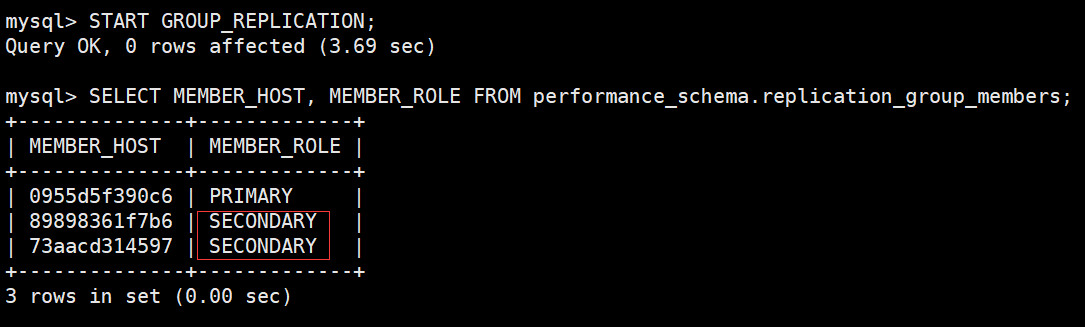
确认数据同步情况
select * from test.user;
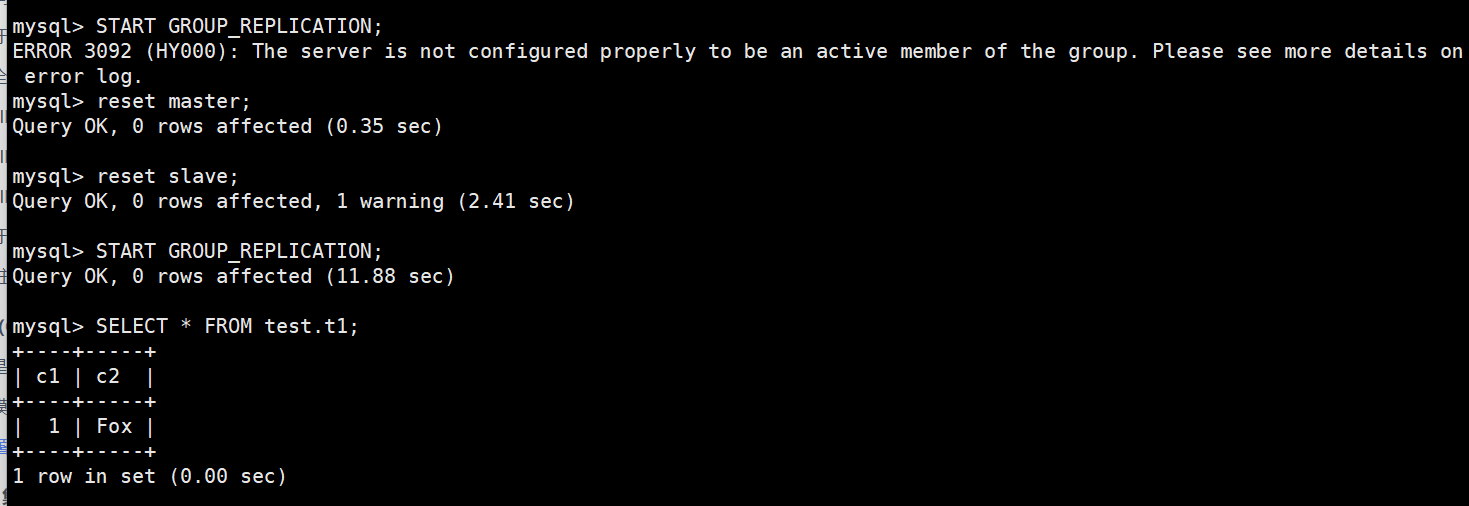
如果数据没有正常同步,可以通过docker log -f mgr-node2排查问题
多主模式
在多主模式下(group_replication_single_primary_mode=off),没有成员具有特殊的角色。任何与其他组成员兼容的成员在加入组时都被设置为读写模式,并且可以处理写事务,即使它们是并发发布的。
如果一个成员停止接受写事务,例如,在服务器意外退出的情况下,连接到它的客户端可以被重定向或故障转移到处于读写模式的任何其他成员。group replication本身不处理客户端故障转移,因此需要使用中间件框架(如mysql router 8.0)、代理、连接器或应用程序本身来安排。
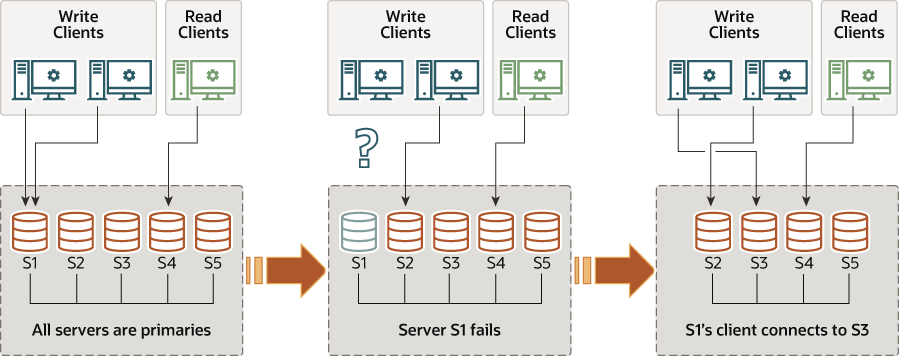
多主模式部署示例
在前面单主模式基础上改为多主模式
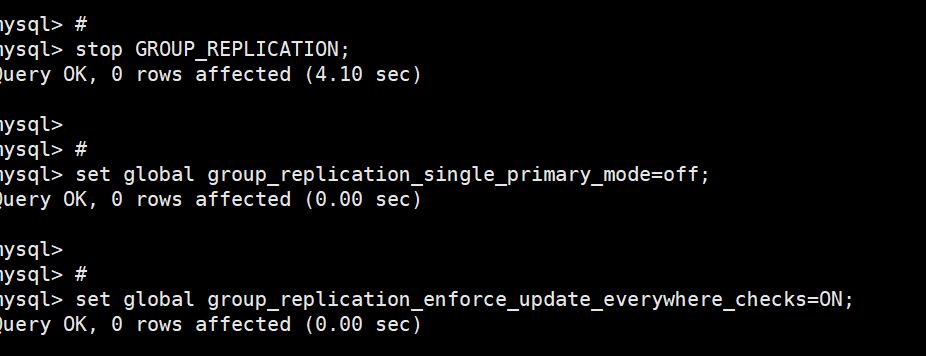
1)三个节点都关闭单主模式
三个节点都执行如下操作
# 停止组复制
stop group_replication;

# 关闭单主模式
set global group_replication_single_primary_mode=off;

# 开启多主一致性检查
set global group_replication_enforce_update_everywhere_checks=on;
2)选择mgr-node1引导组复制
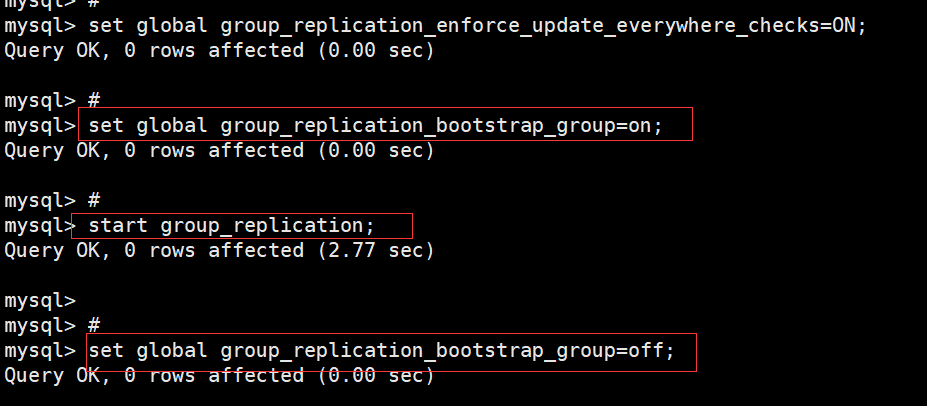
# 开启组复制引导
set global group_replication_bootstrap_group=on;
# 开启组复制
start group_replication;

# 关闭组复制引导
set global group_replication_bootstrap_group=off;
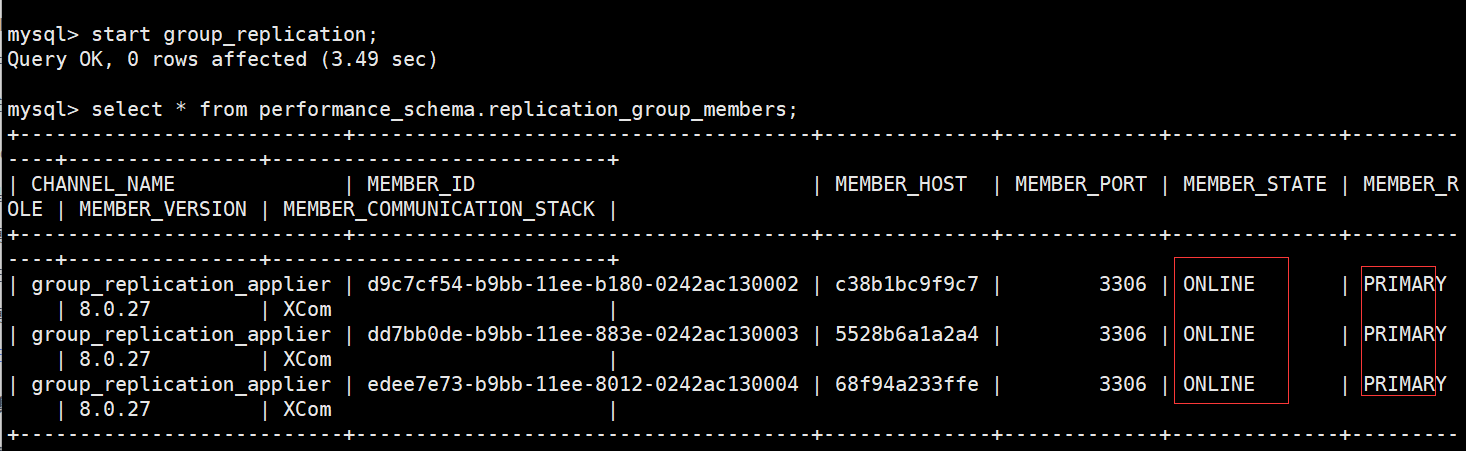
3)mgr-node2和mgr-node3开启组复制
# 开启组复制
start group_replication;

# 查看到添加到组复制集群的服务器信息
select * from performance_schema.replication_group_members;
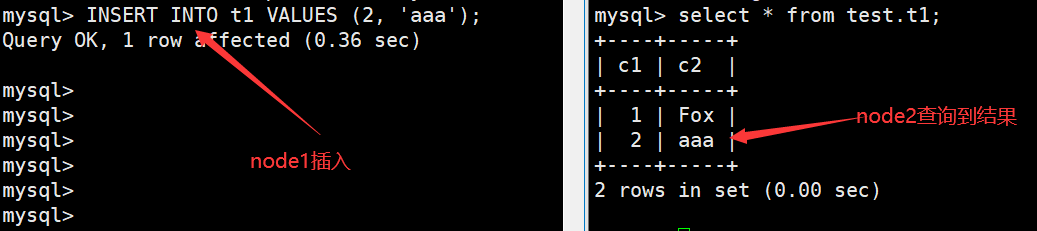
4) 测试
- mgr-node1插入数据,看mgr-node2是否可以查到
#mgr-node1
insert into test.t1 values (2, 'aaa');
#mgr-node2
select * from test.t1;
总结
到此这篇关于mysql8.0主从复制原理分析与实战指南的文章就介绍到这了,更多相关mysql8.0主从复制原理内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!





发表评论