
 我要评论
mysql 的索引类型可以从以下几个方面来讨论:
- 数据结构
- innodb 的存储方式
- 索引性质
一、数据结构
从数据结构的角度来分析,mysql 的索引类型可以分为:
- b+树索引:是 innodb 和 myisam 的默认索引,它是多层平衡树的一种结构,它的每个叶子节点之间是用链表相串联起来的,并且叶子节点保存了行数据,既能做快速定位,又能做范围性的扫描。
- 哈希索引:是 memory 引擎的默认索引,它是直接使用哈希函数算出一个数据位置,但是它不能做范围性的查询和排序。
- 全文索引:是把文本分词后建立的倒排索引,类似于搜索引擎的原理,适合对 text 文本进行搜索,比如关键字搜索和文本搜索。
- 空间索引:是基于 r 树实现的一种索引,适合对地理位置这种多维数据进行处理、计算、查询。
二、innodb 的存储方式
从 innodb 的存储方式来看,可以分为聚簇索引和非聚簇索引。
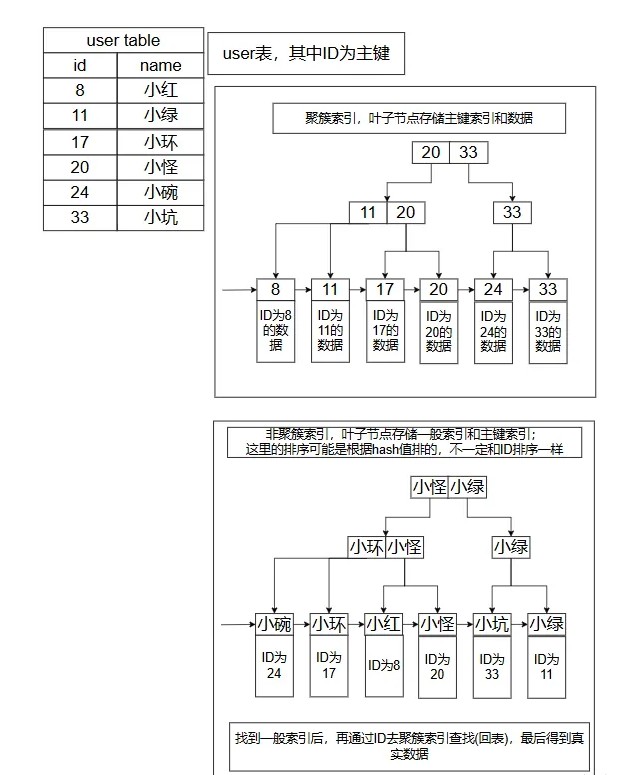
- 聚簇索引:是 innodb 的默认索引,主键索引就是聚簇索引,它的叶子节点存储的是行数据,而每一张表只有一个聚簇索引。
- 非聚簇索引:非聚簇索引又叫二级索引,叶子节点之间只存索引值和主键 id,通过二级索引进行查询,还需要先查出主键 id,然后拿着主键 id 再回到聚簇索引当中去查询对应的行数据,这个叫做回表操作。
在 innodb 引擎中,聚簇索引的叶子节点存储的是行数据,而一张表只能有一个聚簇索引,它默认就是主键索引。而非聚簇索引的叶子节点存储的是主键 id 和列值,非聚簇索引又被称为二级索引。
所以在 innodb 中,聚簇索引和非聚簇索引最大的区别就是叶子节点存储的数据不同。如果通过非聚簇索引进行查询,它可能会进行回表操作。回表操作就是如果先进行非聚簇索引查询,查到了对应的主键 id,再通过主键 id 去聚簇索引当中捞取对应的行数据,这个过程可能产生大量的随机性 io ,导致非聚簇索引的效率不如聚簇索引。
而如果要避免这种情况的发生,我们要通过建立联合索引,把要查询的字段放入到联合索引当中,产生覆盖索引,就可以直接从非聚簇索引当中查询到想要的数据,而不用再进行回表操作。
所以要避免使用select * ,需要什么字段就查什么字段,建立好合适的联合索引
三、从索引性质来分类
- 主键索引:主键索引就是聚簇索引,每个表只能有一个且唯一不能重复且非空。
- 唯一索引:唯一索引保证列值不重复,且数据可以为 null,而且可以有多个 null。
- 普通索引:可以重复,只是为了加速查询。
- 全文索引:文本搜索使用。
- 联合索引:需要匹配最左前缀原则,可以多个列值建立索引,列排序非常重要。
- 空间索引:gis 数据使用。
四、总结
以上为个人经验,希望能给大家一个参考,也希望大家多多支持代码网。





发表评论