
 我要评论
1. 基本查询回顾
在进入复合查询之前,我们首先回顾单表查询的基础操作,包括条件过滤、排序、聚合函数、分组与子查询等。
基于这个数据库和表
drop database if exists `scott`;
create database if not exists `scott` default character set utf8 collate utf8_general_ci;

use `scott`;

drop table if exists `dept`;
create table `dept` (
  `deptno` int(2) unsigned zerofill not null comment '部门编号',
  `dname` varchar(14) default null comment '部门名称',
  `loc` varchar(13) default null comment '部门所在地点'
);


drop table if exists `emp`;
create table `emp` (
  `empno` int(6) unsigned zerofill not null comment '雇员编号',
  `ename` varchar(10) default null comment '雇员姓名',
  `job` varchar(9) default null comment '雇员职位',
  `mgr` int(4) unsigned zerofill default null comment '雇员领导编号',
  `hiredate` datetime default null comment '雇佣时间',
  `sal` decimal(7,2) default null comment '工资月薪',
  `comm` decimal(7,2) default null comment '奖金',
  `deptno` int(2) unsigned zerofill default null comment '部门编号'
);


drop table if exists `salgrade`;
create table `salgrade` (
  `grade` int(11) default null comment '等级',
  `losal` int(11) default null comment '此等级最低工资',
  `hisal` int(11) default null comment '此等级最高工资'
);


insert into dept (deptno, dname, loc)
values (10, 'accounting', 'new york');
insert into dept (deptno, dname, loc)
values (20, 'research', 'dallas');
insert into dept (deptno, dname, loc)
values (30, 'sales', 'chicago');
insert into dept (deptno, dname, loc)
values (40, 'operations', 'boston');

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7369, 'smith', 'clerk', 7902, '1980-12-17', 800, null, 20);

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7499, 'allen', 'salesman', 7698, '1981-02-20', 1600, 300, 30);

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7521, 'ward', 'salesman', 7698, '1981-02-22', 1250, 500, 30);

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7566, 'jones', 'manager', 7839, '1981-04-02', 2975, null, 20);

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7654, 'martin', 'salesman', 7698, '1981-09-28', 1250, 1400, 30);

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7698, 'blake', 'manager', 7839, '1981-05-01', 2850, null, 30);

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7782, 'clark', 'manager', 7839, '1981-06-09', 2450, null, 10);

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7788, 'scott', 'analyst', 7566, '1987-04-19', 3000, null, 20);

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7839, 'king', 'president', null, '1981-11-17', 5000, null, 10);

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7844, 'turner', 'salesman', 7698,'1981-09-08', 1500, 0, 30);

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7876, 'adams', 'clerk', 7788, '1987-05-23', 1100, null, 20);

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7900, 'james', 'clerk', 7698, '1981-12-03', 950, null, 30);

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7902, 'ford', 'analyst', 7566, '1981-12-03', 3000, null, 20);

insert into emp (empno, ename, job, mgr, hiredate, sal, comm, deptno)
values (7934, 'miller', 'clerk', 7782, '1982-01-23', 1300, null, 10);

insert into salgrade (grade, losal, hisal) values (1, 700, 1200);
insert into salgrade (grade, losal, hisal) values (2, 1201, 1400);
insert into salgrade (grade, losal, hisal) values (3, 1401, 2000);
insert into salgrade (grade, losal, hisal) values (4, 2001, 3000);
insert into salgrade (grade, losal, hisal) values (5, 3001, 9999);
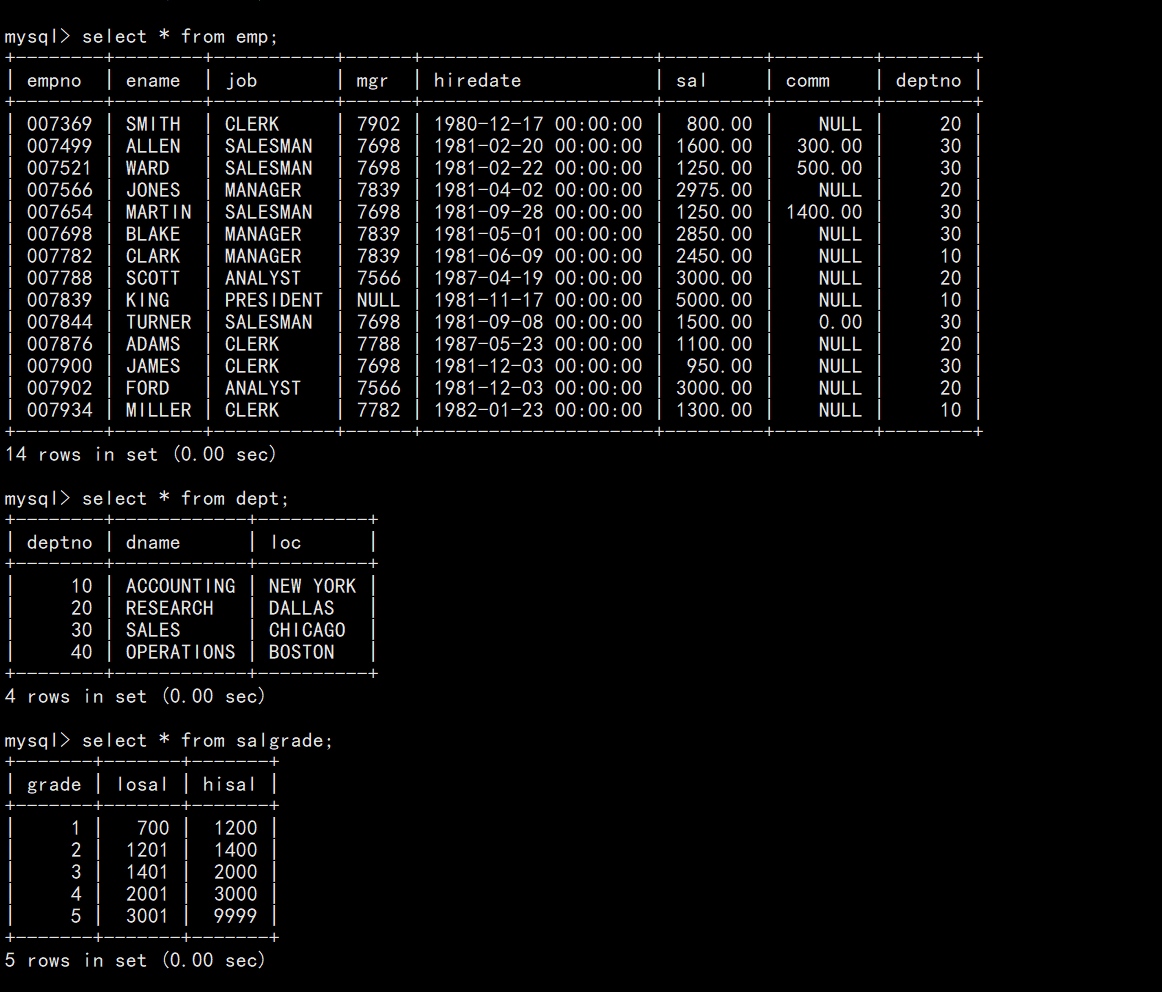
示例:
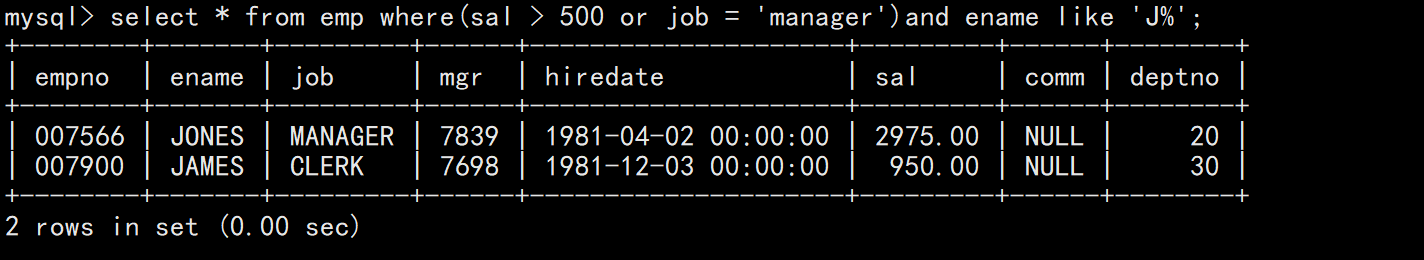
查询工资高于500或职位为manager,且姓名以j开头的员工:
select * from emp where (sal > 500 or job = 'manager') and ename like 'j%';
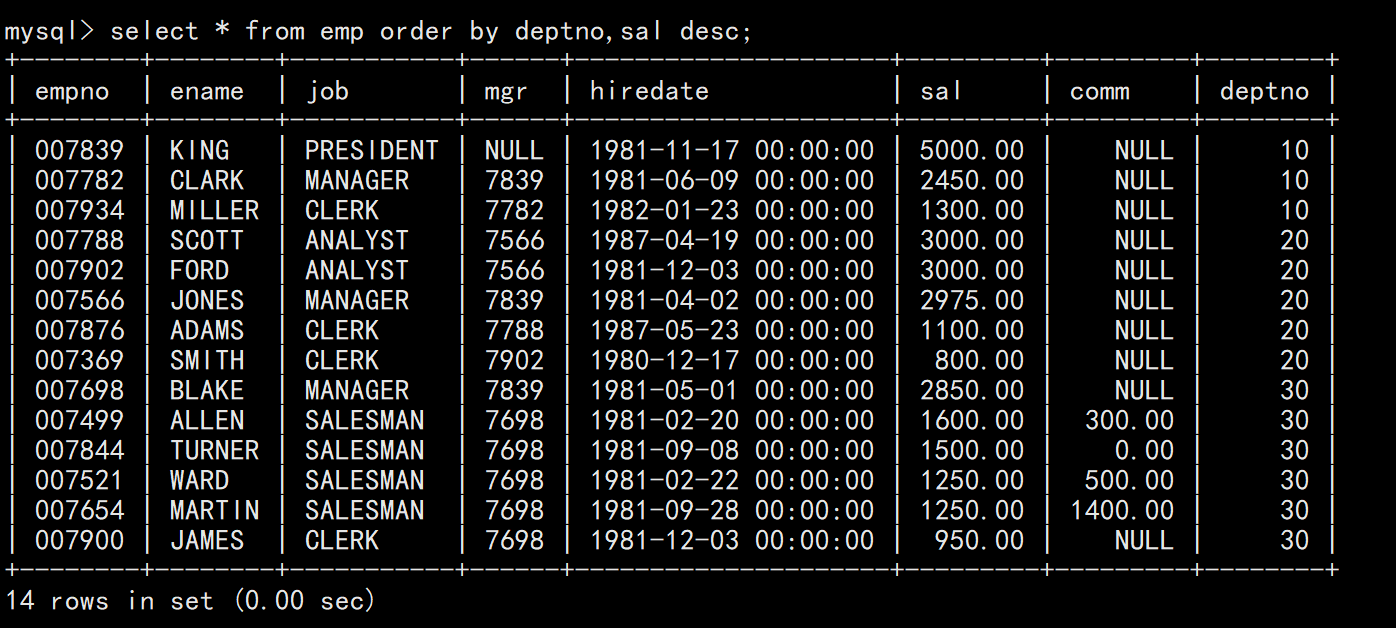
按部门升序、工资降序排序:
select * from emp order by deptno, sal desc;
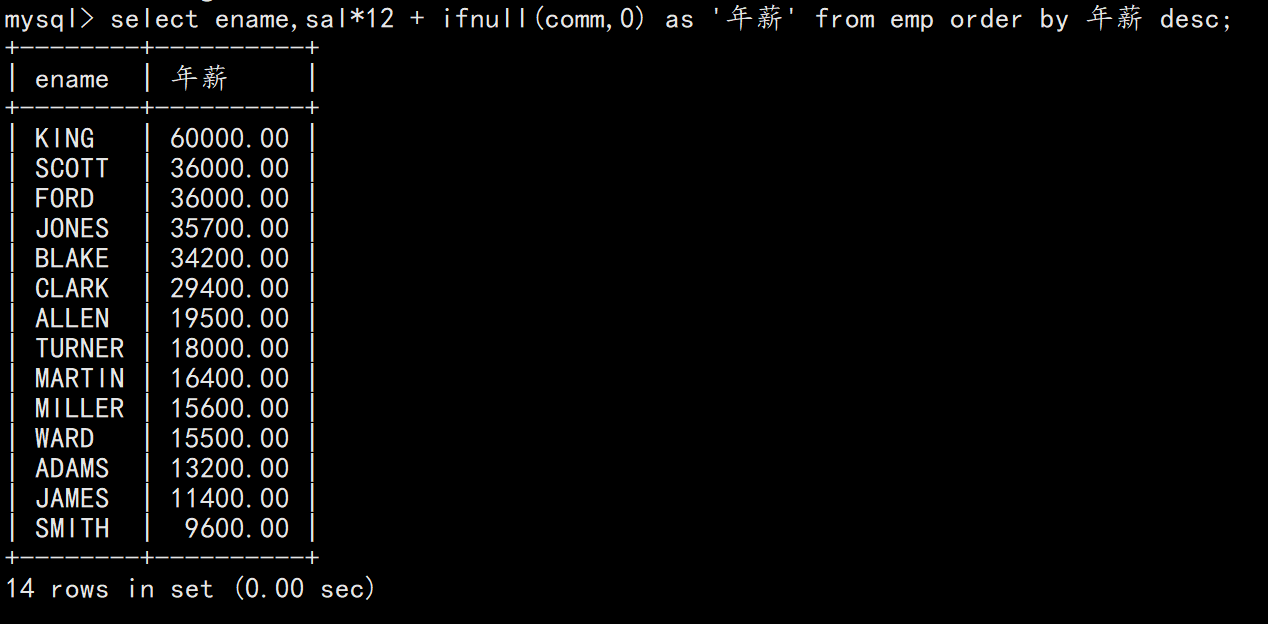
显示年薪(含奖金)并降序排序:
select ename,sal*12 + ifnull(comm,0) as '年薪' from emp order by 年薪 desc;
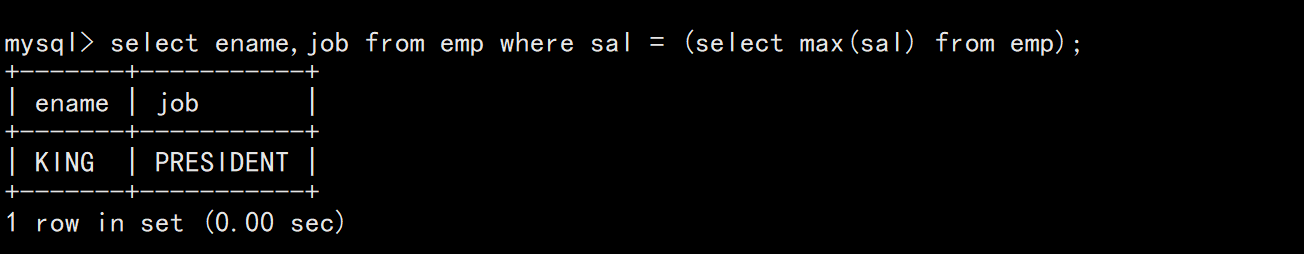
显示工资最高的员工:
select ename, job from emp where sal = (select max(sal) from emp);
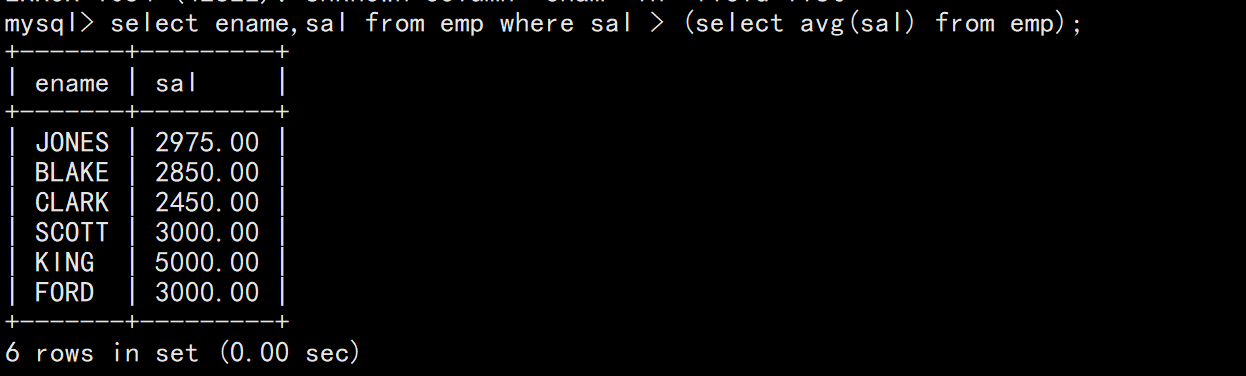
显示高于平均工资的员工:
select ename,sal from emp where sal > (select avg(sal) from emp);
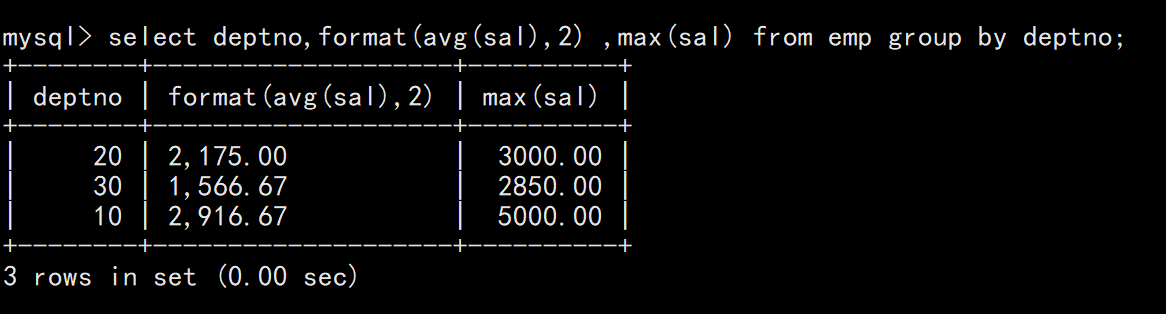
显示每个部门的平均工资和最高工资:
select deptno,format(avg(sal),2) ,max(sal) from emp group by deptno;
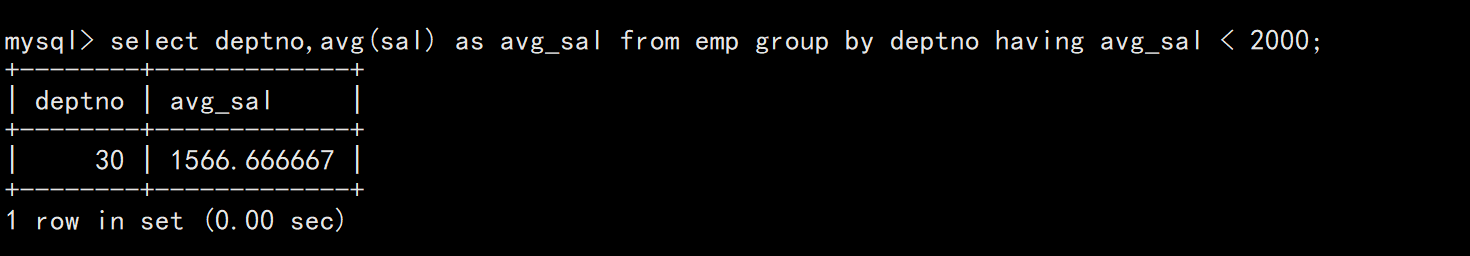
显示平均工资低于2000的部门:
select deptno,avg(sal) as avg_sal from emp group by deptno having avg_sal < 2000;
<img alt="" src="https://i-blog.csdnimg.cn/direct/299e0ef55c7b431eaae5988591835f3e.png" />
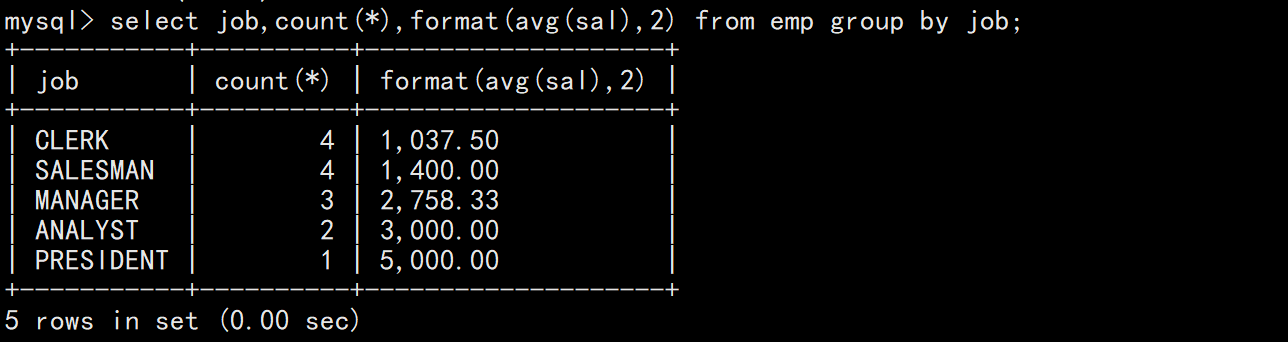
显示每种岗位的雇员总数和平均工资:
select job,count(*),format(avg(sal),2) from emp group by job;
2. 多表查询(重点)
多表查询用于从多个表中获取数据,通常通过连接条件避免笛卡尔积。
实际开发中往往数据来自不同的表,所以需要多表查询。本节我们用一个简单的公司管理系统,有三张表emp,dept,salgrade来演示如何进行多表查询。
2.1 笛卡尔积
案例:
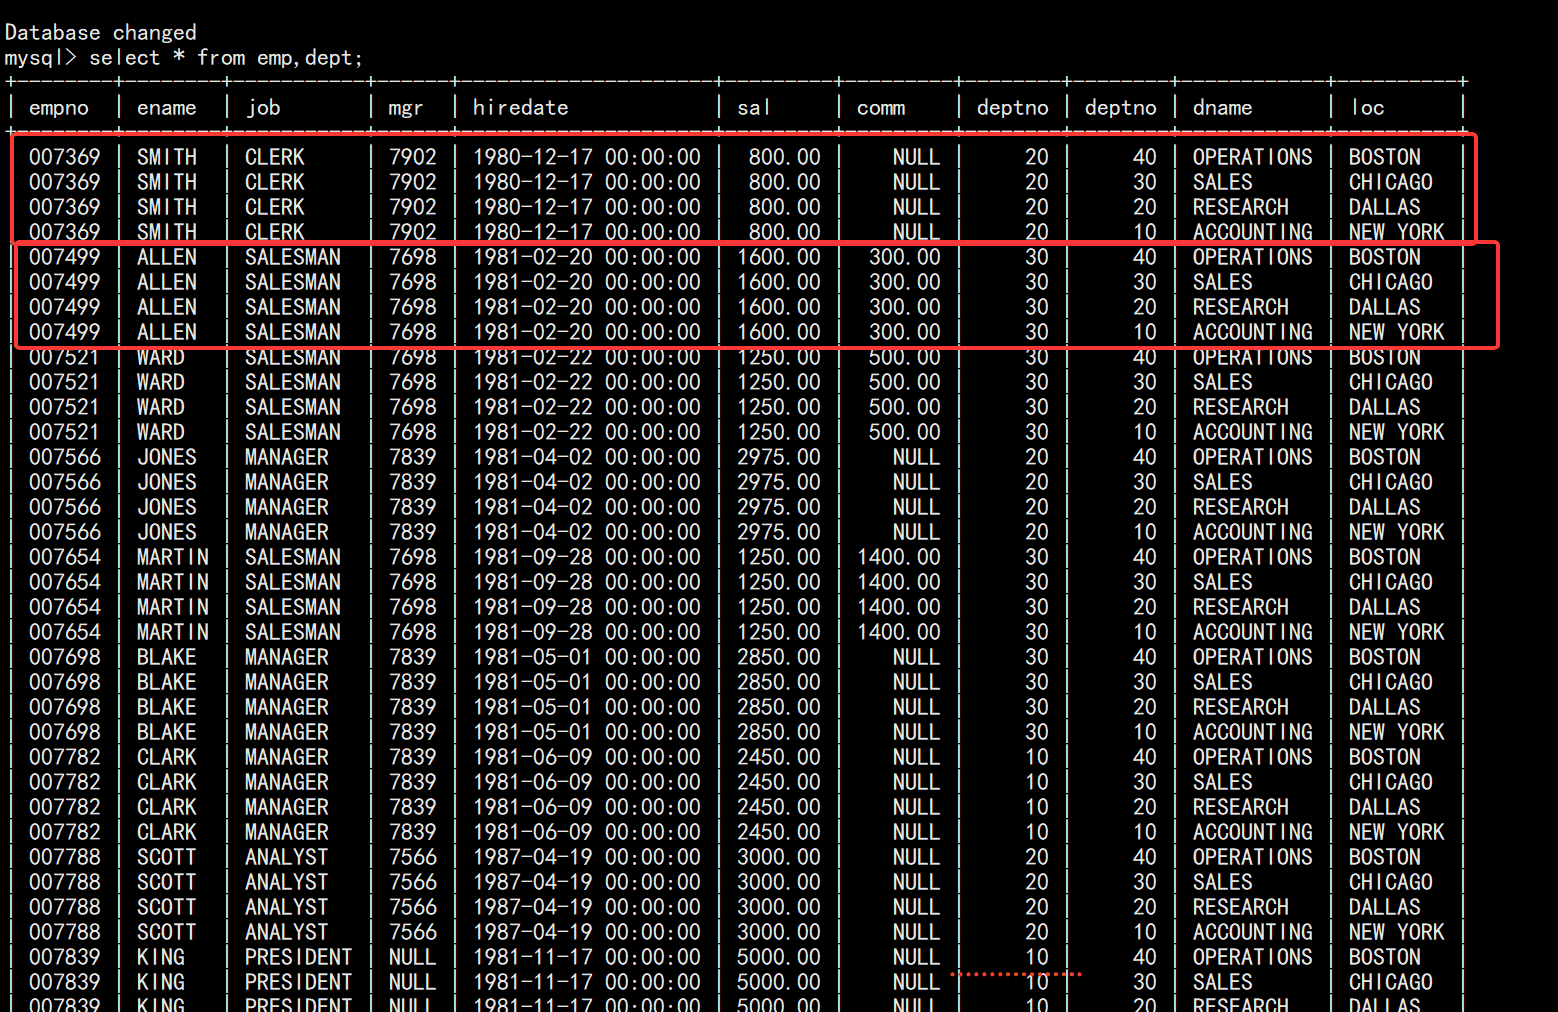
显示雇员名、雇员工资以及所在部门的名字因为上面的数据来自emp和dept表,因此要联合查询。
当不指定连接条件时,两张表的每一行都会组合,产生大量无用数据。
2.2 等值连接
通过连接条件过滤出有效数据。
示例:
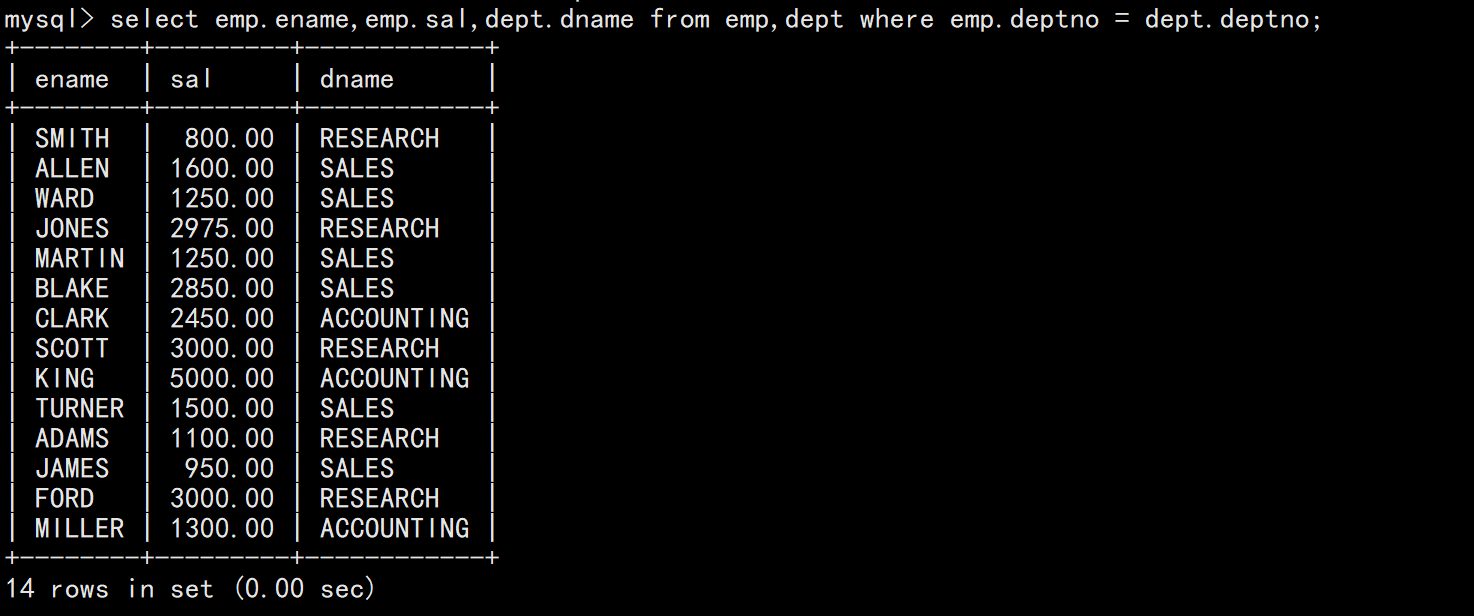
显示雇员名、工资和所在部门名:
select emp.ename,emp.sal,dept.dname from emp,dept where emp.deptno = dept.deptno;

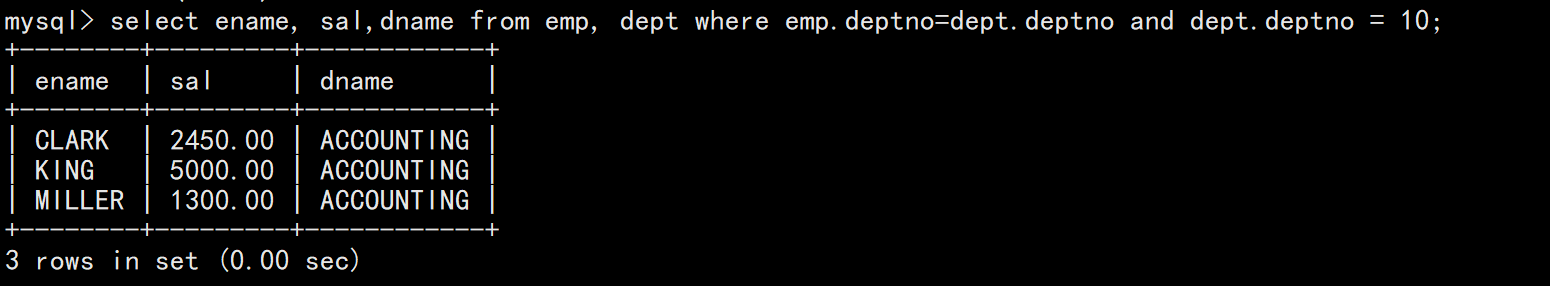
显示部门号为10的部门名、员工名和工资:
select ename, sal,dname from emp, dept where emp.deptno=dept.deptno and dept.deptno = 10;
显示员工姓名、工资和工资级别(根据salgrade表):
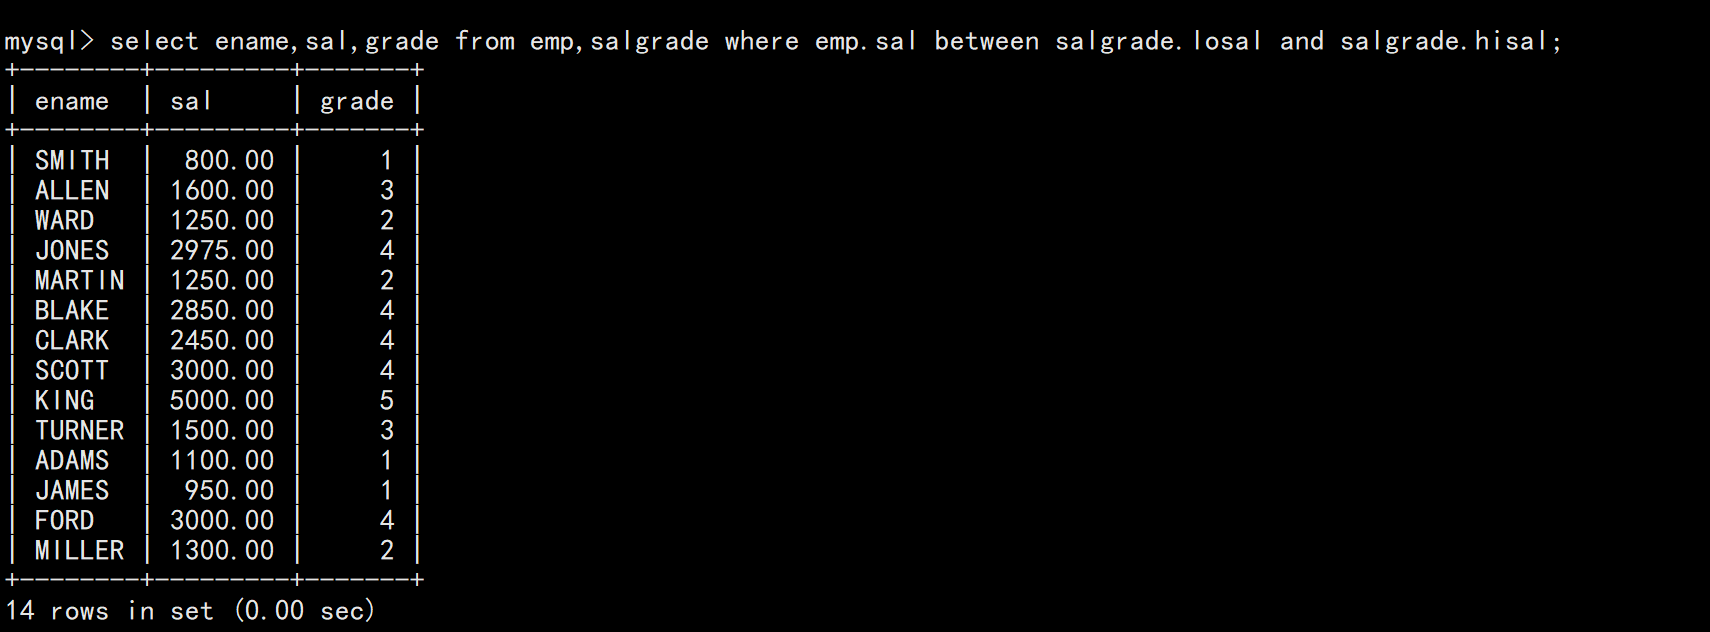
select ename,sal,grade from emp,salgrade where emp.sal between salgrade.losal and salgrade.hisal;
3. 自连接
自连接是指在同一张表内进行连接查询,常用于查找表中记录之间的层级关系。
示例:
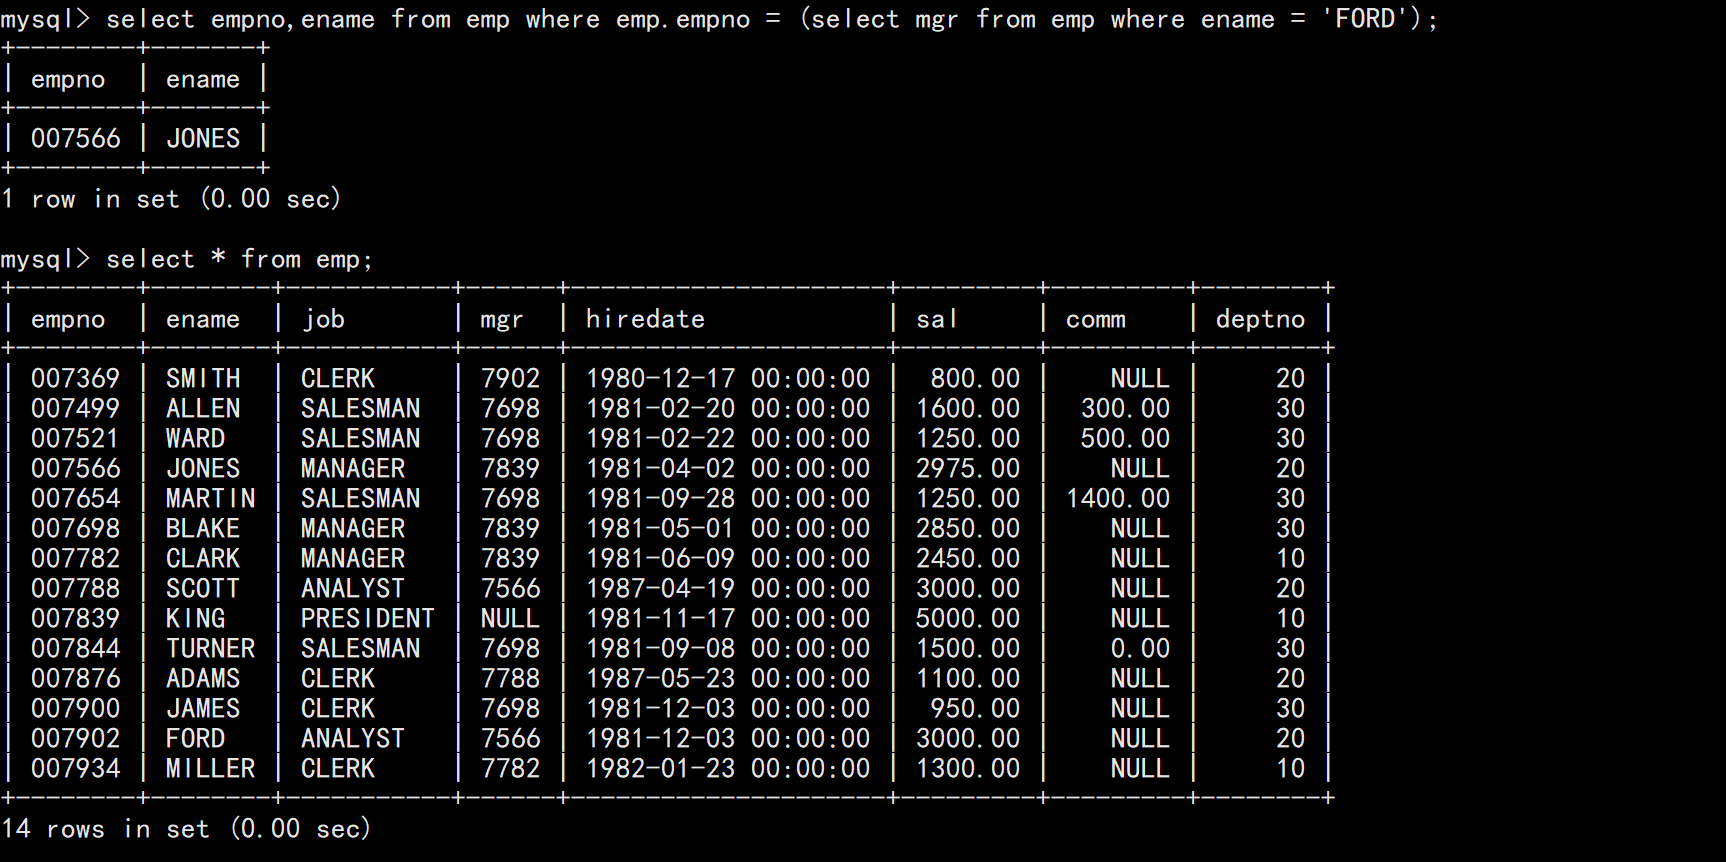
查找员工'ford'的上级领导编号和姓名 (mgr 是员工领导的编号 -- empno)
使用的子查询:
select empno,ename from emp where emp.empno = (select mgr from emp where ename = 'ford');
使用多表查询(自查询)
--from emp leader, emp worker,给自己的表起别名,因为要先做笛卡尔积,所以别名可以先识别

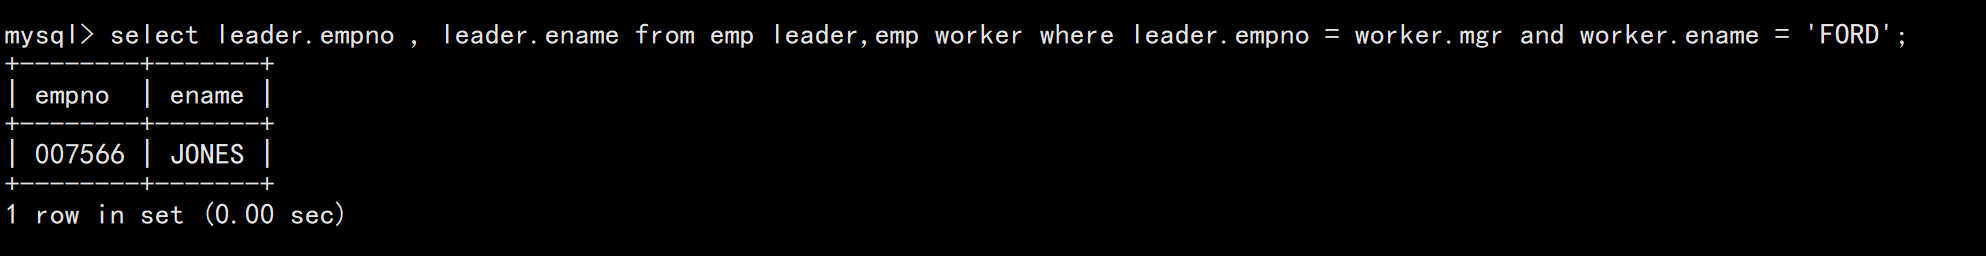
select leader.empno , leader.ename from emp leader,emp worker where leader.empno = worker.mgr and worker.ename = 'ford';
4. 子查询
子查询是嵌套在其他sql语句中的查询,分为单行、多行、多列子查询。
4.1 单行子查询
返回一行一列的数据。
示例:
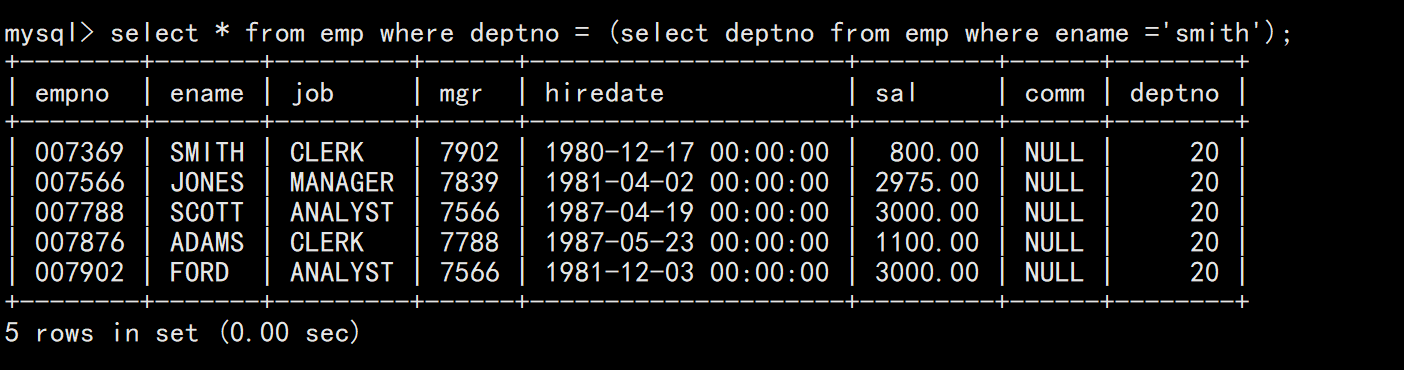
显示与 smith 同一部门的员工:
select * from emp where deptno = (select deptno from emp where ename ='smith');
4.2 多行子查询
使用in、any、all关键字。
示例:
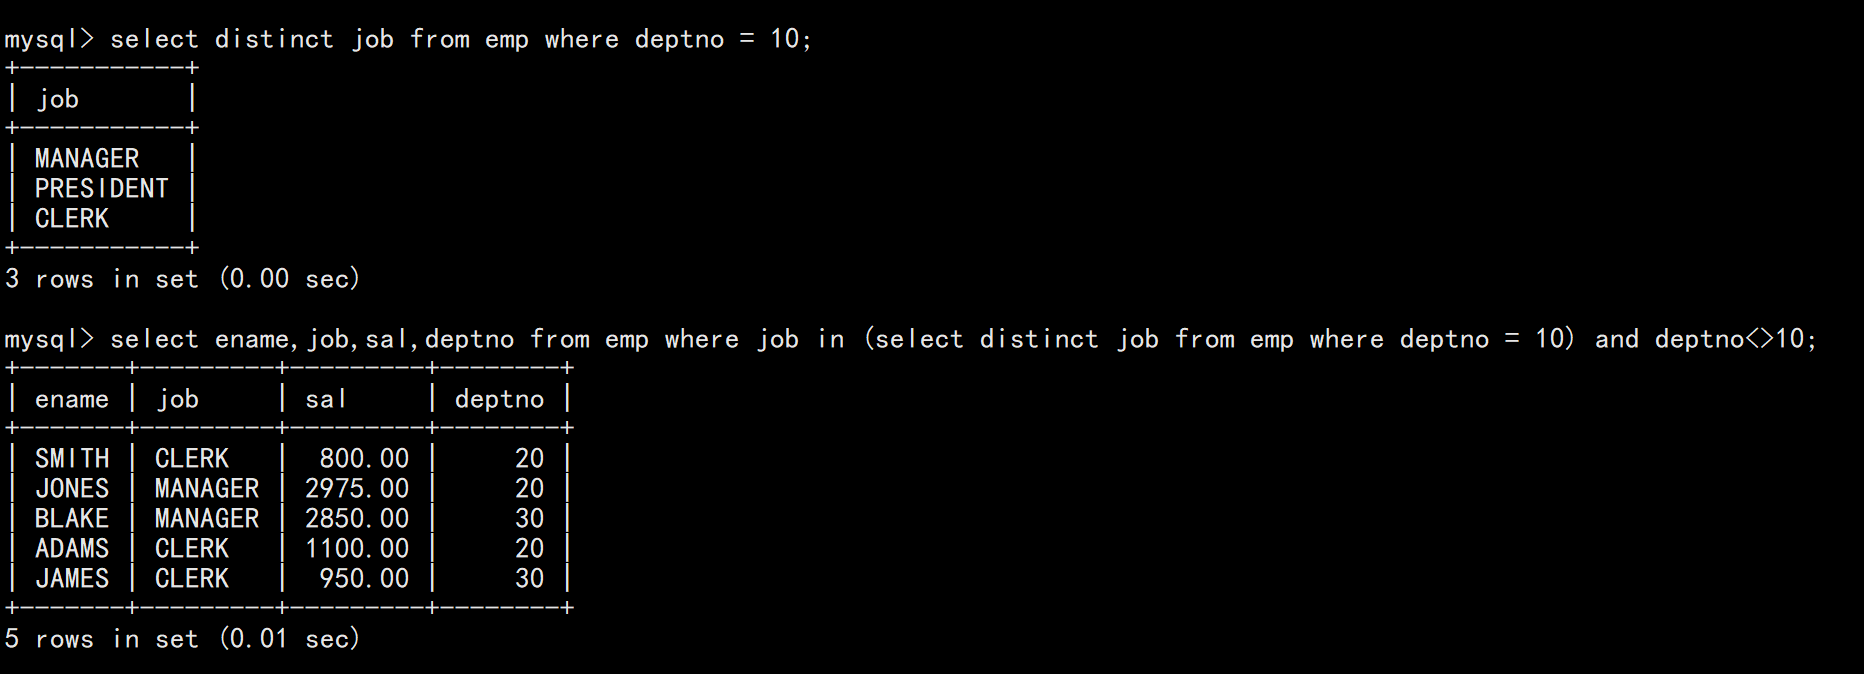
查询和 10 号部门的 工作岗位相同 的雇员的名字,岗位,工资,部门号,但是 不包含10号部门自己的员工 。
select ename,job,sal,deptno from emp where job in (select distinct job from emp where deptno = 10) and deptno<>10;
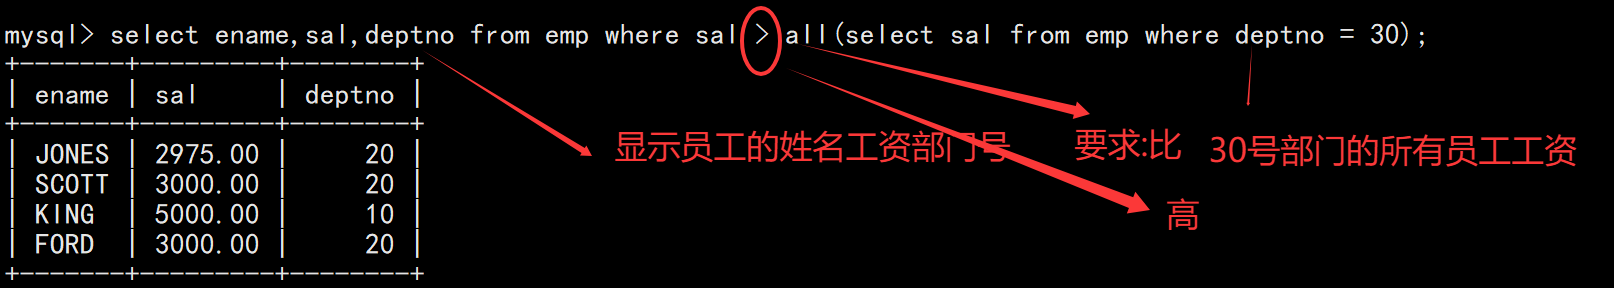
显示工资比部门30的所有员工的工资高的员工的姓名、工资和部门号
select ename,sal,deptno from emp where sal > all(select sal from emp where deptno = 30);
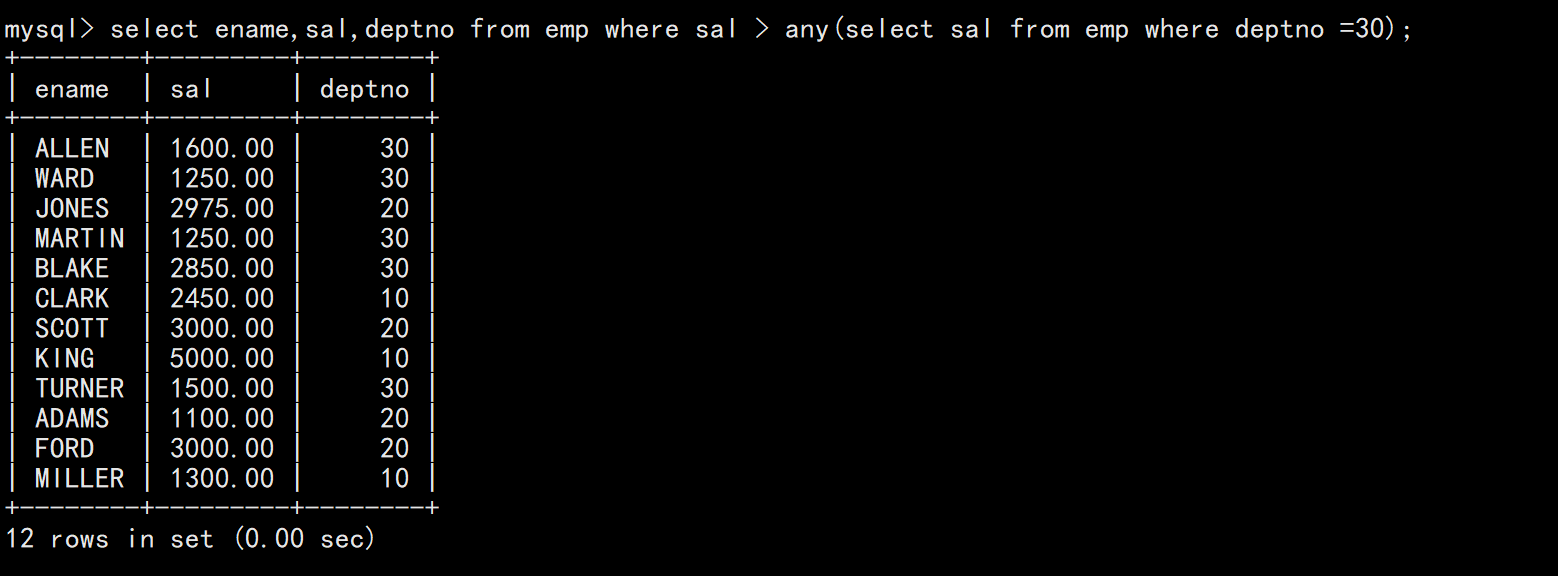
显示工资比部门30的 任意 员工的工资高的员工的姓名、工资和部门号(包含自己部门的员工)
4.3 多列子查询
单行子查询是指子查询只返回单列,单行数据;多行子查询是指返回单列多行数据,都是针对单列而言的,而多列子查询则是指查询返回多个列数据的子查询语句。
示例:
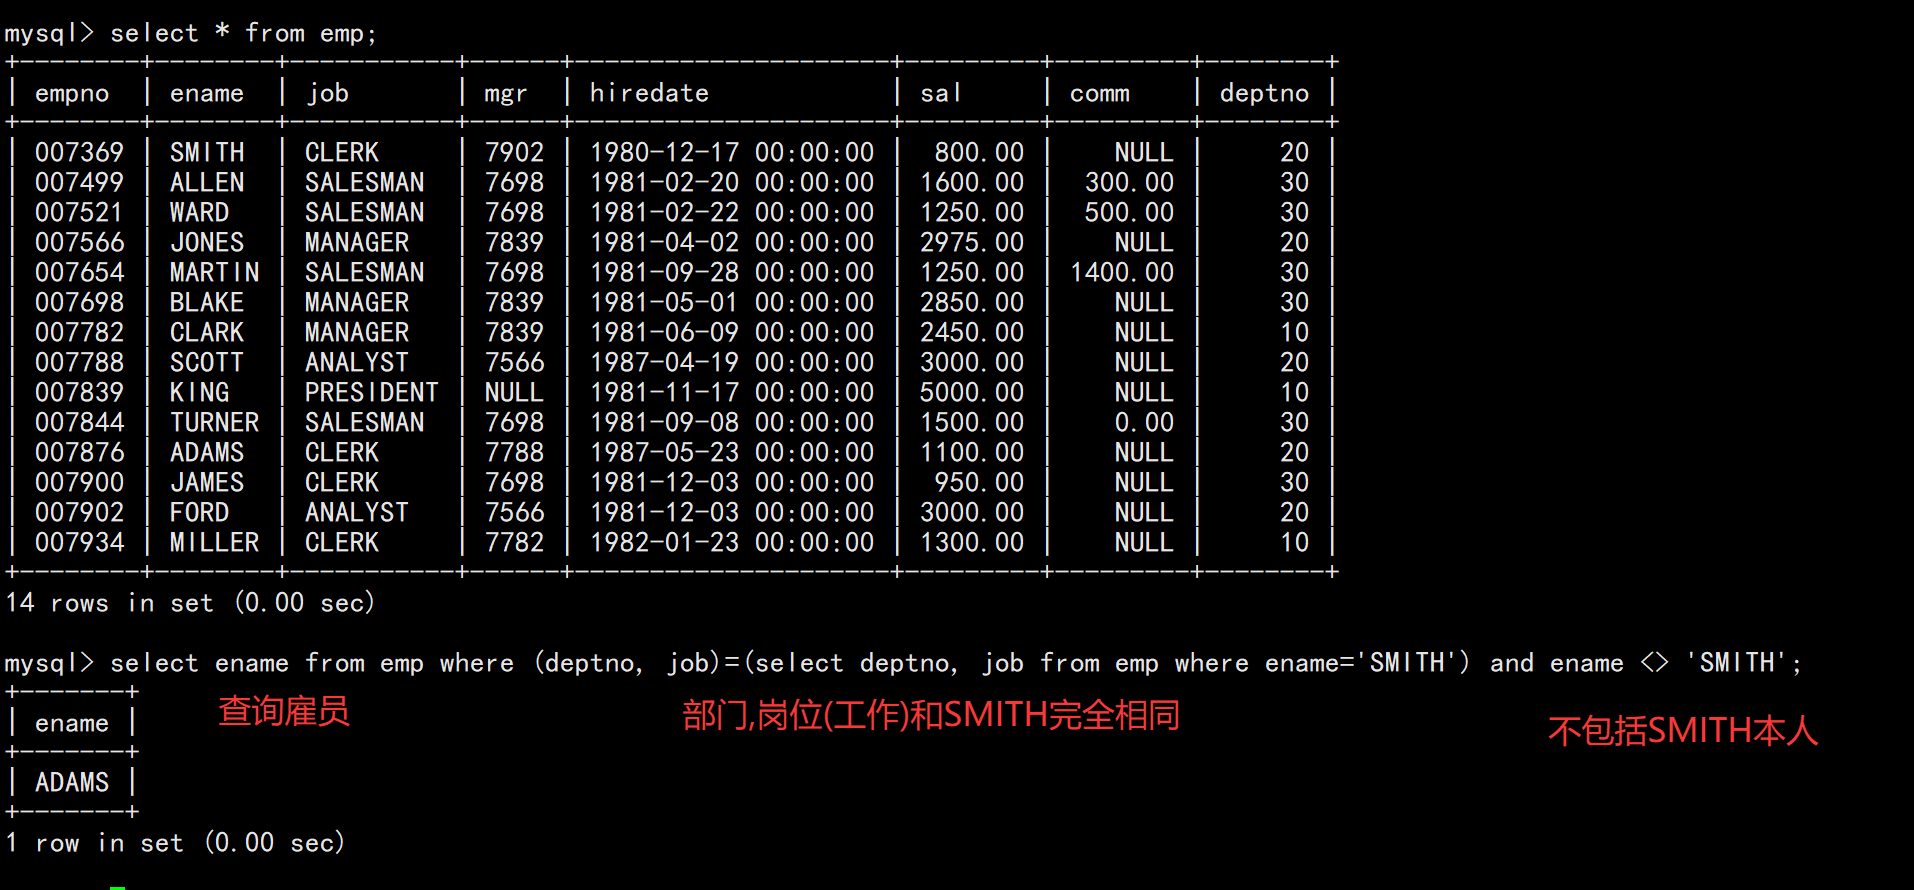
查询与smith部门和岗位相同的员工(不包括smith):
select ename from emp where (deptno, job)=(select deptno, job from emp where ename='smith') and ename <> 'smith';
5. from子句中的子查询(派生表)
子查询语句出现在from子句中。这里要用到数据查询的技巧,把一个子查询当做一个临时表使用。
示例:
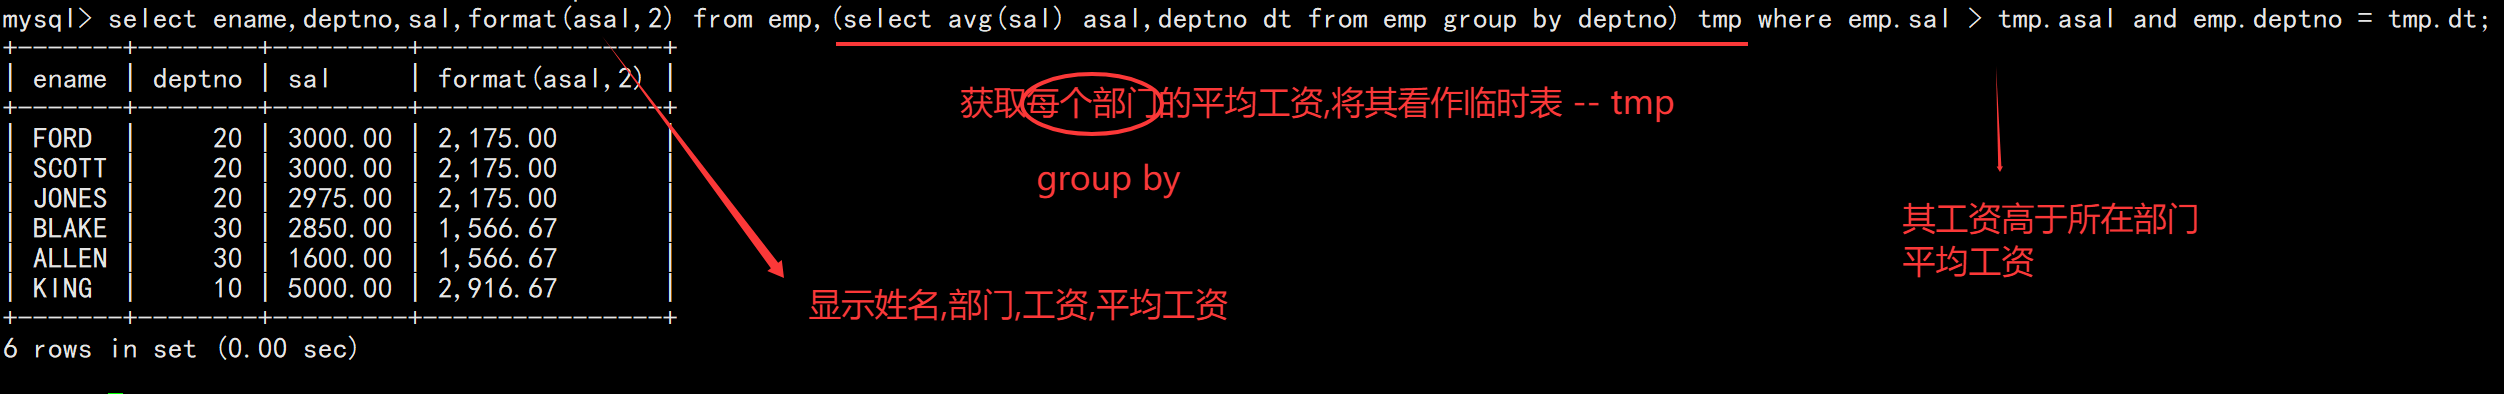
显示每个高于自己部门平均工资的员工的姓名、部门、工资、平均工资
select ename,deptno,sal,format(asal,2) from emp,
(select avg(sal) asal,deptno dt from emp group by deptno) tmp
where emp.sal > tmp.asal and emp.deptno = tmp.dt;
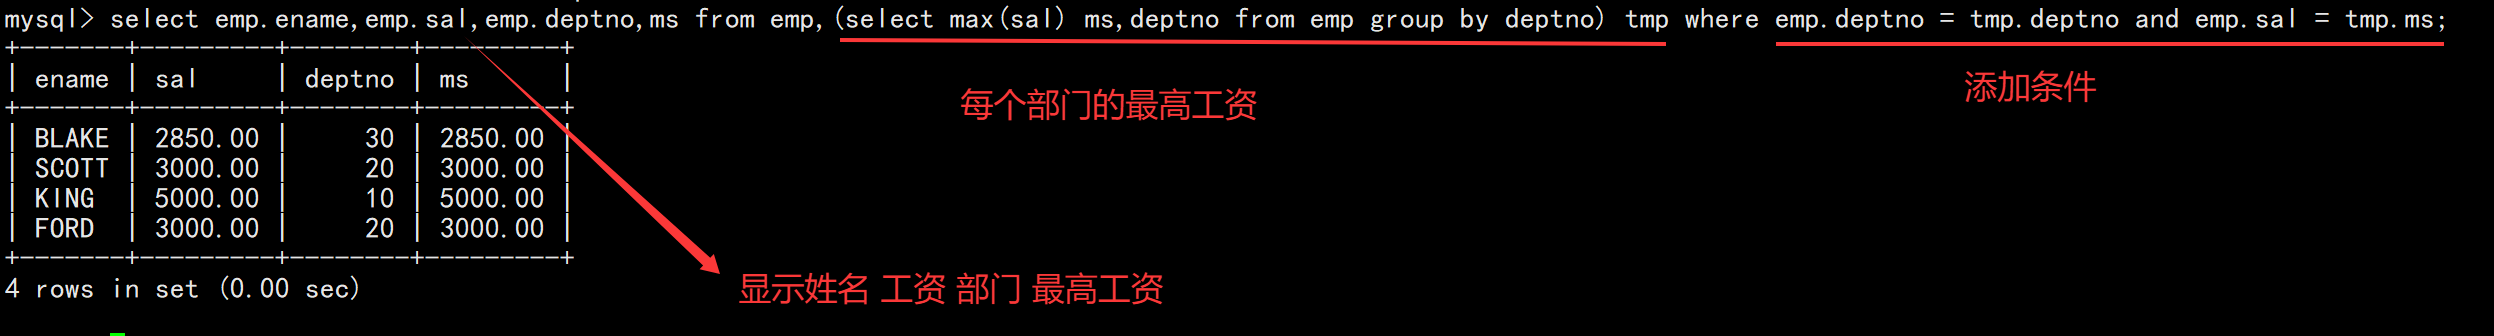
查找每个部门工资最高的人的姓名、工资、部门、最高工资
select emp.ename,emp.sal,emp.deptno,ms from emp,
(select max(sal) ms,deptno from emp group by deptno) tmp
where emp.deptno = tmp.deptno and emp.sal = tmp.ms;
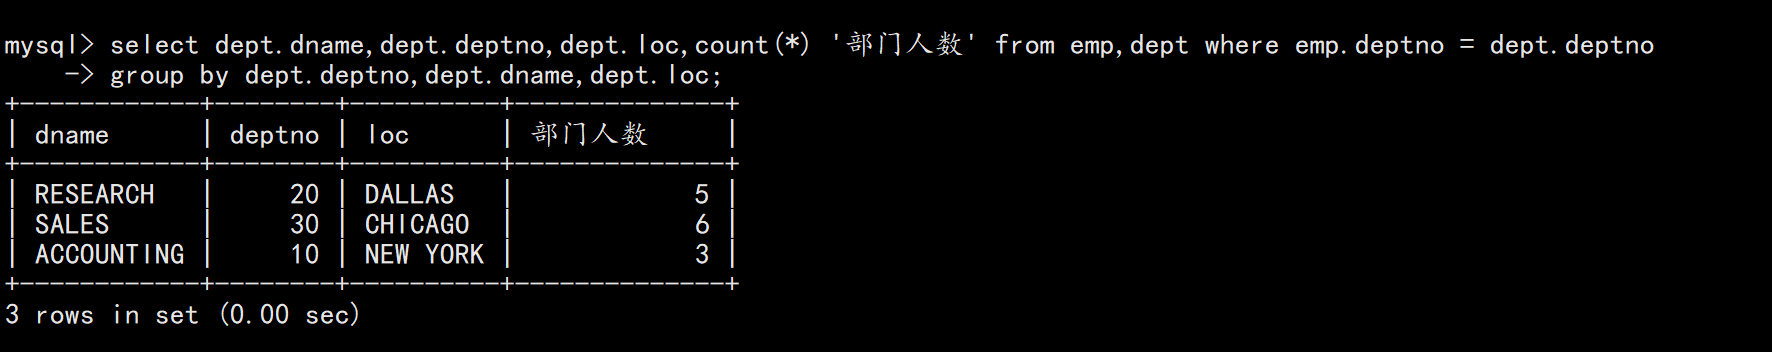
显示每个部门的信息(部门名,编号,地址)及人员数量:
方法1:使用多表
select dept.dname,dept.deptno,dept.loc,count(*) '部门人数' from emp,dept
where emp.deptno = dept.deptno group by dept.deptno,dept.dname,dept.loc;
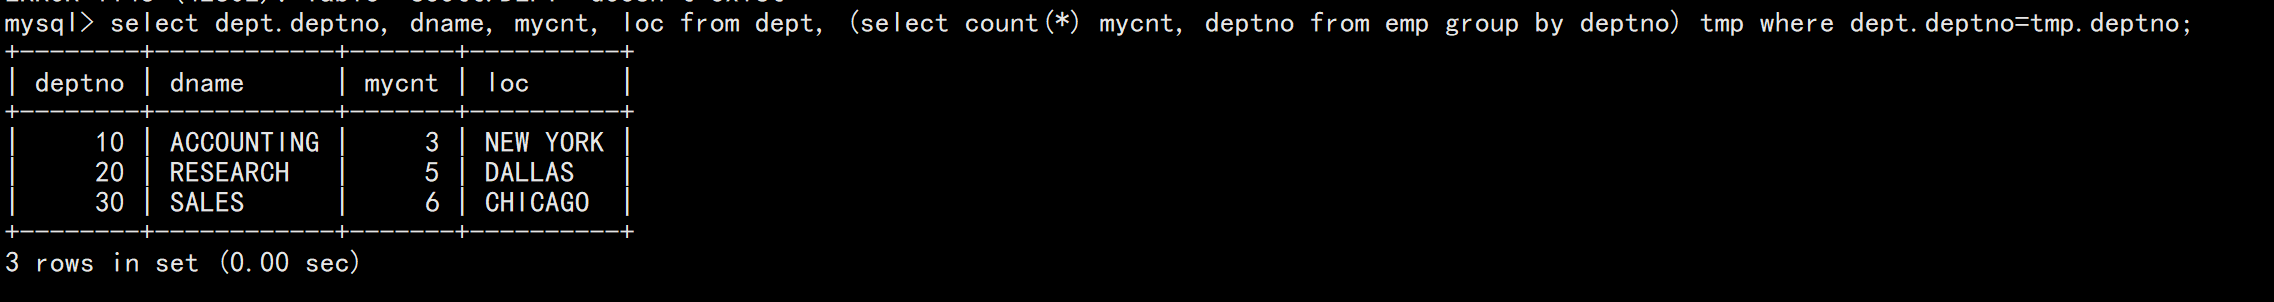
方法2:使用子查询
select dept.deptno, dname, mycnt, loc from dept,
(select count(*) mycnt, deptno from emp group by deptno) tmp
where dept.deptno=tmp.deptno;
6. 合并查询
用于合并多个select语句的结果,支持 union 和 union all。
6.1 union
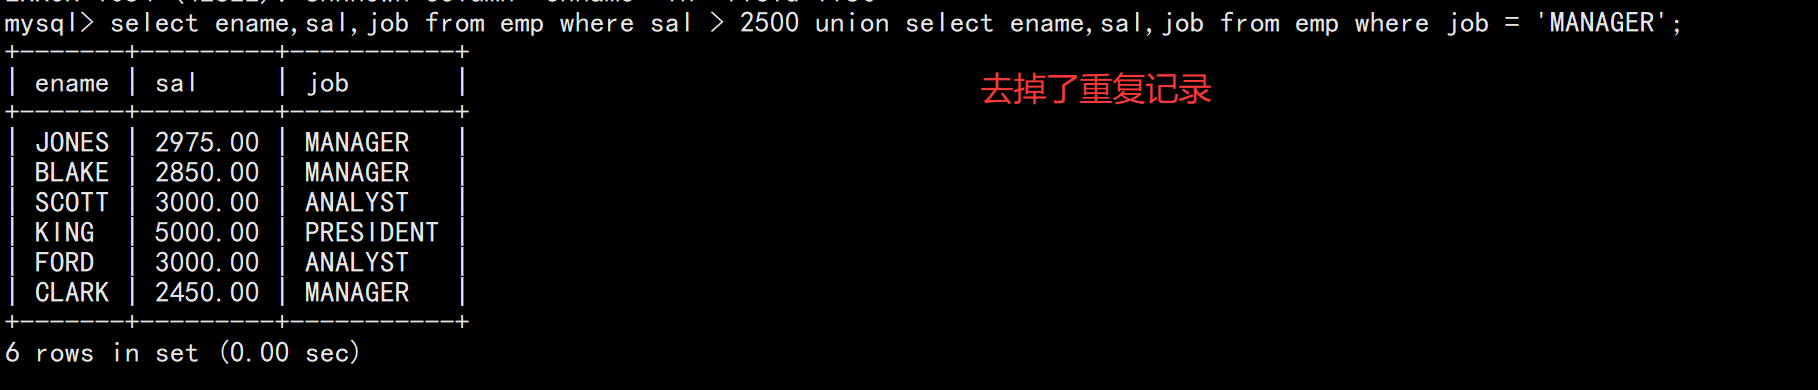
该操作符用于取得两个结果集的并集。当使用该操作符时,会自动去掉结果集中的重复行。
示例:
查询工资大于2500或职位为manager的员工:
select ename,sal,job from emp where sal > 2500 union select ename,sal,job from emp where job = 'manager';
6.2 union all
该操作符用于取得两个结果集的并集。当使用该操作符时,不会去掉结果集中的重复行。
示例:
不去重地合并两个查询结果:
select ename,sal,job from emp where sal > 2500 union all select ename,sal,job from emp where job = 'manager';
7.总结
复合查询是mysql中非常重要的部分,主要包括:
多表连接(等值连接、自连接)。
子查询(单行、多行、多列、派生表)。
合并查询(union、union all)。
掌握这些查询技巧可以高效地从多个表中提取复杂数据,是数据库开发与数据分析的基础能力。
8.oj题目练习
select s1.emp_no , s1.salary from salaries s1
where s1.from_date = (select min(s2.from_date) from salaries s2
        where s2.emp_no = s1.emp_no group by s2.emp_no)
order by s1.emp_no desc
获取所有非manager的员工emp_no_牛客题霸_牛客网
select employees.emp_no from employees where
employees.emp_no not in(select  emp_no from dept_manager);
select dept_emp.emp_no,dept_manager.emp_no as manager from dept_emp,dept_manager
where dept_emp.dept_no = dept_manager.dept_no and
dept_emp.emp_no not in(select emp_no from dept_manager);
到此这篇关于mysql复合查询的文章就介绍到这了,更多相关mysql复合查询内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!




发表评论