
 我要评论
目录
1.初识elasticsearch
elasticsearch的官方网站如下🔍:
https://www.elastic.co/cn/elasticsearch/
📖 本章我们一起来初步了解一下elasticsearch的基本原理和一些基础概念。
1.1.认识和安装
elasticsearch是由elastic公司开发的一套搜索引擎技术,它是elastic技术栈中的一部分。完整的技术栈包括:
❇️ elasticsearch:用于数据存储、计算和搜索 🔍
❇️ logstash/beats:用于数据收集 📊
❇️ kibana:用于数据可视化 🌐
整套技术栈被称为elk,经常用来做日志收集、系统监控和状态分析等等:
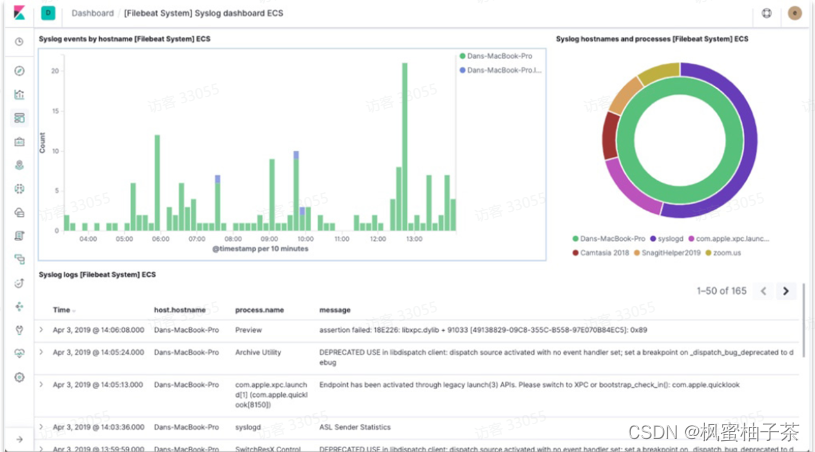
整套技术栈的核心就是用来存储、搜索、计算的elasticsearch,因此我们接下来学习的核心也是elasticsearch。
我们要安装的内容包含2部分:
⏏️ elasticsearch:存储、搜索和运算
⏏️ kibana:图形化展示
首先elasticsearch不用多说,是提供核心的数据存储、搜索、分析功能的。
然后是kibana,elasticsearch对外提供的是restful风格的api,任何操作都可以通过发送http请求来完成。不过http请求的方式、路径、还有请求参数的格式都有严格的规范。这些规范我们肯定记不住,因此我们要借助于kibana这个服务。
kibana是elastic公司提供的用于操作elasticsearch的可视化控制台。它的功能非常强大,包括:
-
对elasticsearch数据的搜索、展示
-
对elasticsearch数据的统计、聚合,并形成图形化报表、图形
-
对elasticsearch的集群状态监控
-
它还提供了一个开发控制台(devtools),在其中对elasticsearch的restful的api接口提供了语法提示
1.1.1.安装elasticsearch
通过下面的docker命令即可安装单机版本的elasticsearch:
docker run -d \
  --name es \
  -e "es_java_opts=-xms512m -xmx512m" \
  -e "discovery.type=single-node" \
  -v es-data:/usr/share/elasticsearch/data \
  -v es-plugins:/usr/share/elasticsearch/plugins \
  --privileged \
  --network hm-net \
  -p 9200:9200 \
  -p 9300:9300 \
elasticsearch:7.12.1注意,这里我们采用的是elasticsearch的7.12.1版本,由于8以上版本的javaapi变化很大,在企业中应用并不广泛,企业中应用较多的还是8以下的版本。
如果拉取镜像困难,可以直接导入课前资料提供的镜像tar包:
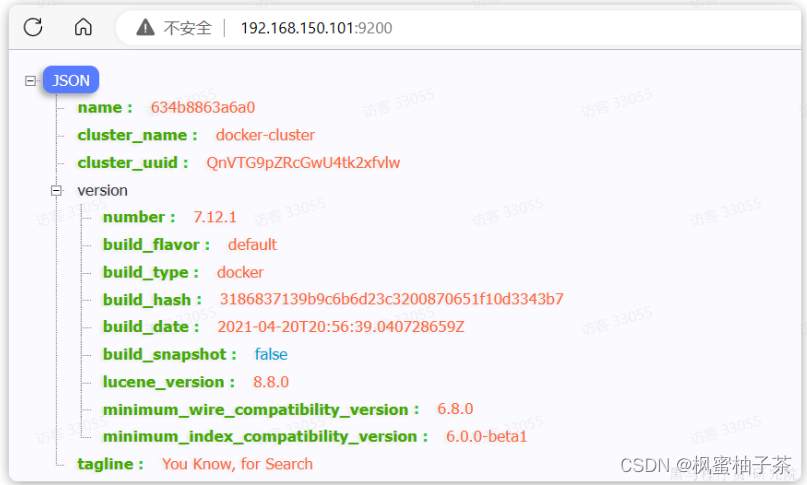
安装完成后,访问9200端口,即可看到响应的elasticsearch服务的基本信息:
1.1.2.安装kibana
通过下面的docker命令,即可部署kibana:
docker run -d \
--name kibana \
-e elasticsearch_hosts=http://es:9200 \
--network=hm-net \
-p 5601:5601  \
kibana:7.12.1
如果拉取镜像困难,可以直接导入课前资料提供的镜像tar包:

安装完成后,直接访问5601端口,即可看到控制台页面: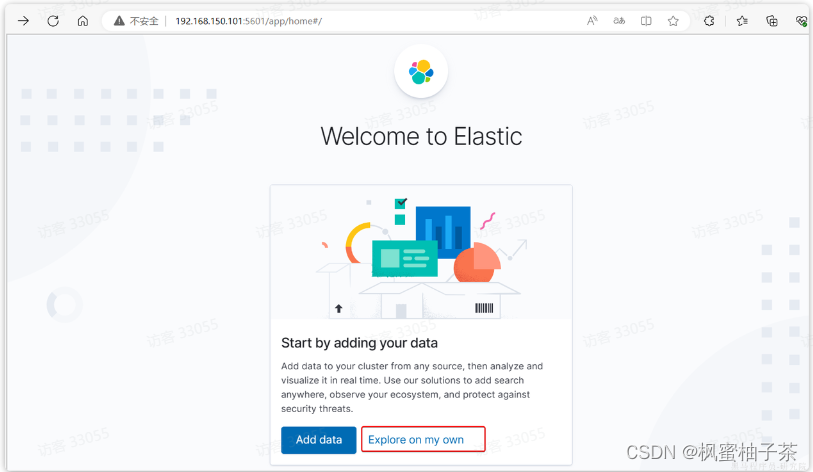
选择explore on my own之后,进入主页面:
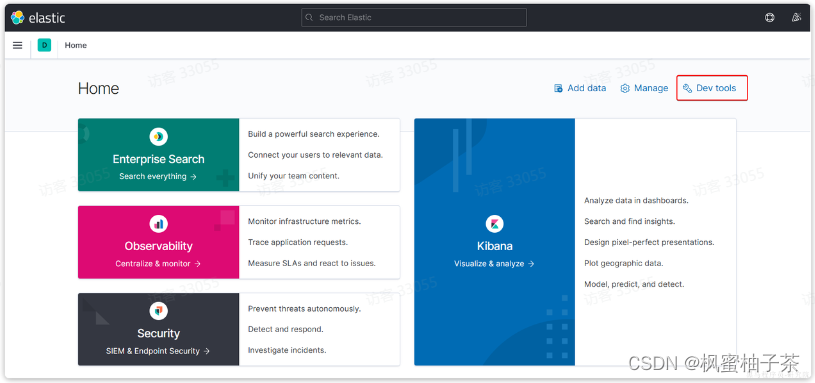
然后选中dev tools,进入开发工具页面:
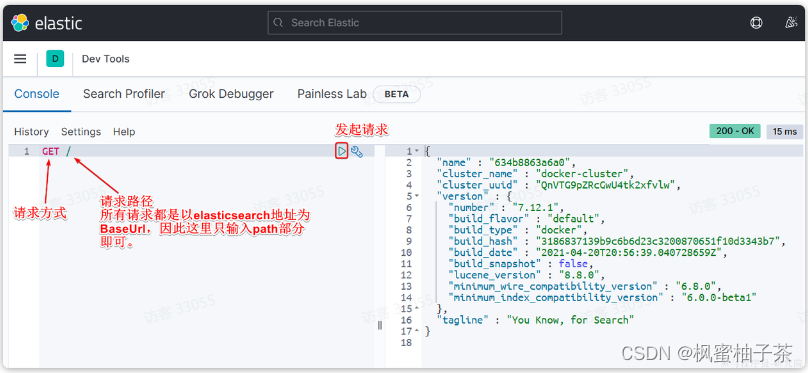
1.2.倒排索引
elasticsearch之所以有如此高性能的搜索表现,正是得益于底层的倒排索引技术。那么什么是倒排索引呢?
倒排索引的概念是基于mysql这样的正向索引而言的。
1.2.1.正向索引
我们先来回顾一下正向索引。
例如有一张名为tb_goods的表:
| id | title | price |
|---|---|---|
| 1 | 小米手机 | 3499 |
| 2 | 华为手机 | 4999 |
| 3 | 华为小米充电器 | 49 |
| 4 | 小米手环 | 49 |
| ... | ... | ... |
其中的id字段已经创建了索引,由于索引底层采用了b+树结构,因此我们根据id搜索的速度会非常快。但是其他字段例如title,只在叶子节点上存在。
因此要根据title搜索的时候只能遍历树中的每一个叶子节点,判断title数据是否符合要求。
比如用户的sql语句为:
select * from tb_goods where title like '%手机%';那搜索的大概流程如图:
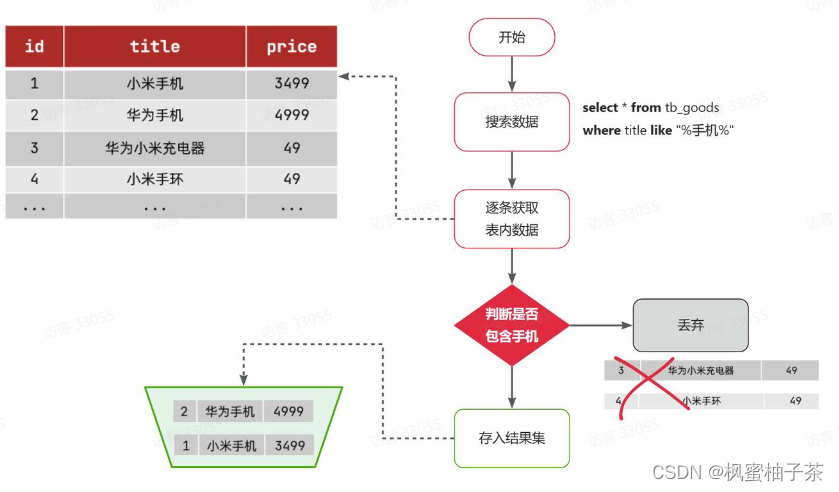
说明:
-
1)检查到搜索条件为
like '%手机%',需要找到title中包含手机的数据 -
2)逐条遍历每行数据(每个叶子节点),比如第1次拿到
id为1的数据 -
3)判断数据中的
title字段值是否符合条件 -
4)如果符合则放入结果集,不符合则丢弃
-
5)回到步骤1
综上,根据id精确匹配时,可以走索引,查询效率较高。而当搜索条件为模糊匹配时,由于索引无法生效,导致从索引查询退化为全表扫描,效率很差。
因此,正向索引适合于根据索引字段的精确搜索,不适合基于部分词条的模糊匹配。
而倒排索引恰好解决的就是根据部分词条模糊匹配的问题。
1.2.2.倒排索引
倒排索引中有两个非常重要的概念:
-
✴️ 文档(
document):用来搜索的数据,其中的每一条数据就是一个文档。例如一个网页、一个商品信息 -
✳️ 词条(
term):对文档数据或用户搜索数据,利用某种算法分词,得到的具备含义的词语就是词条。例如:我是中国人,就可以分为:我、是、中国人、中国、国人这样的几个词条
创建倒排索引是对正向索引的一种特殊处理和应用,流程如下:
-
💠 将每一个文档的数据利用分词算法根据语义拆分,得到一个个词条
-
💠 创建表,每行数据包括词条、词条所在文档id、位置等信息
-
💠 因为词条唯一性,可以给词条创建正向索引
此时形成的这张以词条为索引的表,就是倒排索引表,两者对比如下:
正向索引
| id(索引) | title | price |
|---|---|---|
| 1 | 小米手机 | 3499 |
| 2 | 华为手机 | 4999 |
| 3 | 华为小米充电器 | 49 |
| 4 | 小米手环 | 49 |
| ... | ... | ... |
倒排索引
| 词条(索引) | 文档id |
|---|---|
| 小米 | 1,3,4 |
| 手机 | 1,2 |
| 华为 | 2,3 |
| 充电器 | 3 |
| 手环 | 4 |
倒排索引的搜索流程如下(以搜索"华为手机"为例),如图:
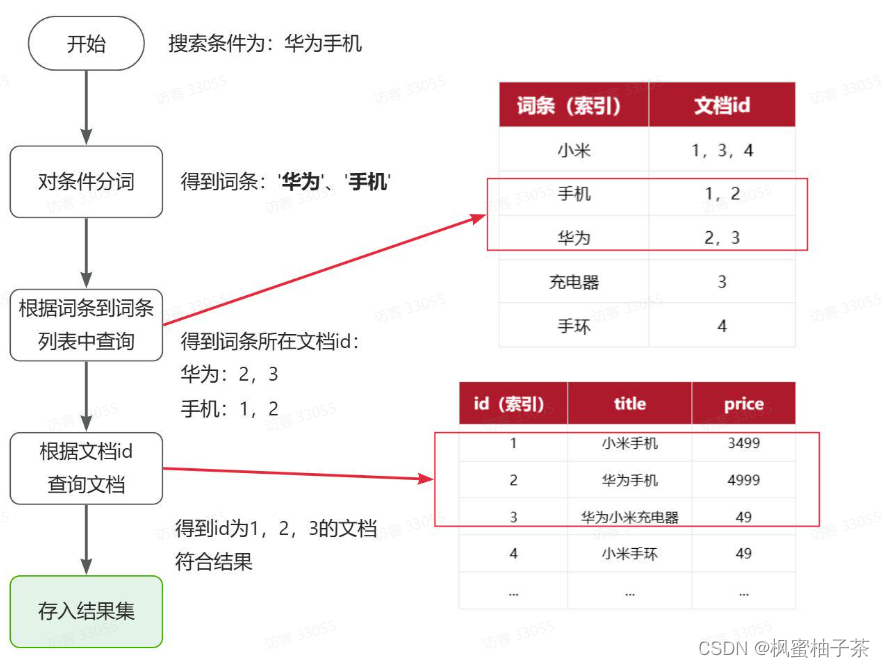
流程描述:
1)用户输入条件"华为手机"进行搜索。
2)对用户输入条件分词,得到词条:华为、手机。
3)拿着词条在倒排索引中查找(由于词条有索引,查询效率很高),即可得到包含词条的文档id:1、2、3。
4)拿着文档id到正向索引中查找具体文档即可(由于id也有索引,查询效率也很高)。
虽然要先查询倒排索引,再查询倒排索引,但是无论是词条、还是文档id都建立了索引,查询速度非常快!无需全表扫描。
1.2.3.正向和倒排
那么为什么一个叫做正向索引,一个叫做倒排索引呢?
-
正向索引是最传统的,根据id索引的方式。但根据词条查询时,必须先逐条获取每个文档,然后判断文档中是否包含所需要的词条,是根据文档找词条的过程。
-
而倒排索引则相反,是先找到用户要搜索的词条,根据词条得到保护词条的文档的id,然后根据id获取文档。是根据词条找文档的过程。
是不是恰好反过来了?
那么两者方式的优缺点是什么呢?
正向索引:
-
优点:
-
✔️ 可以给多个字段创建索引
-
✔️ 根据索引字段搜索、排序速度非常快
-
-
缺点:
-
❌ 根据非索引字段,或者索引字段中的部分词条查找时,只能全表扫描。
-
倒排索引:
-
优点:
-
✔️ 根据词条搜索、模糊搜索时,速度非常快
-
-
缺点:
-
❌ 只能给词条创建索引,而不是字段
-
❌ 无法根据字段做排序
-
1.3.基础概念
elasticsearch中有很多独有的概念,与mysql中略有差别,但也有相似之处。
1.3.1.文档和字段
elasticsearch是面向文档(document)存储的,可以是数据库中的一条商品数据,一个订单信息。文档数据会被序列化为json格式后存储在elasticsearch中:
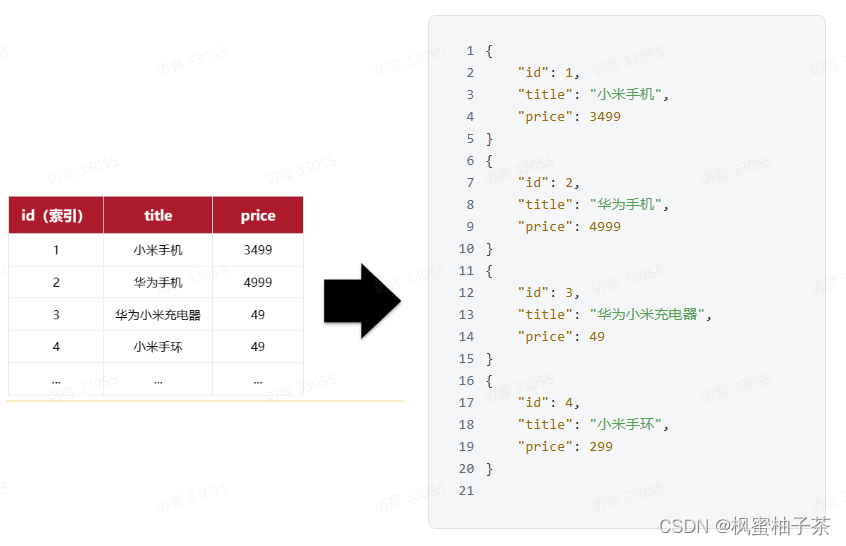
因此,原本数据库中的一行数据就是es中的一个json文档;而数据库中每行数据都包含很多列,这些列就转换为json文档中的字段(field)。
1.3.2.索引和映射
随着业务发展,需要在es中存储的文档也会越来越多,比如有商品的文档、用户的文档、订单文档等等:
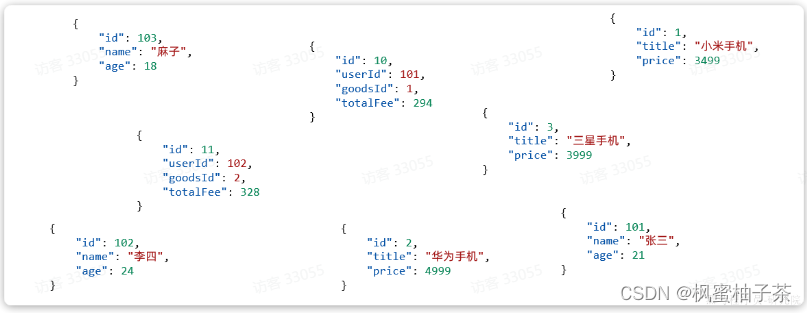
所有文档都散乱存放显然非常混乱,也不方便管理。
因此,我们要将类型相同的文档集中在一起管理,称为索引(index)。例如:
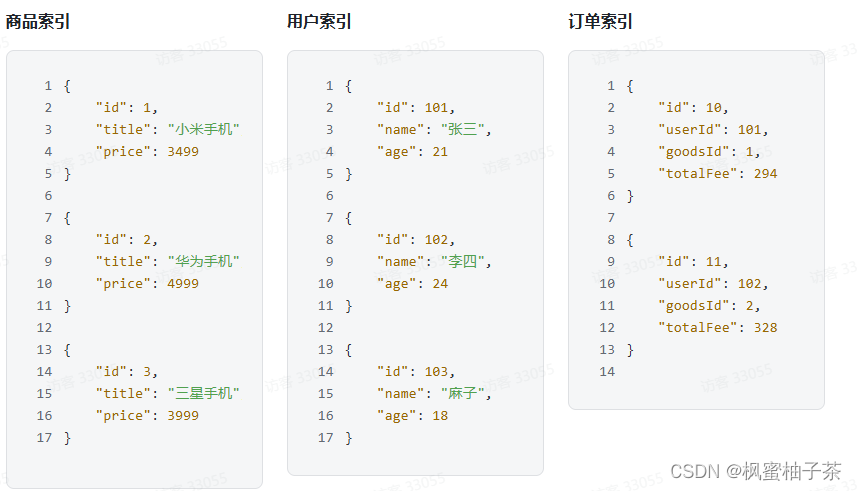
-
所有用户文档,就可以组织在一起,称为用户的索引;
-
所有商品的文档,可以组织在一起,称为商品的索引;
-
所有订单的文档,可以组织在一起,称为订单的索引;
因此,我们可以把索引当做是数据库中的表。
数据库的表会有约束信息,用来定义表的结构、字段的名称、类型等信息。因此,索引库中就有映射(mapping),是索引中文档的字段约束信息,类似表的结构约束。
1.3.3.mysql与elasticsearch
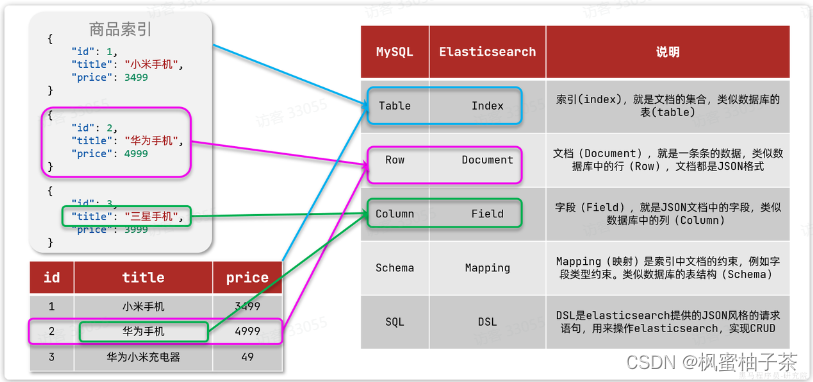
我们统一的把mysql与elasticsearch的概念做一下对比:
| mysql | elasticsearch | 说明 |
|---|---|---|
| table | index | 索引(index),就是文档的集合,类似数据库的表(table) |
| row | document | 文档(document),就是一条条的数据,类似数据库中的行(row),文档都是json格式 |
| column | field | 字段(field),就是json文档中的字段,类似数据库中的列(column) |
| schema | mapping | mapping(映射)是索引中文档的约束,例如字段类型约束。类似数据库的表结构(schema) |
| sql | dsl | dsl是elasticsearch提供的json风格的请求语句,用来操作elasticsearch,实现crud |
如图:
那是不是说,我们学习了elasticsearch就不再需要mysql了呢?
并不是如此,两者各自有自己的擅长之处:
-
mysql:擅长事务类型操作,可以确保数据的安全和一致性
-
elasticsearch:擅长海量数据的搜索、分析、计算
因此在企业中,往往是两者结合使用:
-
✅ 对安全性要求较高的写操作,使用mysql实现
-
✅ 对查询性能要求较高的搜索需求,使用elasticsearch实现
-
✅ 两者再基于某种方式,实现数据的同步,保证一致性
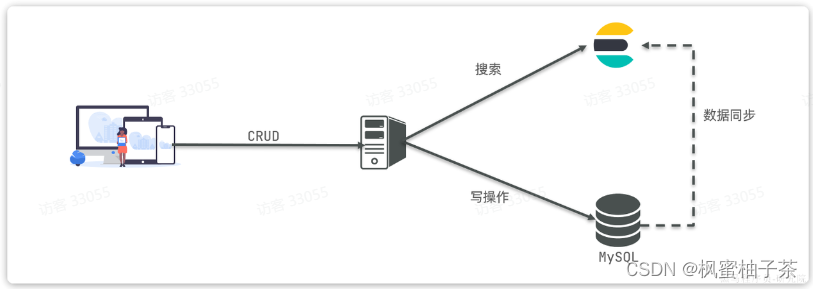
1.4.ik分词器
elasticsearch的关键就是倒排索引,而倒排索引依赖于对文档内容的分词,而分词则需要高效、精准的分词算法,ik分词器就是这样一个中文分词算法。
1.4.1.安装ik分词器
方案一:在线安装
运行一个命令即可:
docker exec -it es ./bin/elasticsearch-plugin install https://github.com/medcl/elasticsearch-analysis-ik/releases/download/v7.12.1/elasticsearch-analysis-ik-7.12.1.zip然后重启es容器:
docker restart es方案二:离线安装
如果网速较差,也可以选择离线安装。
首先,查看之前安装的elasticsearch容器的plugins数据卷目录:
docker volume inspect es-plugins结果如下:
[
    {
        "createdat": "2024-11-06t10:06:34+08:00",
        "driver": "local",
        "labels": null,
        "mountpoint": "/var/lib/docker/volumes/es-plugins/_data",
        "name": "es-plugins",
        "options": null,
        "scope": "local"
    }
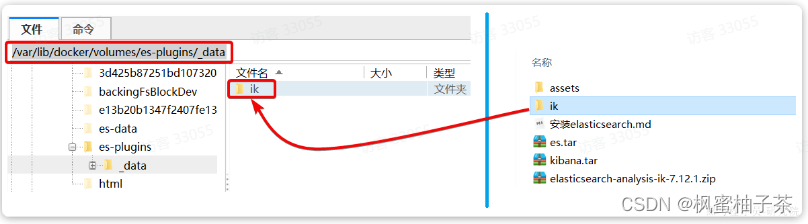
]可以看到elasticsearch的插件挂载到了/var/lib/docker/volumes/es-plugins/_data这个目录。我们需要把ik分词器上传至这个目录。
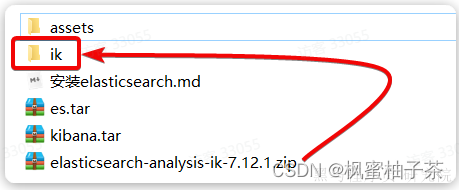
找到课前资料提供的ik分词器插件,课前资料提供了7.12.1版本的ik分词器压缩文件,你需要对其解压:
然后上传至虚拟机的/var/lib/docker/volumes/es-plugins/_data这个目录:
最后,重启es容器:
docker restart es1.4.2.使用ik分词器
ik分词器包含两种模式:
-
*️⃣ ik_smart:智能语义切分 -
*️⃣ ik_max_word:最细粒度切分
我们在kibana的devtools上来测试分词器,首先测试elasticsearch官方提供的标准分词器:
post /_analyze
{
  "analyzer": "standard",
  "text": "学习java太棒了"
}
结果如下:
{
  "tokens" : [
    {
      "token" : "学",
      "start_offset" : 0,
      "end_offset" : 1,
      "type" : "<ideographic>",
      "position" : 0
    },
    {
      "token" : "习",
      "start_offset" : 1,
      "end_offset" : 2,
      "type" : "<ideographic>",
      "position" : 1
    },
    {
      "token" : "java",
      "start_offset" : 2,
      "end_offset" : 3,
      "type" : "<alphanum>",
      "position" : 2
    },
    {
      "token" : "太",
      "start_offset" : 3,
      "end_offset" : 4,
      "type" : "<ideographic>",
      "position" : 3
    },
    {
      "token" : "棒",
      "start_offset" : 4,
      "end_offset" : 5,
      "type" : "<ideographic>",
      "position" : 4
    },
    {
      "token" : "了",
      "start_offset" : 5,
      "end_offset" : 6,
      "type" : "<ideographic>",
      "position" : 5
    }
  ]
}
可以看到,标准分词器智能1字1词条,无法正确对中文做分词。
我们再测试ik分词器:
post /_analyze
{
  "analyzer": "ik_smart",
  "text": "学习java太棒了"
}
执行结果如下:
{
  "tokens" : [
    {
      "token" : "学习",
      "start_offset" : 0,
      "end_offset" : 2,
      "type" : "cn_word",
      "position" : 0
    },
    {
      "token" : "java",
      "start_offset" : 2,
      "end_offset" : 6,
      "type" : "english",
      "position" : 1
    },
    {
      "token" : "太棒了",
      "start_offset" : 6,
      "end_offset" : 9,
      "type" : "cn_word",
      "position" : 2
    }
  ]
}
1.4.3.拓展词典
随着互联网的发展,“造词运动”也越发的频繁。出现了很多新的词语,在原有的词汇列表中并不存在。比如:“泰裤辣”,“传智播客” 等。
ik分词器无法对这些词汇分词,测试一下:
post /_analyze
{
  "analyzer": "ik_max_word",
  "text": "优质创作者去认证,真的泰裤辣!"
}
结果:
{
  "tokens" : [
    {
      "token" : "优",
      "start_offset" : 0,
      "end_offset" : 1,
      "type" : "cn_char",
      "position" : 0
    },
    {
      "token" : "质",
      "start_offset" : 1,
      "end_offset" : 2,
      "type" : "cn_char",
      "position" : 1
    },
    {
      "token" : "创",
      "start_offset" : 2,
      "end_offset" : 3,
      "type" : "cn_char",
      "position" : 2
    },
    {
      "token" : "作者",
      "start_offset" : 3,
      "end_offset" : 4,
      "type" : "cn_char",
      "position" : 3
    },
    {
      "token" : "去",
      "start_offset" : 4,
      "end_offset" : 6,
      "type" : "cn_word",
      "position" : 4
    },
    {
      "token" : "认证",
      "start_offset" : 6,
      "end_offset" : 8,
      "type" : "cn_word",
      "position" : 5
    },
    {
      "token" : "真的",
      "start_offset" : 9,
      "end_offset" : 11,
      "type" : "cn_word",
      "position" : 6
    },
    {
      "token" : "泰",
      "start_offset" : 11,
      "end_offset" : 12,
      "type" : "cn_char",
      "position" : 7
    },
    {
      "token" : "裤",
      "start_offset" : 12,
      "end_offset" : 13,
      "type" : "cn_char",
      "position" : 8
    },
    {
      "token" : "辣",
      "start_offset" : 13,
      "end_offset" : 14,
      "type" : "cn_char",
      "position" : 9
    }
  ]
}
可以看到,优质创作者和泰裤辣都无法正确分词。
所以要想正确分词,ik分词器的词库也需要不断的更新,ik分词器提供了扩展词汇的功能。
1)打开ik分词器config目录:
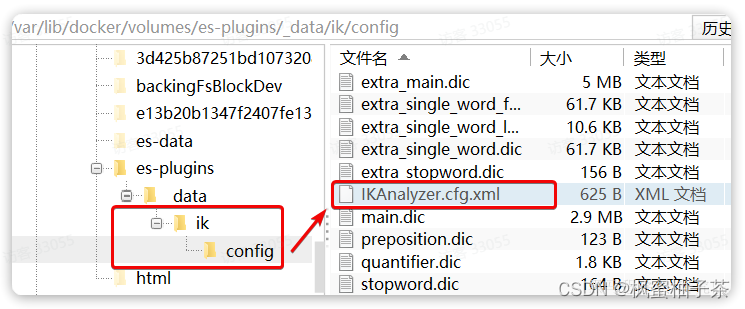
💡 注意,如果采用在线安装的通过,默认是没有config目录的,需要把课前资料提供的ik下的config上传至对应目录。
2)在ikanalyzer.cfg.xml配置文件内容添加:
<?xml version="1.0" encoding="utf-8"?>
<!doctype properties system "http://java.sun.com/dtd/properties.dtd">
<properties>
        <comment>ik analyzer 扩展配置</comment>
        <!--用户可以在这里配置自己的扩展字典 *** 添加扩展词典-->
        <entry key="ext_dict">ext.dic</entry>
</properties>
3)在ik分词器的config目录新建一个 ext.dic,可以参考config目录下复制一个配置文件进行修改
4)重启elasticsearch
docker restart es

# 查看 日志
docker logs -f elasticsearch再次测试,可以发现传智播客和泰裤辣都正确分词了:
{
  "tokens" : [
    {
      "token" : "优质创作者",
      "start_offset" : 0,
      "end_offset" : 4,
      "type" : "cn_word",
      "position" : 0
    },
    {
      "token" : "去",
      "start_offset" : 4,
      "end_offset" : 6,
      "type" : "cn_word",
      "position" : 1
    },
    {
      "token" : "认证",
      "start_offset" : 6,
      "end_offset" : 8,
      "type" : "cn_word",
      "position" : 2
    },
    {
      "token" : "真的",
      "start_offset" : 9,
      "end_offset" : 11,
      "type" : "cn_word",
      "position" : 3
    },
    {
      "token" : "泰裤辣",
      "start_offset" : 11,
      "end_offset" : 14,
      "type" : "cn_word",
      "position" : 4
    }
  ]
}
1.4.4.总结
分词器的作用是什么?
-
⁉️ 创建倒排索引时,对文档分词。
-
⁉️ 用户搜索时,对输入的内容分词。
ik分词器有几种模式?
-
⁉️ ik_smart:智能切分,粗粒度。 -
⁉️ ik_max_word:最细切分,细粒度。
ik分词器如何拓展词条?如何停用词条?
-
✅利用config目录的
ikanalyzer.cfg.xml文件添加拓展词典和停用词典。 -
✅ 在词典中添加拓展词条或者停用词条。



发表评论