
 我要评论
1. 什么是kafka
kafka是一个分布式流处理系统,流处理系统使它可以像消息队列一样publish(发布)或者subscribe(订阅)消息,分布式提供了容错性,并发处理消息的机制。
kafka运行在集群上,集群包含一个或多个服务器。kafka把消息存在topic中,每一条消息包含键值(key),值(value)和时间戳(timestamp)。
2. kafka基本概念
- producer: 消息生产者,就是向kafka broker发消息的客户端。
- consumer: 消息消费者,是消息的使用方,从kafka broker 拉取消息,负责消费kafka服务器上的消息。
- topic: 主题,由用户定义并配置在kafka服务器,用于建立producer和consumer之间的订阅关系。生产者发送消息到指定的topic下,消息者从这个topic下消费消息。你可以把它理解为一个队列,topic 将消息分类,生产者和消费者面向的是同一个 topic。
- partition:消息分区,一个topic可以分为多个 partition,partition是相对于topic是在在物理上的概念,每个partition是一个有序的队列,partition中的每条消息都会被分配一个有序的id(offset)。
- broker :一台kafka服务器就是一个broker。一个集群由多个broker组成。一个broker可以容纳多个topic。
- consumer-group:消费者分组,用于归组同类消费者。每个consumer属于一个特定的consumer group,多个消费者可以共同消息一个topic下的消息,每个消费者消费其中的部分消息,这些消费者就组成了一个分组,拥有同一个分组名称,通常也被称为消费者集群。
消费者组内每个消费者,负责消费不同分区的数据,提高消费能力。一个分区只能由组内一个消费者消费,消费者组之间互不影响。所有的消费者都属于某个消费者组,即消费者组是逻辑上的一个订阅者。 - offset :消息在partition中的偏移量。每一条消息在partition都有唯一的偏移量,消息者可以指定偏移量来指定要消费的消息。记录消费者消费的位置信息,监控数据消费到什么位置,当消费者挂掉,再重新恢复的时候,可以从消费位置继续消费。
- zookeeper: kafka 集群能够正常工作,需要依赖于 zookeeper,zookeeper 帮助kafka 存储和管理集群信息。
3.安装kafka
这里我的安装环境是mac
brew install kafka
kafka使用zookeeper管理,安装过程会自动安装zookeeper
以我这里的配置为说明:
kafka安装路径:
/opt/homebrew/cellar/kafka/3.2.1
kafka属性文件:
/opt/homebrew/etc/kafka/server.properties
zookeeper属性文件:
/opt/homebrew/etc/kafka/zookeeper.properties
修改kafka启动配置文件
vi /opt/homebrew/etc/kafka/server.properties
该配置为单机版,修改kafka的监听地址和端口为localhost:9092。
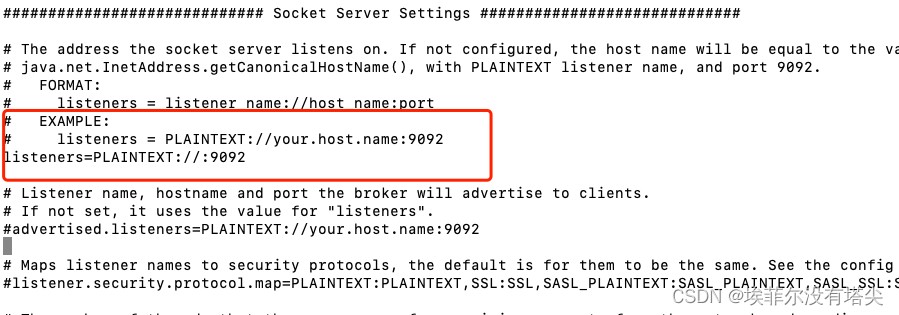
前台方式启动服务
/opt/homebrew/opt/kafka/bin/kafka-server-start /opt/homebrew/etc/kafka/server.properties
后台方式服务
brew services start zookeeper
brew services start kafka
查看服务启动没:

4.可视化工具offset explorer使用
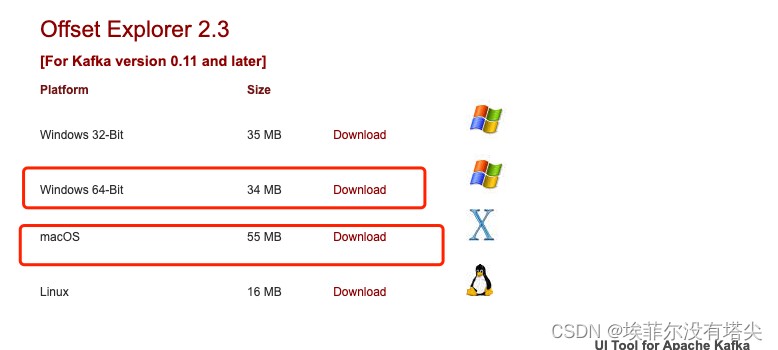
下载地址:https://www.kafkatool.com/download.html
下载对应的版本:
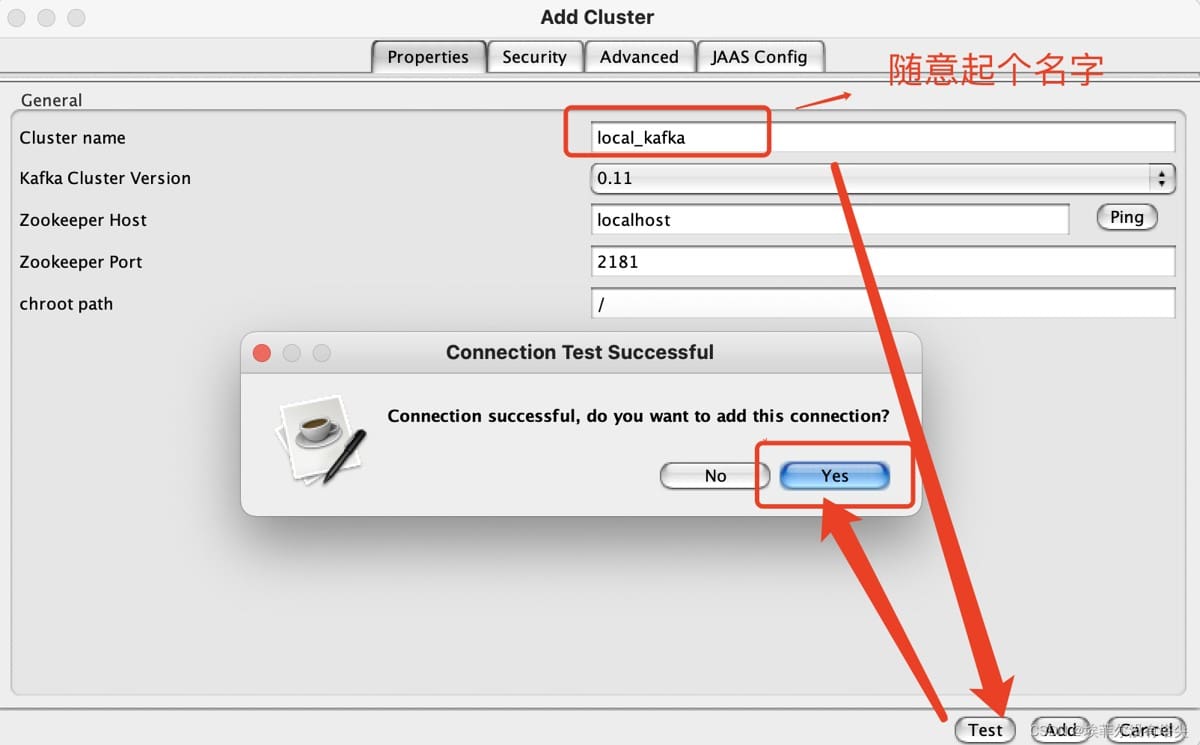
测试链接:
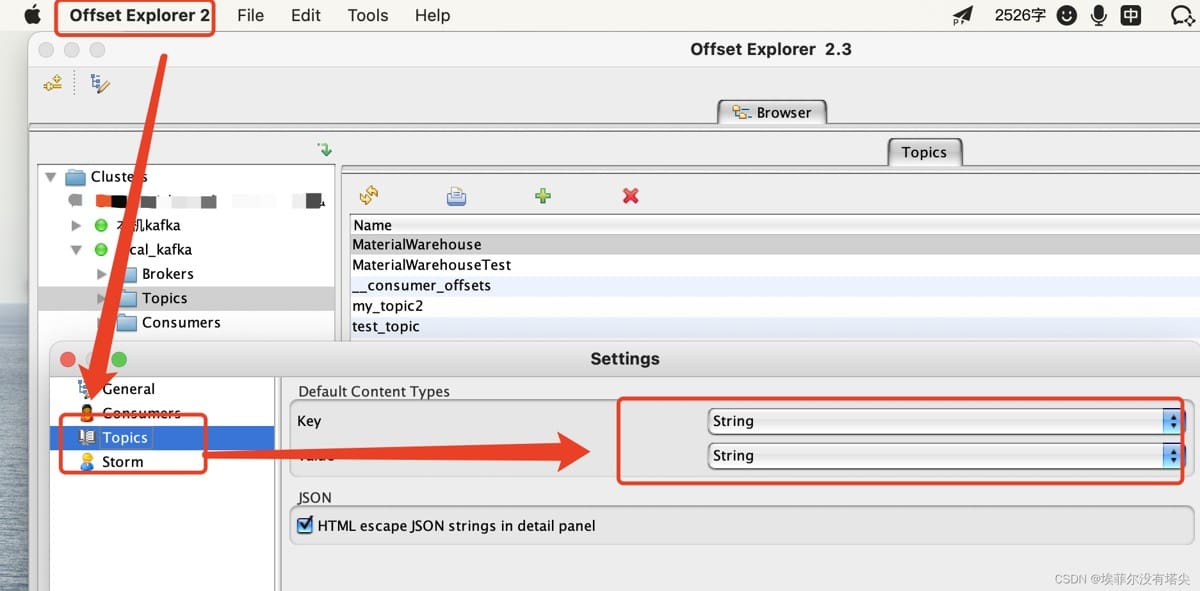
每个message默认是以二进制形式展示的, 设置为string
5.python操作kafka
用python读写kafka,我们要使用的一个第三方库叫做kafka-python。
pip install kafka-python
kafka-python是一个python的kafka客户端,可以用来向kafka的topic发送消息、消费消息。
5.1消息生产者
代码如下:
第一种写法:
from kafka import kafkaproducer

producer = kafkaproducer(
    bootstrap_servers=['127.0.0.1:9092'],
    value_serializer=lambda m: json.dumps(m, ensure_ascii=false).encode(),
)

for _id in range(1, 5):
    content = {"title": "生命不息,运动不止!", "index": _id}
    future = producer.send(topic='test_topic',  value=content)
    result = future.get(timeout=10)
    print("kafka生产数据:", result)
参数解释:
topic: topic的名称,指定向那个topic发送下消息。如果不手动创建topic的话,发送数据的时候会自动创建。bootstrap_servers:指定kafka服务器,接受的类型是数组,如果是多台服务器,就在数组里面多写几个服务器地址,比如:['127.0.0.1:9092', '127.0.0.1:9093', '127.0.0.1:9094']value_serializer:用来指定序列化的方式,这里使用json来序列化数据,从而实现向kafka传入一个字典,kafka 会自动把value自动转为json格式。
第二种写法:
import json
import logging

from kafka import kafkaproducer
from kafka.errors import kafkaerror

logging.basicconfig(level=logging.info)
logger = logging.getlogger(__name__)

producer = kafkaproducer(
    bootstrap_servers=["127.0.0.1:9092"],   # 生产环境建议写多个 broker
    acks="all",                              # 等所有 isr 确认,最安全
    retries=3,
    linger_ms=10,                            # 攒批,提升吞吐
    batch_size=16 * 1024,
    key_serializer=lambda k: k.encode("utf-8") if isinstance(k, str) else k,
    value_serializer=lambda v: json.dumps(v, ensure_ascii=false).encode("utf-8"),
)

futures = []
try:
    for _id in range(1, 5):
        content = {"title": "生命不息,运动不止!", "index": _id}
        future = producer.send(
            topic="test_topic",
            key=str(_id),      # 指定 key 保证同一 id 落到同一分区,顺序可控
            value=content,     # 已配置 value_serializer,直接传 dict
        )
        # 用回调方式异步处理结果
        future.add_callback(
            lambda meta: logger.info(
                "kafka 消息发送成功: topic=%s partition=%s offset=%s",
                meta.topic, meta.partition, meta.offset,
            )
        )
        future.add_errback(
            lambda exc: logger.error("kafka 消息发送失败: %s", exc)
        )
        futures.append(future)
finally:
    producer.flush(timeout=10)   # 等所有缓冲消息发出去
    producer.close(timeout=10)

# 如果需要同步拿到每条结果,可以这样:
# for f in futures:
#     try:
#         meta = f.get(timeout=10)
#         print("kafka生产消息:", meta.topic, meta.partition, meta.offset)
#     except kafkaerror as e:
#         logger.error("发送失败: %s", e)
这里也可以在发送消息的直接对value用json.dumps()方法。
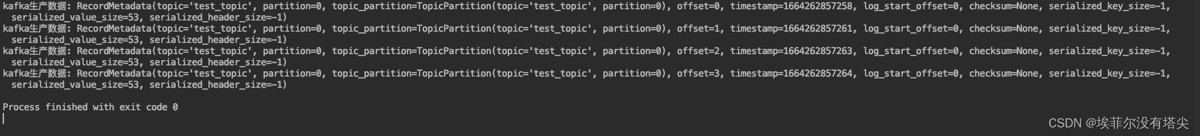
运行结果如下:
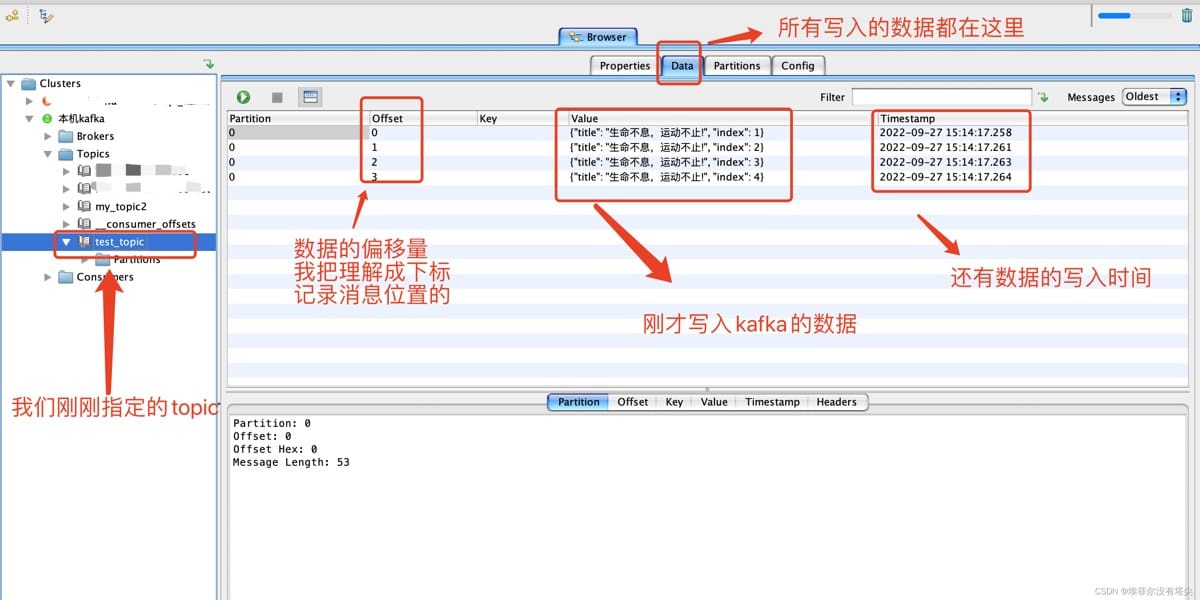
然后在kafka客户端工具offset explorer2看看效果:
5.2消息消费者
此时开另一个程序运行生产者代码,即会有输出显示;即监听生产者发布的消息,只要生产者新产生了一条消息,消费端就会接受到一条消息。
代码如下:
消费方式1 默认消费所有分区的消息
import time
from kafka import kafkaconsumer
bootstrap_servers = ['127.0.0.1:9092']
consumer = kafkaconsumer(group_id='test_consumer_group', bootstrap_servers=bootstrap_servers)

consumer.subscribe(topics=['test_topic'])
for msg in consumer:
    time.sleep(2)
    print("-----------------------------------------")
    print("接受到消息:", msg)
    print(f"topic = {msg.topic}")  # topic default is string
    print(f"partition = {msg.partition}")
    print(f"value = {msg.value.decode()}")  # bytes to string
    print(f"timestamp = {msg.timestamp}")
    print("time = ", time.strftime("%y-%m-%d %h:%m:%s", time.localtime(msg.timestamp / 1000)))
    print("offset偏移量:", msg.offset)
运行结果:
参数解释:
- topic:topic的名称,表示当前消费者从那个topic监听并读取消息。
- group_id:指定此消费者实例属于的组名,group_id这个参数后面的字符串可以任意填写;如果两个程序的topic与group_id相同,那么他们读取的数据不会重复,两个程序的topic相同,但是group_id不同,那么他们各自消费全部数据,互不影响
- auto_offset_rest 这个参数有两个值,earliest和latest,如果省略这个参数,那么默认就是latest;auto_offset_reset的作用,是在你的 group 第一次运行,还没有 offset 的时候,给你设定初始的 offset。而一旦你这个 group 已经有 offset 了,那么auto_offset_reset这个参数就不会再起作用了
消费方式2, 指定消费分区
import time
from kafka import kafkaconsumer
from kafka import topicpartition

bootstrap_servers = ['127.0.0.1:9092']
consumer = kafkaconsumer(group_id='test_consumer_group', bootstrap_servers=bootstrap_servers)

consumer.assign([topicpartition('test_topic', 0)])
for msg in consumer:
    time.sleep(2)
    print("接受到消息:", msg)
消费方式3,手动commit,生产中建议使用这种方式
import time
from kafka import kafkaconsumer
from kafka import topicpartition
bootstrap_servers = ["127.0.0.1:9092"]
consumer = kafkaconsumer(
    bootstrap_servers=bootstrap_servers,
    consumer_timeout_ms=1000,
    group_id="test_consumer_group",
    enable_auto_commit=false,
)


consumer.assign([topicpartition("test_topic", 0)])
for msg in consumer:
    time.sleep(2)
    print("接受到消息:", msg)
    consumer.commit()
6.获取所有的topic
kafka-python获取所有的topic接口是在kafkaconsumer类中实现的
from kafka import kafkaconsumer
# 获取topic列表以及topic的分区列表
def retrieve_topics():
    consumer = kafkaconsumer(bootstrap_servers=servers)
    print(consumer.topics())

# 获取topic的分区列表
def retrieve_partitions(topic):
    consumer = kafkaconsumer(bootstrap_servers=servers)
    print(consumer.partitions_for_topic(topic))

# 获取consumer group对应的分区的当前偏移量
def retrieve_partition_offset():
    consumer = kafkaconsumer(bootstrap_servers=servers,
                             group_id='kafka-group-id')
    tp = topicpartition('kafka-topic', 0)
    consumer.assign([tp])
    print("starting offset is ", consumer.position(tp))
7. 创建、删除topic
from kafka import kafkaadminclient
from kafka.admin import newtopic
from kafka.errors import topicalreadyexistserror

admin = kafkaadminclient(bootstrap_servers=servers)

# 创建topic
def create_topic():
    try:
        new_topic = newtopic("create-topic", 8, 3)
        admin.create_topics([new_topic])
    except topicalreadyexistserror as e:
        print(e.message)

# 删除topic
def delete_topic():
    admin.delete_topics(["create-topic"])
8.获取消费组信息
from kafka import kafkaadminclient

admin = kafkaadminclient(bootstrap_servers=servers)
# 获取消费组信息
def get_consumer_group():
    # 显示所有的消费组
    print(admin.list_consumer_groups())

    # 显示消费组的offsets
    print(admin.list_consumer_group_offsets("kafka-group-id"))
9.获取topic配置信息
from kafka import kafkaadminclient
from kafka.admin import configresource, configresourcetype

admin = kafkaadminclient(bootstrap_servers=servers)
# 获取topic的配置信息
def get_topic_config():
    resource_config = configresource(configresourcetype.topic, "create-topic")
    config_entries = admin.describe_configs([resource_config])
    print(config_entries.resources)
10.offset 和 groupid详解
10.1consumer消费者
kafka消费者可以从多个broker中读取数据,也可以消费多个topic中的数据。
因为kafka的broker是无状态的,所以consumer必须使用partition offset来记录消费了多少数据。如果一个consumer指定了一个topic的offset,意味着该consumer已经消费了该offset之前的所有数据。consumer可以通过指定offset,从topic的指定位置开始消费数据。consumer的offset存储在zookeeper中。
10.2 offset偏移量
用来保存消费进度。offset表示在当前topic,当前groupid下消费到的位置。offset为earliest并不代表offset=1.在不进行过期配置的情况下,kafka消息默认7天时间就会过期。过期后其offset也就随之发生变化,使得用数字进行配置的消费进度并不准确。
- earliest:自动重置到最早的offset。
- latest:看上去重置到最晚的offset。
- none:如果边更早的offset也没有的话,就抛出异常给consumer,告诉consumer在整个consumer group中都没有发现有这样的offset。
10.3 groupid
一个字符串用来指示一组consumer所在的组。相同的groupid表示在一个组里。相同的groupid消费记录offset时,记录的是同一个offset。
所以,此处需要注意,
(1)如果多个地方都使用相同的groupid,可能造成个别消费者消费不到的情况
(2)如果单个消费者消费能力不足的话,可以启动多个相同groupid的consumer消费,处理相同的逻辑。
但是,多线程的时候,需要增加每个groupid下的partition分区数量,便于每个线程稳定读取固定的partition,提高消费能力。
到此这篇关于python中kafka的安装和使用教程的文章就介绍到这了,更多相关python kafka安装内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!

发表评论