 我要评论
前言
在数据处理场景中,经常会遇到表格行列互换需求:原始横向表格转为纵向,或是纵向指标表转为横向汇总表。手动复制粘贴转置在数据量大、需要自动化重复执行时效率很低。
python 生态有多种处理 excel 的方案,本文介绍如何使用免费库 free spire.xls for python 来实现行列转置。它的优势是不依赖本地安装 microsoft excel,可以直接读写 .xlsx/.xls 文件,并且能够保留单元格样式、格式,而不仅仅是纯文本数据。
说明:免费版一般适合中小型报表自动化场景,使用前先了解限制,大规模业务场景需要提前评估限制。
环境准备
python 版本要求:python3.6+
使用pip安装免费包:
pip install spire.xls.free
导入需要用到的模块:
from spire.xls import workbook, fileformat
实现思路
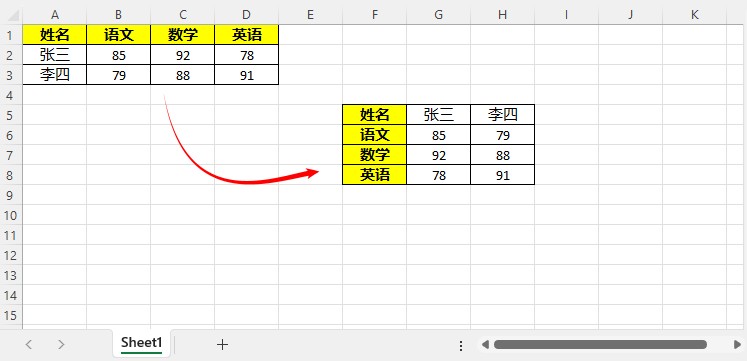
行列转置本质是矩阵转置:原表第i行第j列的数据,写入新区域的第j行第i列。
实现步骤:
- 加载excel文件,读取目标工作表
- 获取已使用数据区域,得到有效行数、列数
- 遍历原区域,缓存单元格值+样式
- 在工作表的空白区域写入转置后的数据,同步复制单元格样式
- 保存文件,释放资源
两种可选方案:
① 在同一张工作表空白区域写入转置结果;
② 新建工作表存放转置后数据。
下面示例同一张工作表方案,避免切 sheet 查看,也方便用公式引用原始区域。
完整代码示例
from spire.xls import workbook, fileformat

def transpose_excel(file_path: str, output_path: str):
    # 加载工作簿
    wb = workbook()
    wb.loadfromfile(file_path)
    sheet = wb.worksheets[0]

    # 获取当前工作表已使用范围
    used_range = sheet.allocatedrange
    row_count = used_range.rows.count
    col_count = used_range.columns.count

    # 目标空白区域起始位置
    start_row = row_count + 2
    start_col = col_count + 2

    # 遍历原区域,完成行列转置,同时复制单元格样式
    for r in range(1, row_count + 1):
        for c in range(1, col_count + 1):
            src_cell = sheet.range[r, c]
            # 转置:原r行c列 → 目标(start_row + c - 1, start_col + r - 1) 行/列
            dest_row = start_row + c - 1
            dest_col = start_col + r - 1
            dest_cell = sheet.range[dest_row, dest_col]
            dest_cell.value = src_cell.value
            # 复制单元格样式(字体、边框、背景色等)
            dest_cell.style = src_cell.style

    # 保存输出文件
    wb.savetofile(output_path, fileformat.version2016)
    # 释放资源
    wb.dispose()
    print(f"转置完成,文件输出至:{output_path}")


if __name__ == "__main__":
    transpose_excel("source.xlsx", "transposed_result.xlsx")
代码关键点解析
allocatedrange:获取工作表实际占用的单元格区域,避免遍历大量空白单元格,提升执行效率。- 单元格样式复制:
dest_cell.style = src_cell.style,这是很多轻量库不具备的能力,可以保留原表格边框、背景色、字体格式。 - 资源释放
wb.dispose():该库底层是非托管资源,脚本结束建议主动释放,避免文件句柄占用。
测试结果
执行脚本后,transposed_result.xlsx 结果文件预览:
扩展:仅转置纯数据(不复制样式,速度更快)
from spire.xls import workbook, fileformat

def transpose_excel_data_only(file_path: str, output_path: str):
    wb = workbook()
    wb.loadfromfile(file_path)
    sheet = wb.worksheets[0]
    used_range = sheet.allocatedrange
    row_count = used_range.rows.count
    col_count = used_range.columns.count

    # 读取二维数组
    data = []
    for r in range(1, row_count + 1):
        row_data = []
        for c in range(1, col_count + 1):
            row_data.append(sheet.range[r, c].value)
        data.append(row_data)

    # 矩阵转置
    transposed_data = list(zip(*data))

    # 写入原区域正下方的空白区域
    start_row = row_count + 2
    for tr, row in enumerate(transposed_data, start=start_row):
        for tc, val in enumerate(row, start=1):
            sheet.range[tr, tc].value = val

    wb.savetofile(output_path, fileformat.version2016)
    wb.dispose()
与 pandas 方案对比
pandas:数据转置简单(df.t),但输出过程会重新构建工作表,原有格式(如单元格颜色、边框、列宽)无法保留,适用于纯数据分析场景而非文档格式保真场景。
free spire.xls:独立组件,无需 office,原生支持复制单元格样式。当报表带有复杂格式、边框、背景色需要保留时,这个方案会更省心。
小结
本文通过 free spire.xls for python 实现 excel 行列转置,重点演示带样式保留的场景,适合报表自动化、数据整理脚本开发。核心逻辑就是矩阵转置,通过遍历单元格把(r,c)映射到(c,r)。
以上就是使用python实现excel行列转置功能并保留单元格样式的详细内容,更多关于python excel行列转置的资料请关注代码网其它相关文章!
发表评论