
 我要评论
事务的并发性和隔离性由存储引擎(如 innodb)和事务隔离级别共同决定。
mysql(尤其是 innodb 引擎)使用 行级锁(row-level locking)来实现事务的隔离性
- 如果事务 a 修改了某一行,它会对该行加排他锁(x 锁)。
- 此时事务 b 若也尝试修改或读取(取决于隔离级别)同一行,就可能被阻塞,直到事务 a 提交或回滚。
mysql 默认隔离级别是 repeatable read(可重复读),不同级别对并发的影响不同:
- read uncommitted:几乎无阻塞(但可能读到脏数据)。
- read committed:读操作一般不加锁(使用快照读),写操作加行锁。
- repeatable read:innodb 使用 mvcc + next-key lock 防止幻读,可能在范围查询时加间隙锁(gap lock),增加锁竞争。
- serializable:所有读操作都加共享锁,显著增加阻塞可能性,但依然不是“全局”锁。
两个概念
脏读
脏读是指一个事务读取了另一个尚未提交的事务所修改的数据。
如果那个未提交的事务后来回滚(rollback)了,那么当前事务读到的数据就是“不存在”的、无效的——这就是所谓的“脏数据”。
例子:
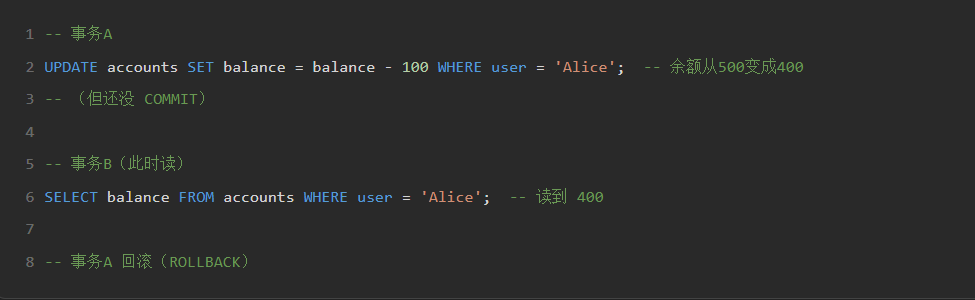
- mysql 的 innodb 引擎在默认隔离级别(repeatable read)下禁止脏读。
说明一下:
-- 事务a
update accounts set balance = balance - 100 where user = 'alice';  -- 余额从500变成400
-- (但还没 commit)
mysql执行逻辑:
执行这个sql后,数据在物理/内存层面已经被修改了。
innodb 会在内存中(buffer pool)修改该行的数据页,将 balance 从 500 改为 400
- 同时,它会:
- 在 undo log 中保留旧值(500),用于回滚或 mvcc 快照读。
- 在 redo log 中记录这次修改,用于崩溃恢复。
- 对该行加上 排他锁(x 锁),防止其他事务同时修改。
在正常隔离级别下,其他事务是看不到这个update后的400的
原理:
其他事务使用 read committed / repeatable read(默认)
- innodb 使用 mvcc(多版本并发控制)。
- 其他事务执行
select balance from accounts where user = 'alice';时:- 会通过 read view 判断当前事务 a 是否已提交。
- 因为事务 a 未提交,所以其他事务看不到 400,而是通过 undo log 读到旧值 500。
- 只有当事务 a commit 后,这个 400 才对其他事务可见。
(通俗的讲就是会检查事务a是否全部提交完了,隔离性和原子性的体现)
幻读
幻读是指在一个事务中,两次执行相同的查询,但第二次查询返回了第一次没有的结果(即“凭空出现”的新行),就像出现了“幻影”。
幻读通常发生在插入(insert)操作上,而不是更新。
-- 事务a 开始
start transaction;

-- 第一次查询
select * from students where score > 80;  -- 返回 0 行

-- 此时,事务b 插入了一条新记录:
insert into students (id, name, score) values (3, 'tom', 90);
commit;

-- 事务a 再次执行相同查询
select * from students where score > 80;  -- 现在返回 tom!
- mysql innodb 在 repeatable read 级别下通过“next-key lock”(行锁 + 间隙锁)也防止了幻读(这是 innodb 的特殊优化,不同于 sql 标准)。
幻读:新增行导致查询结果集变大(针对新插入的行)---结果集会变大。
区别:
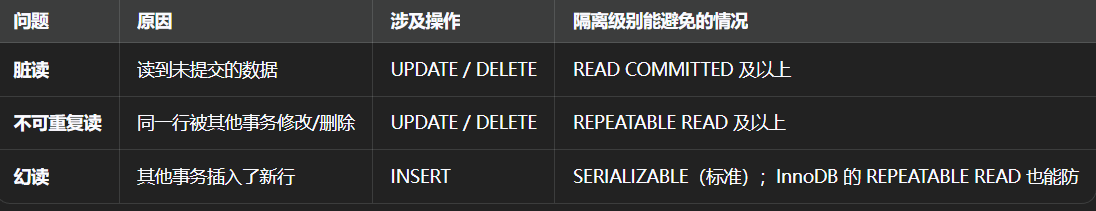
总结就是 放心使用。。遇到其他问题再说
mysql 默认(innodb + repeatable read):
- 不会出现 脏读
- 不会出现 不可重复读
- 也不会出现幻读(得益于间隙锁)
buffer pool
基本概念:
- buffer pool是mysql innodb存储引擎的一个全局内存结构。它不是按表划分的,也不是按数据库划分的,而是整个mysql服务器实例独享的一个大内存池。
- 本质: buffer pool(缓冲池)是mysql innodb存储引擎在内存中开辟的一片区域,本质上是一片连续的内存空间。
- 目的: 主要目的是为了缓存磁盘上的数据页(data pages)和索引页(index pages)。当mysql需要读取或修改数据时,会首先尝试在buffer pool中进行操作,而不是直接访问速度较慢的磁盘。这极大地减少了磁盘i/o次数,显著提升了数据库的性能。
为什么需要 buffer pool?
- 磁盘i/o是数据库性能的主要瓶颈。相比于内存访问,从磁盘读取数据的速度要慢得多。
- 通过将热点数据(经常被访问的数据)保留在内存中的buffer pool里,可以避免频繁的磁盘随机读取,从而大幅提升查询和修改数据的速度。
buffer pool 的基本结构与内容
- 单位: buffer pool以页(page)为基本单位进行管理,默认每页大小为16kb。
- 缓存内容:
- 数据页 (data pages): 表中的实际行数据所在的页。
- 索引页 (index pages): 表上各种索引(如主键索引、二级索引)的b+树节点所在的页。
- 管理方式: 其底层通常采用链表等数据结构来管理这些缓存页。
buffer pool 的工作机制 - lru算法
- 核心思想: 为了高效利用有限的内存空间,buffer pool使用lru(least recently used,最近最少使用)算法来决定哪些页应该保留在内存中,哪些页应该被淘汰出去。
- 实现: 内部维护一个lru链表,当一个页被访问(读取或修改)时,它会被移动到链表的头部。长时间未被访问的页会逐渐移向链表的尾部。
- 淘汰策略: 当buffer pool空间不足时,innodb会将lru链表尾部的页(即最近最少使用的页)刷回磁盘(如果该页被修改过,即脏页),然后将其从buffer pool中移除,为新的数据页腾出空间。
buffer pool 相关配置
- 大小设置: buffer pool的大小可以通过参数
innodb_buffer_pool_size来配置。- 默认值: 早期版本通常是128mb,新版本可能更大。
- 推荐配置: 通常建议将其设置为服务器物理内存的60%到80%,具体取决于服务器上是否只运行mysql以及应用的特点。
- 启动分配: mysql服务器启动时,会根据配置的大小一次性向操作系统申请这片内存空间
例子说明:
初始状态
- mysql刚刚启动,buffer pool是空的,或者只包含一些系统数据页。
- 假设你的buffer pool总共能存放10个数据页(为了简化说明,实际远大于此)。
第一次查询
执行sql: 你执行了 select * from users where id = 100;
查找过程:
- mysql的innodb引擎收到这个请求,需要找到id为100的用户记录。
- 它首先去buffer pool里查找。因为是第一次查询,buffer pool里没有任何
users表的数据。 - 查找失败。
磁盘读取:
- 引擎必须去磁盘上读取包含id=100这条记录的那个16kb的数据页。
- 假设这个记录在磁盘上的第5个数据页(page 5)中。
- 引擎会将整个"page 5"从磁盘读取到内存的buffer pool中。
返回结果: 在内存中的"page 5"里找到id=100的记录,返回给客户端。
buffer pool状态: 此刻,buffer pool里有了1个页,即"page 5"。
第二次查询(命中缓存)
执行sql: 你紧接着又执行了 select * from users where id = 100; (还是查id=100)
查找过程:
- innodb引擎再次收到请求。
- 它去buffer pool里查找id=100的记录。
- 发现"page 5"已经在buffer pool里了!
返回结果: 引擎直接在内存中的"page 5"里找到记录,快速返回给客户端。这次没有发生任何磁盘i/o! 这就是缓存带来的巨大性能提升。
访问其他数据
执行sql: select * from users where id = 200;
查找过程: buffer pool里没有包含id=200的页。
磁盘读取: 假设id=200在磁盘的"page 8"中,引擎将"page 8"读入buffer pool。
更新lru列表: 为了管理缓存,innodb会维护一个lru(最近最少使用)链表。
- 刚刚读入的"page 8"被认为是最“热”的,会被放到lru链表的头部。
- 之前被访问的"page 5"则会被移到链表的后面一点。
buffer pool状态: 现在buffer pool里有"page 5"和"page 8"两个页。
插入数据
执行sql: insert into users (username, email, password_hash) values ('new_user', 'new@example.com', '...');
查找过程: innodb需要更新聚集索引(主键索引),找到插入位置。同样,它会先在buffer pool中查找相关的索引页。
缓存命中/未命中: 如果相关的索引页(比如根节点或中间节点的页)在buffer pool中,就直接修改内存;如果没有,也需要先从磁盘读取到buffer pool。
修改内存: 将新记录插入到buffer pool中的相应页里。
标记脏页: 这个被修改过的页现在被称为“脏页”(dirty page),因为它内存中的内容与磁盘上的不一致。
后续处理: 这个脏页不会立即写回磁盘,而是等待后台线程(如innodb_io_capacity控制的刷新线程)在合适的时机将其刷回磁盘,以保证数据持久化。
buffer pool满了怎么办?(lru算法详解)
假设经过一系列操作后,buffer pool的10个页都已经被占满,分别是 page 1, 2, 3, ..., 10。并且,根据它们的访问频率,它们在lru链表中的顺序是这样的(越靠近头部表示越“热”):[page 7, page 3, page 9, page 2, page 8, page 5, page 1, page 4, page 6, page 10](page 7 是最近最常访问的,page 10 是最近最少访问的)
执行sql: select * from users where id = 300; 假设这条记录在 page 15 中。
buffer pool已满: buffer pool已经没有空闲空间了。
触发淘汰: innodb需要从buffer pool中“踢”出一个页,为即将读入的"page 15"腾地方。根据lru算法,它会选择lru链表尾部的页,也就是page 10。
检查脏页: innodb检查page 10是否是脏页。
- 如果不是脏页 (clean page): 直接将其从buffer pool中移除即可。
- 如果是脏页 (dirty page): 需要先将
page 10的内容写回到磁盘,然后再将其从buffer pool中移除。
加载新页: 将磁盘上的page 15读取到刚刚释放出来的内存空间中。
更新lru列表: 将page 15插入到lru链表的头部。
最终lru列表: 可能变成 [page 15, page 7, page 3, page 9, page 2, page 8, page 5, page 1, page 4, page 6] (page 10 已被移除)
总结
到此这篇关于mysql事务和锁的一些概念和理解深入分析的文章就介绍到这了,更多相关mysql事务和锁内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!



发表评论