
 我要评论
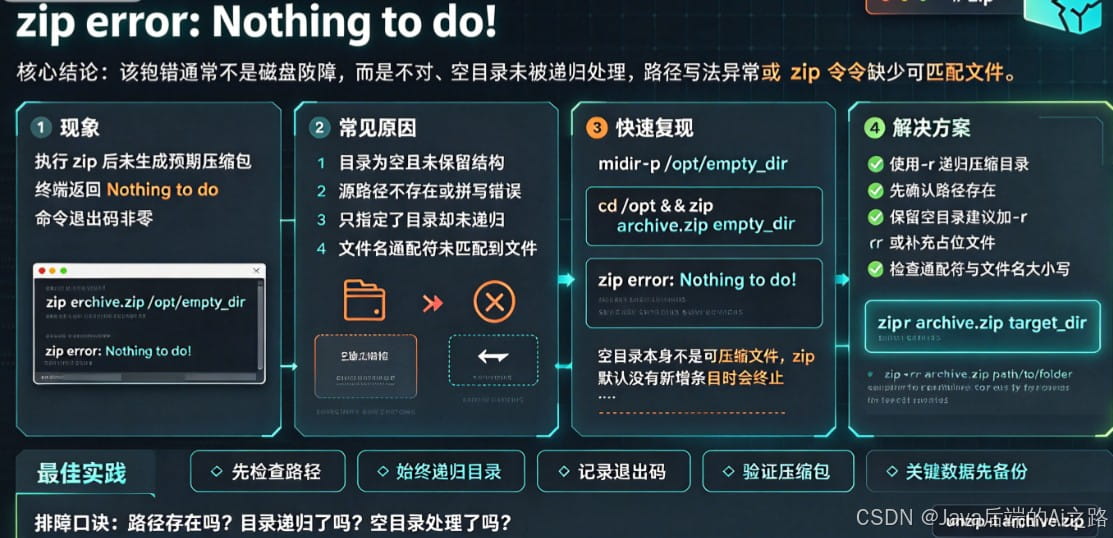
引言:文件打包,运维与开发的必经之路
在当今的软件开发和系统运维领域,linux 操作系统凭借其卓越的稳定性和强大的命令行工具生态,占据着绝对的统治地位。无论是后端开发工程师、算法工程师,还是专职的运维人员,每天都需要与服务器打交道。在这个过程中,文件传输、备份、迁移是高频得不能再高频的操作。
尤其在人工智能大模型爆发的时代,动辄几十 gb 甚至上百 gb 的模型权重文件夹,如何在服务器与本地之间、或者服务器与服务器之间高效流转,成为了每一个技术人必须面对的现实问题。
在大多数场景下,可视化工具(如 mobaxterm、xftp、winscp 等)极大地降低了文件传输的门槛。然而,当面对包含海量小文件或超大体积的文件夹时,直接通过 sftp 拖拽下载往往效率极低,甚至会因为网络波动频繁中断。因此,在服务器端先将文件夹打包成一个单一的归档文件,再进行下载或传输,成为了最标准的操作流程。
然而,就是这样一个看似简单的 zip 命令,如果缺乏对 linux 底层文件系统和命令执行逻辑的理解,极易踩坑。本文将基于一个真实的生产环境踩坑案例,带大家一步步还原报错现场,深度剖析 zip error: nothing to do! 背后的底层逻辑,并提供完整的解决方案以及针对大模型时代的文件传输进阶指南。
第一章:案发还原,一次令人困惑的打包失败经历
为了让文章更具代入感,我们首先还原一下当时的场景。为了满足脱敏要求,我们将具体的用户信息、ip地址和项目文件夹名称进行泛化处理。
1.1 初始环境说明
假设我们有一台远程 linux 服务器(可能是物理机,也可能是云原生环境中的 pod),我们通过 ssh 客户端成功连接。
- 登录用户为:
devuser - 服务器 ip 为:
192.168.1.100 - 当前项目部署路径为:
/home/devuser/projects/var/ai-model-dir/
该路径下存放着一个占据极大磁盘空间的 ai 模型权重文件夹,文件夹名称为:large-model-prof。
1.2 踩坑操作全记录
我们的目标非常明确:将 large-model-prof 这个文件夹压缩成一个名为 large-model-prof.zip 的文件。
由于 mobaxterm 等工具提供了左侧的 sftp 面板和右侧的终端面板,开发者往往习惯于直接在左侧面板双击进入目标文件夹,然后右侧终端会自动同步当前的工作目录。
此时,终端提示符显示如下:[devuser@server large-model-prof]$
这表明,我们当前所处的绝对路径正是 /home/devuser/projects/var/ai-model-dir/large-model-prof,也就是我们想要压缩的那个文件夹内部。
开发者不假思索地在终端输入了第一条命令:
zip -r large-model-prof.zip large-model-prof
预期是系统开始疯狂滚屏压缩,但现实却给了当头一棒。终端输出了如下报错:
zip warning: name not matched: large-model-prof
zip error: nothing to do! (try: zip -r large-model-prof.zip . -i large-model-prof)
开发者有些疑惑,心想可能是相对路径识别有问题。于是,为了确保万无一失,开发者决定使用绝对路径再次尝试,输入了第二条命令:
zip -r /home/devuser/projects/var/ai-model-dir/large-model-prof.zip /home/devuser/projects/var/ai-model-dir/large-model-prof
然而,终端依然冷酷地抛出了同样的错误:
zip warning: name not matched: /home/devuser/projects/var/ai-model-dir/large-model-prof
zip error: nothing to do! (try: zip -r /home/devuser/projects/var/ai-model-dir/large-model-prof.zip . -i /home/devuser/projects/var/ai-model-dir/large-model-prof)
这一刻,疑惑达到了顶点。为什么明明文件夹就在眼前,zip 却提示“name not matched(名称未匹配)”和“nothing to do(无事可做)”?
第二章:抽丝剥茧,深度剖析报错背后的底层逻辑
要真正理解这个报错,我们不能仅仅停留在“怎么解决”的层面,必须深入到 linux 的文件系统机制和 zip 命令的执行原理中去。
2.1 理解当前工作目录(pwd)与相对路径
在 linux 中,任何一个进程在执行时,都有一个“当前工作目录”(present working directory,简称 pwd)。当我们在终端输入命令时,如果没有使用绝对路径(以 / 开头),系统就会基于 pwd 来解析相对路径。
当我们处于 /home/devuser/projects/var/ai-model-dir/large-model-prof 目录下时,执行 zip -r large-model-prof.zip large-model-prof:
zip 命令会首先尝试在当前目录(即 large-model-prof 内部)寻找一个名为 large-model-prof 的子目录或文件。
然而,由于我们当前就在这个目录里面,当前目录下的内容是这个文件夹的内部文件和子文件夹,除非存在“俄罗斯套娃”式的同名嵌套(例如 large-model-prof/large-model-prof/),否则 zip 绝对找不到名为 large-model-prof 的目标。
因此,它诚实地报告了 name not matched。因为找不到目标输入,自然就没有文件需要被压缩,于是顺理成章地抛出了 nothing to do!。
2.2 为什么绝对路径也宣告失败?
这是最违背直觉的地方。既然相对路径找不到,为什么使用了完整的绝对路径 /home/devuser/projects/var/ai-model-dir/large-model-prof 依然失败?
这里涉及两个层面的原因:
第一,路径解析上下文。虽然绝对路径是明确的,但 zip 命令在执行时,依然受到当前工作目录的影响。当你在一个目录内部,试图将包含该目录自身的路径作为参数传给 zip 时,zip 的逻辑会变得复杂。尤其是当压缩包的目标路径 large-model-prof.zip 也位于这个目录内时,会导致一个著名的逻辑悖论:你试图把一个文件夹压缩成一个文件,而这个文件又被存放在这个文件夹内部。 这会导致无限递归的潜在风险。
第二,zip 程序自身的设计机制。zip 在处理绝对路径时,通常会去掉开头的 /,将其转换为相对路径存储。当它发现输入参数是一个绝对路径,而当前工作目录恰好是这个绝对路径的一部分,或者输入路径包含它正在创建的输出文件时,它的内部状态机就会陷入混乱,无法正确收集文件列表,最终只能以 nothing to do! 终止执行。
2.3 解读 zip 给出的神奇提示
仔细看报错信息的后半段,zip 其实非常智能地给出了提示:(try: zip -r large-model-prof.zip . -i large-model-prof)
这里的 . 代表当前目录,-i 参数代表 include(包含),后面跟着一个匹配模式。这个提示的意思是:如果你非要在当前目录下操作,你可以尝试把当前目录(.)作为压缩源,但只包含(include)匹配 large-model-prof 的文件。
但这在实操中非常危险且低效,因为它会强制 zip 去遍历当前目录的所有文件,然后再用过滤器筛选,这在几十 gb 的大目录下是灾难性的性能开销。因此,我们通常不会采用这种提示方案。
第三章:完美解决方案与标准操作指南
理解了问题的本质,解决起来就轻而易举了。解决的核心原则是:脱离目标文件夹,从父目录(或者更高级别的目录)对目标文件夹进行打包操作。
以下是经过生产环境验证的标准操作流程。
3.1 最佳实践:退一步海阔天空
最简单、最安全的做法是先返回上一级目录,然后再执行压缩命令。
在终端依次执行以下命令:
# 1. 返回上一级目录
cd ..

# 2. 确认当前目录,此时你应处于 /home/devuser/projects/var/ai-model-dir/
pwd

# 3. 执行压缩命令
zip -r large-model-prof.zip large-model-prof
命令解析:
cd ..:向上移动一级目录,脱离即将被压缩的文件夹内部。pwd:打印当前工作目录,用于确认自己没有走错地方,这是严谨运维的好习惯。zip -r:-r参数至关重要,表示 recursive(递归),确保压缩文件夹内的所有子目录和文件。large-model-prof.zip:你期望生成的压缩包名称,位于当前目录下。large-model-prof:你要压缩的目标文件夹,作为当前目录的子目录被正确识别。
3.2 替代方案:使用绝对路径在任意位置操作
如果你不想改变当前目录,或者正在编写自动化脚本,最稳妥的方式是明确指定源和目标,并确保源文件夹不被包含在输出路径中。
例如,在一个脚本中,我们可以这样写:
zip -r /home/devuser/projects/var/ai-model-dir/large-model-prof.zip /home/devuser/projects/var/ai-model-dir/large-model-prof
前提是:你当前的终端工作目录绝对不能在 /home/devuser/projects/var/ai-model-dir/large-model-prof 这个路径内。 你可以先 cd /tmp,然后再执行上述绝对路径的命令。
3.3 可视化工具的高效配合
在使用 mobaxterm 或 xftp 这类工具时,最优雅的做法是:
- 在左侧 sftp 面板中,单击选中
large-model-prof文件夹。 - 观察右侧终端的工作目录是否自动跳转到了该文件夹内。如果跳转了,在终端输入
cd ..。 - 在终端执行
zip -r large-model-prof.zip large-model-prof。 - 刷新左侧面板,右键生成的
zip文件选择 download。
第四章:大模型时代的进阶思考,zip 真的是最优解吗?
掌握了命令行的报错修复只是基本功。作为技术人,我们需要进一步思考技术选型的合理性。尤其在面对当前动辄几十 gb 的 ai 大模型文件夹时,zip 可能并不总是最优解。
4.1 归档与压缩的本质区别
在 linux 生态中,我们需要区分两个概念:
- 归档(archiving):将多个文件打包成一个单一的文件,不改变文件大小,如
tar。 - 压缩(compression):利用算法(如 gzip, bzip2, xz, zstd)减小文件体积,如
gzip、pigz。 zip则是将归档和压缩合二为一的工具。
对于普通的文本、代码,zip 或 tar.gz 能带来显著的体积缩减。但是,对于 ai 大模型的权重文件(通常是 .safetensors、.bin、.pt 格式),这些文件本身已经是经过高度优化和量化(如 fp16、int8)的二进制数据,信息熵极高,几乎不存在冗余空间。使用 zip 去压缩这些文件,压缩率往往不到 5%,甚至可能因为压缩算法的开销导致时间成本极大,而空间收益微乎其微。
4.2 针对大文件的压缩策略:放弃压缩,拥抱纯归档
在处理大模型文件夹时,如果你只是为了传输,强烈建议放弃压缩,只进行归档,或者直接传输。
方案一:使用 tar 打包(不压缩)。
tar -cvf large-model-prof.tar large-model-prof
不压缩的打包速度极快,几乎等同于磁盘 i/o 速度。
方案二:使用多线程压缩工具 pigz。
如果你确实需要压缩(比如包含大量日志文件),传统的 gzip 是单线程的,速度极慢。建议使用 pigz(parallel implementation of gzip),它能利用多核 cpu 的优势。
tar -cvf - large-model-prof | pigz -p 16 > large-model-prof.tar.gz
这条命令将打包和压缩结合,-p 16 指定了 16 个 cpu 核心参与压缩,效率成倍提升。
4.3 多卷压缩的应急预案
如果你打包后的文件超过了 sftp 工具的下载大小限制,或者网络极不稳定,可以考虑分卷压缩。
zip -r -s 2g large-model-prof.zip large-model-prof
-s 参数指定分卷大小,这里设定为 2gb,系统会自动生成 large-model-prof.z01、large-model-prof.z02 等文件。下载后需要合并解压。
4.4 磁盘空间与 cpu 资源的生死存亡预警
在很多云原生 kubernetes 集群或虚拟机中,系统盘(如 / 或 /var/lib)的空间是有限的。
当你执行 zip 命令时,源文件夹多大,生成的 zip 文件就会占据几乎同等大小的磁盘空间。如果在压缩过程中,当前目录所在挂载点的磁盘空间耗尽(disk full),不仅压缩会中断,甚至可能导致正在运行的服务(如模型推理服务)崩溃,日志无法写入。
因此,执行压缩前,务必使用 df -h 检查当前目录的剩余空间。建议剩余空间至少是目标文件夹体积的 1.5 倍。
第五章:linux 文件操作核心 faq 与避坑指南
为了让大家在未来的开发运维中少走弯路,这里总结了与本文场景高度相关的常见疑难解答。
5.1 报错 -bash: zip: command not found 怎么解决?
很多精简版 linux 镜像(如 alpine、docker 基础镜像,或未经初始化的云服务器)默认不安装 zip。
解决方式取决于发行版:
ubuntu/debian:
sudo apt-get update
sudo apt-get install zip unzip
centos/rhel/fedora:
sudo yum install zip unzip
sealos 等容器化环境:如果宿主机没有,可以尝试在容器内安装,或使用宿主机提供的工具。
5.2 压缩过程中 ssh 断开怎么办?
压缩几十 gb 的模型文件可能需要几分钟到几十分钟。如果此时你的笔记本合盖、网络波动导致 ssh 断开,终端会发送 sighup 信号,压缩进程会随之被杀死,前功尽弃。
解决方案:使用 nohup 或 screen/tmux 挂载后台运行。
nohup zip -r large-model-prof.zip large-model-prof > zip.log 2>&1 &
执行后,即便 ssh 断开,压缩仍在后台进行。你可以通过 jobs 或 tail -f zip.log 查看进度。或者使用 tmux,断开后重新连接,无缝恢复工作区。
5.3 如何验证压缩包的完整性?
在下载到本地或者传输到另一台服务器后,强烈建议进行校验,防止网络传输导致文件损坏。
在源服务器计算校验值:
md5sum large-model-prof.zip
# 或者
sha256sum large-model-prof.zip
在目标机器上对比生成的哈希值。如果一致,说明文件完整无损。
5.4 为什么 sftp 拖拽下载比命令行压缩更好?
在部分场景下,这确实是事实。如果文件夹内是几十万个几 kb 的小文件(比如 nlp 模型的词表、配置文件等),打包成一个 zip 能够极大地提升传输效率,因为避免了反复建立 tcp 连接的开销。
但如果是一个完整的几十 gb 的单一权重文件(如 model.bin),直接通过支持断点续传的工具(如 rsync、scp 或高级 sftp 客户端)拖拽,可能是更无脑、更节省服务器 cpu 的方案。
总结:细节决定成败,原理照亮前路
回顾这次踩坑经历,一个看似简单的“压缩文件夹”需求,背后折射出的是对 linux 工作目录、相对路径与绝对路径、以及命令执行上下文机制的掌握程度。
zip error: nothing to do! 并不可怕,它只是系统在善意地提醒我们:“你站在了不该站的地方,试图做一件逻辑上矛盾的事情。”
作为技术人员,我们的成长路径不应仅仅停留在“遇到报错查搜索引擎,复制粘贴命令解决”的阶段。如果我们能够多问一句“为什么要先 cd ..?”、“为什么大模型文件不适合用 zip?”、“如果在后台跑中断了怎么办?”,我们的知识体系就会从一个个孤立的点,连结成一张坚固的网。
在 ai 时代,数据量只会越来越大,文件操作只会越来越频繁。掌握扎实的 linux 基础,熟练运用各种归档与传输工具,并具备强烈的资源风险意识,是每一个开发者走向高级工程师的必修课。
希望这篇五千字的长文,不仅能帮你解决眼前的 zip 报错,更能为你的 linux 运维之路扫清一片障碍。技术在演进,但底层的逻辑永远闪闪发光。
以上就是linux压缩文件夹报错"zip error: nothing to do!"的原因排查与解决的详细内容,更多关于linux压缩文件夹报错的资料请关注代码网其它相关文章!






发表评论